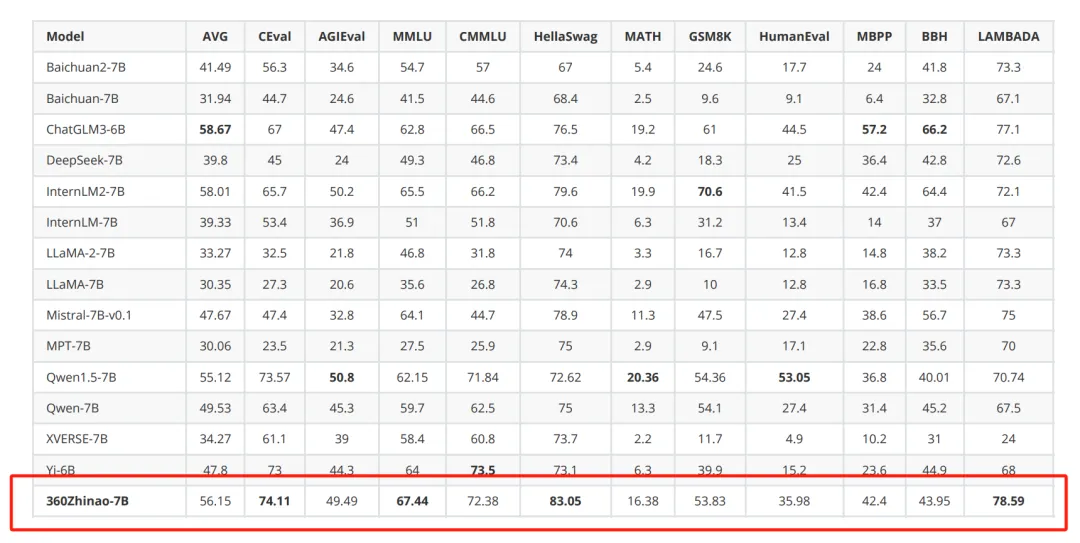
智慧与“长文本”并存,360 开源最长模型,吊打“弱智吧”!
智慧与“长文本”并存,360 开源最长模型,吊打“弱智吧”!继之前公开课之后(周鸿祎:2024 年 AI 产业发展的 16 个趋势。)红衣大叔兑现诺言,开源了 7B 系列大模型
来自主题: AI技术研报
10910 点击 2024-04-17 18:03

 搜索
继之前公开课之后(周鸿祎:2024 年 AI 产业发展的 16 个趋势。)红衣大叔兑现诺言,开源了 7B 系列大模型
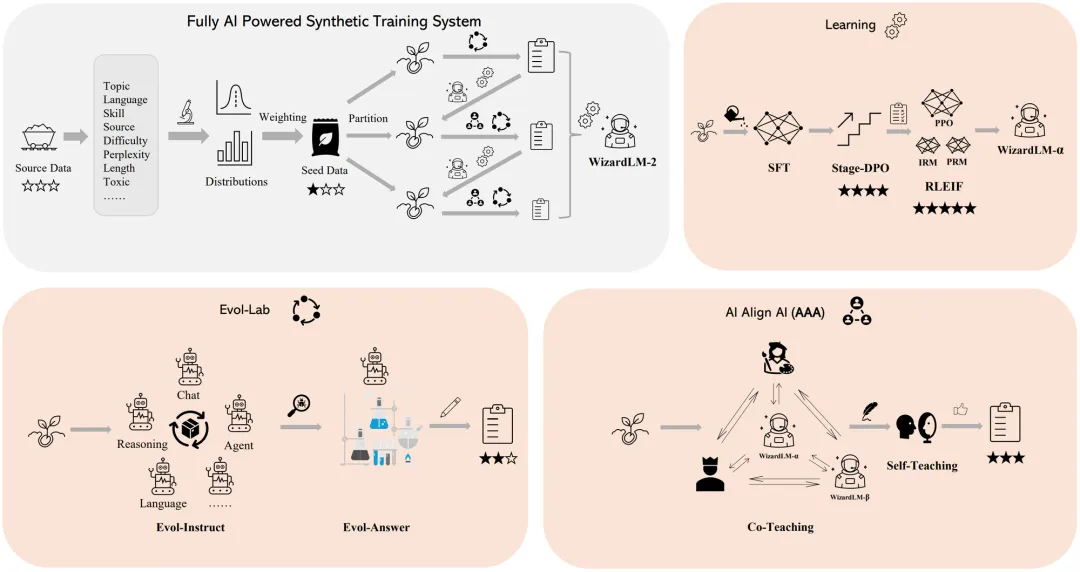
Microsoft 在今天推出了 WizardLM 2,这是一个突破性的开源大语言模型,可以说是开源领域的突破,甚至接近和超过部分 GPT-4 的能力,这在之前的开源领域是前所未有的。
纵观生成式AI领域中的两个主导者:自回归和扩散模型。 一个专攻文本等离散数据,一个长于图像等连续数据。 如果,我们让后者来挑战前者的主场,它能行吗?
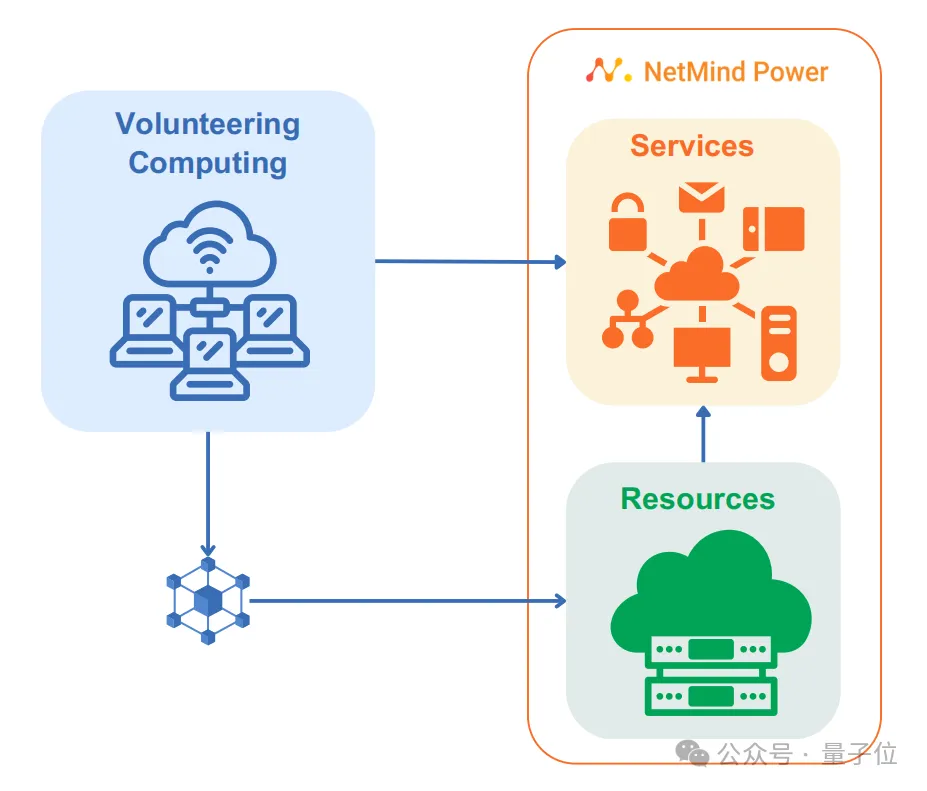
最近,一则数据点出了AI领域算力需求的惊人增长—— 根据业内专家的预估,OpenAI推出的Sora在训练环节大约需要在4200-10500张NVIDIA H100上训练1个月,并且当模型生成到推理环节以后,计算成本还将迅速超过训练环节。

在当前,娱乐内容平台争相抢占用户的闲暇时间,竞逐着注意力的控制权。然而,在工作场景中,却是完全相反的逻辑:即,谁可以帮助用户节省时间,避免被无故频繁打扰,谁就可以迅速占领用户心智,拿下自己的城头阵地。

人类嗅觉的数字化,它来了! 当今的计算机算法,尤其是AI技术,几乎已经把人类的视觉和听觉完全虚拟化了。

刚刚,由李飞飞联合领导的斯坦福大学以人为本人工智能研究所(Stanford HAI)发布了《2024 年人工智能指数报告》(Artificial Intelligence Index Report 2024)。
OpenAI,去日本建办事处了。 而且,他们还发布了一个专门针对日语微调的GPT-4模型……
还没等OpenAI公开Sora,却等来了Adobe官宣。 一早,Adobe官方称,Sora、Gen-2、Pika等一系列生成式AI工具将在PremierePro推出。

北大90后创立独角兽公司,带着“微观世界版的Sora”来了