突破一亿Token极限:EverMind提出MSA架构,实现大模型高效端到端长时记忆
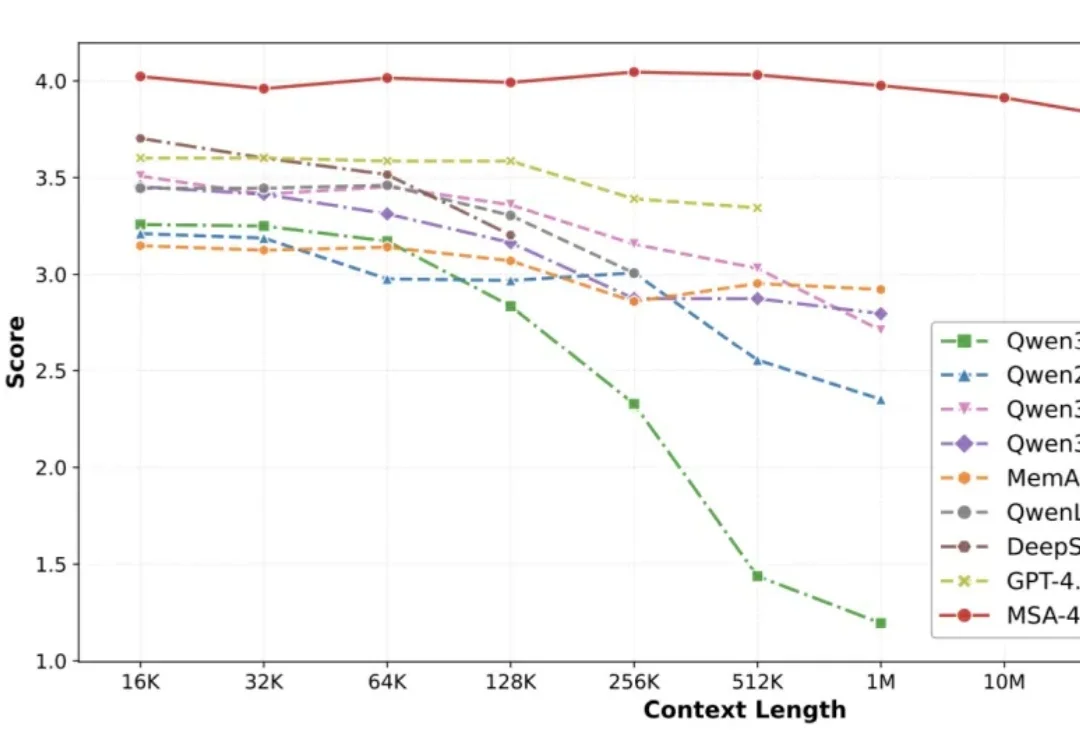
突破一亿Token极限:EverMind提出MSA架构,实现大模型高效端到端长时记忆人的智能能力主要由推理能力和长期记忆能力构成。近年来,大模型的推理能力一直处于快速发展过程,但大模型的长期记忆能力一直受限于上下文长度,无法取得突破。在历史上,曾经有多种路线进行尝试,但都无法突破扩展性(Scalability)、精度(Precision)和效率(Efficiency)的不可能三角。
搜索
人的智能能力主要由推理能力和长期记忆能力构成。近年来,大模型的推理能力一直处于快速发展过程,但大模型的长期记忆能力一直受限于上下文长度,无法取得突破。在历史上,曾经有多种路线进行尝试,但都无法突破扩展性(Scalability)、精度(Precision)和效率(Efficiency)的不可能三角。
MLRA通过拆分KV缓存为四个并行分支,显著降低显存占用并实现4路张量并行。推理速度比MLA最高快2.8倍,支持百万级上下文,且模型质量更优。无需牺牲性能,即可高效扩展长文本处理能力。
谷歌DeepMind刚刚为Gemini API放了一个大招:内置工具和自定义函数终于可以在同一次调用里混着用了。再加上跨工具的「上下文环流」和Google Maps原生接入,Agent开发的编排噩梦正在终结。
OpenAI 发起全新挑战:你,准备好迎战了吗?
上周,除了 OpenClaw,AI 圈还有个词越来越火🔥。
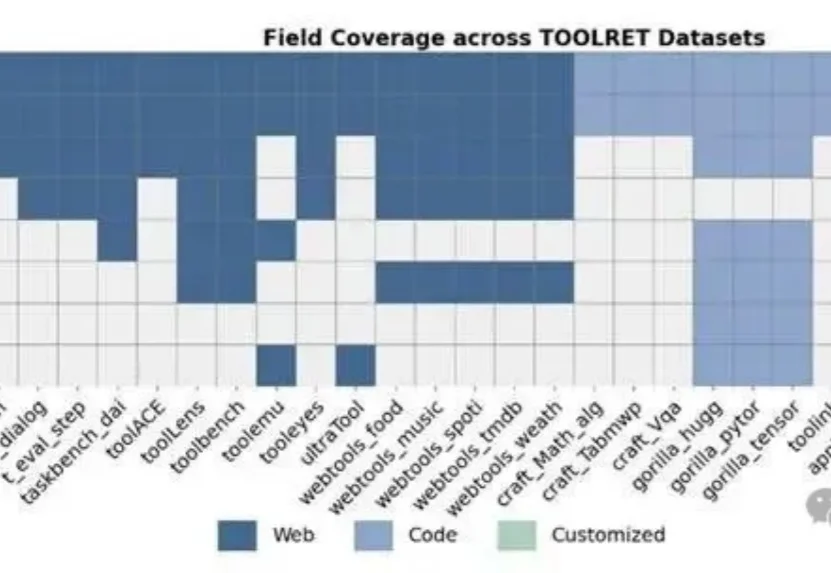
在大模型时代,Tool-Use已经成为智能体能力的核心组成部分。
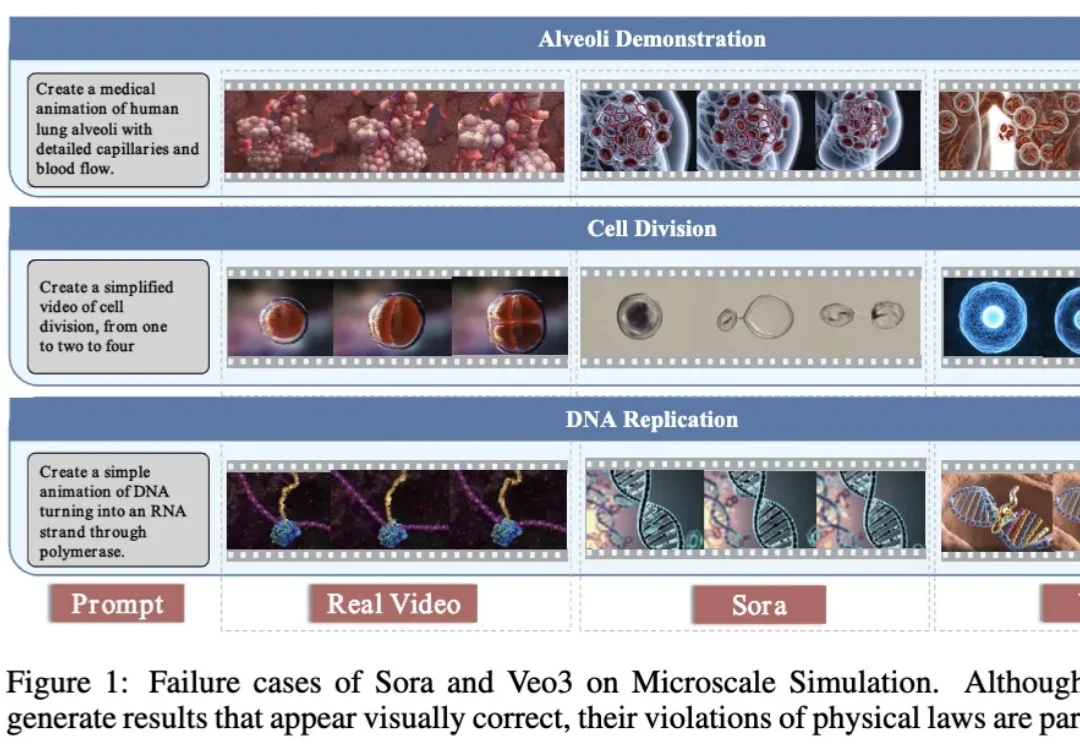
过去两年,世界模型(World Model)正在成为大模型演进的重要方向。
来自天工AI的SkyReels-V4,没打招呼,直接登顶Artificial Analysis文转视频(含音频)全球榜,超越Veo 3.1、Sora 2。一个月前,其Preview版本才刚拿下该榜全球第2。
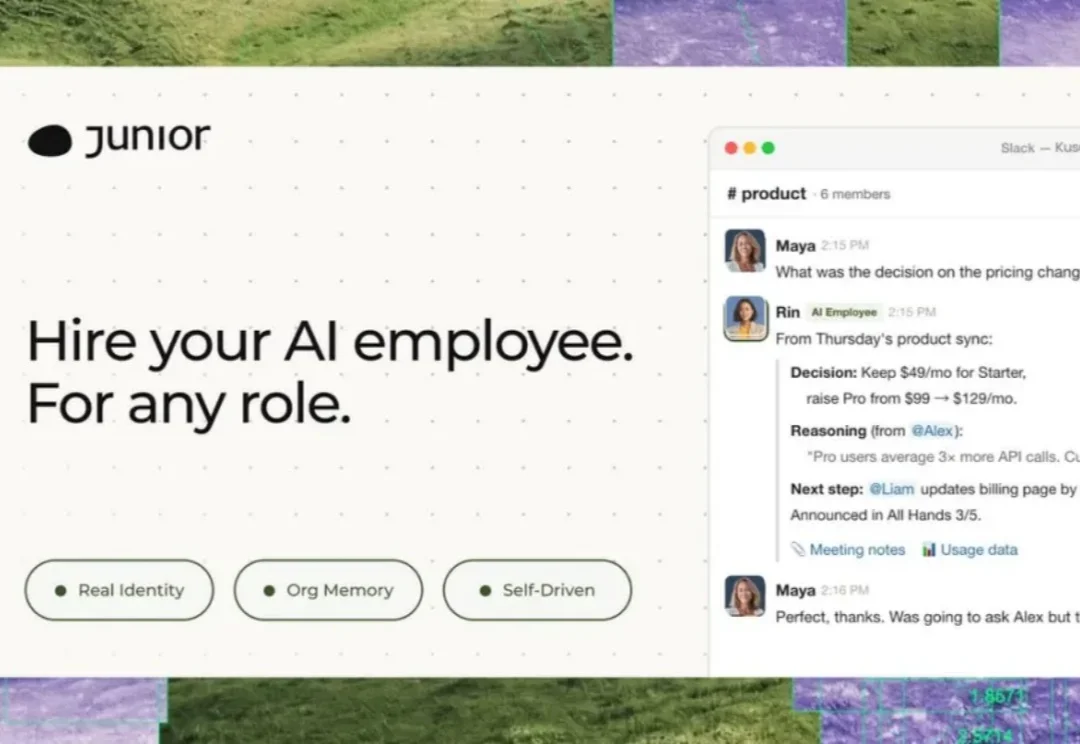
我们需要的是一个 AI 工具,还是一个 AI 同事?
占领OpenRouter调用量榜单第一的神秘模型Hunter Alpha,终于揭开神秘面纱—— 既不是GPT,也不是DeepSeek,而是来自小米的万亿旗舰模型MiMo-V2-Pro。