AI资讯新闻榜单内容搜索-o

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: o
中移动九天团队MultiPL-MoE:全新Hybrid-MoE架构用于增强通用大模型低资源代码能力

中移动九天团队MultiPL-MoE:全新Hybrid-MoE架构用于增强通用大模型低资源代码能力

中移动九天团队MultiPL-MoE:全新Hybrid-MoE架构用于增强通用大模型低资源代码能力

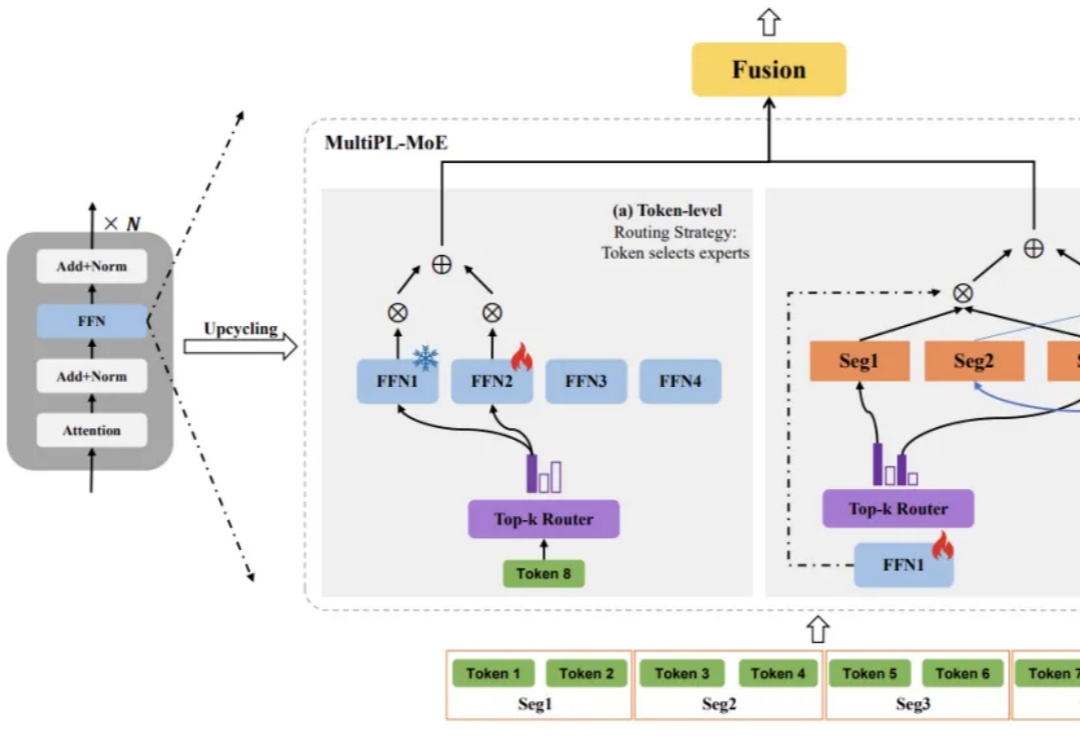
大语言模型(LLM)虽已展现出卓越的代码生成潜力,却依然面临着一道艰巨的挑战:如何在有限的计算资源约束下,同步提升对多种编程语言的理解与生成能力,同时不损害其在主流语言上的性能?

来自主题: AI技术研报
10193 点击    2025-10-30 16:23
全球首个「不带脑子」的住家机器人开卖,售价14万!

全球首个「不带脑子」的住家机器人开卖,售价14万!

全球首个「不带脑子」的住家机器人开卖,售价14万!

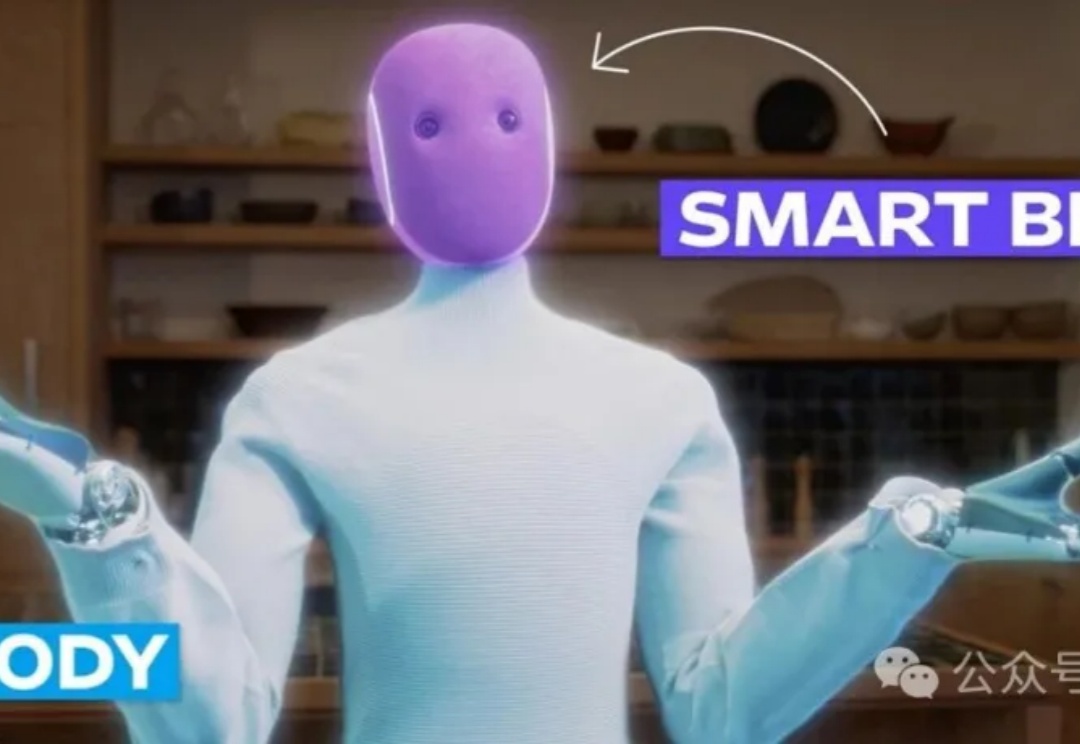
当机器人也开始找人代班,当一个人类操作一个机器人「入侵」你的生活,你会允许吗?
来自主题: AI资讯
8942 点击    2025-10-30 15:22
老黄亲自站台,英伟达编程神器!Cursor 2.0自研模型狂飙4倍

老黄亲自站台,英伟达编程神器!Cursor 2.0自研模型狂飙4倍

老黄亲自站台,英伟达编程神器!Cursor 2.0自研模型狂飙4倍

这次不仅发布自研编码模型Composer,还重构了IDE交互逻辑,可以最多8个智能体同时跑,早期测试和开发者都说Cursor 2.0真的太快了。Composer的速度是同等模型的4倍。Cursor说这是一款专门为低延迟智能编码打造的模型,大部分任务都可以在30秒以内完成。
来自主题: AI资讯
10607 点击    2025-10-30 13:49
当阿里入局全球 AI Coding,战场里的 60 天 | 对话叔同:Qoder 创始人

当阿里入局全球 AI Coding,战场里的 60 天 | 对话叔同:Qoder 创始人

当阿里入局全球 AI Coding,战场里的 60 天 | 对话叔同:Qoder 创始人

“很正确,无比正确” 当我们问起阿里巴巴 Qoder[1] (Agentic Coding 产品)创始人叔同,关于他带领团队冲入全球 AI Coding 这片“红海” 60 天后的感受时,他给出了这样简单而坚定的回答。他的底气,源自一份优秀的成绩单:上线 5 天用户迅速突破 10 万,仅 60 天斩获 50 万开发者用户。
来自主题: AI资讯
10425 点击    2025-10-30 12:40
对话微软AI CEO:当AI越来越像人,我选择踩刹车

对话微软AI CEO:当AI越来越像人,我选择踩刹车

对话微软AI CEO:当AI越来越像人,我选择踩刹车

微软 AI 首席执行官穆斯塔法·苏莱曼(Mustafa Suleyman)正试图走一条微妙的路线。
来自主题: AI资讯
10207 点击    2025-10-30 11:35
代码自己改自己?我用1000万DeepSeek跑通了赫胥黎-歌德尔机HGM(附避坑指南)

代码自己改自己?我用1000万DeepSeek跑通了赫胥黎-歌德尔机HGM(附避坑指南)

代码自己改自己?我用1000万DeepSeek跑通了赫胥黎-歌德尔机HGM(附避坑指南)

读者,您好!今天想跟您聊一个硬核又极具启发性的项目——HGM(Huxley-Gödel Machine)。我刚刚一起花了几个小时,从环境配置的坑,一路“打怪升级”到让它最终跑完,相信您可能已经从别的公众号上看到了这篇文章。
来自主题: AI技术研报
10003 点击    2025-10-30 11:24
高效训练新标杆!华人团队开源原生VLM-NEO,以少数据追平顶级模型

高效训练新标杆!华人团队开源原生VLM-NEO,以少数据追平顶级模型

高效训练新标杆!华人团队开源原生VLM-NEO,以少数据追平顶级模型

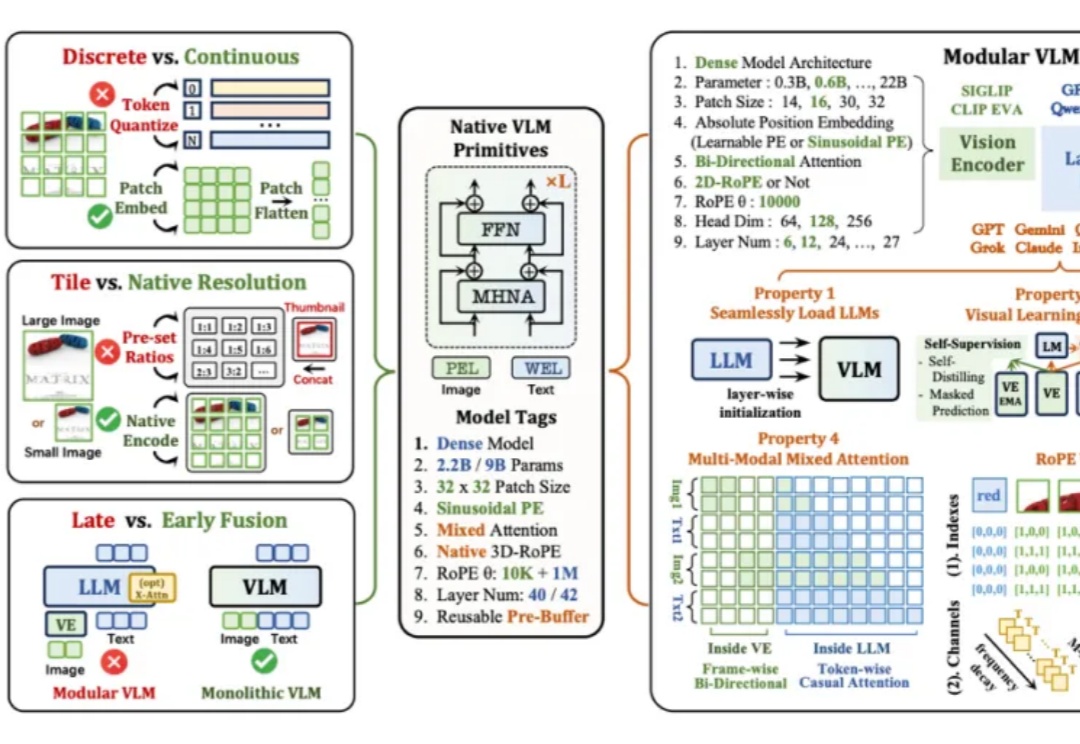
当下主流的视觉语言模型(Vision-Language Models, VLM),通常都采用这样一种设计思路:将预训练的视觉编码器与大语言模型通过投影层拼接起来。这种模块化架构成就了当前 VLM 的辉煌,但也带来了一系列新的问题——多阶段训练复杂、组件间语义对齐成本高,不同模块的扩展规律难以协调。
来自主题: AI技术研报
9298 点击    2025-10-30 10:55
牛津VGG、港大、上交发布ELIP:超越CLIP等,多模态图片检索的增强视觉语言大模型预训练

牛津VGG、港大、上交发布ELIP:超越CLIP等,多模态图片检索的增强视觉语言大模型预训练

牛津VGG、港大、上交发布ELIP:超越CLIP等,多模态图片检索的增强视觉语言大模型预训练

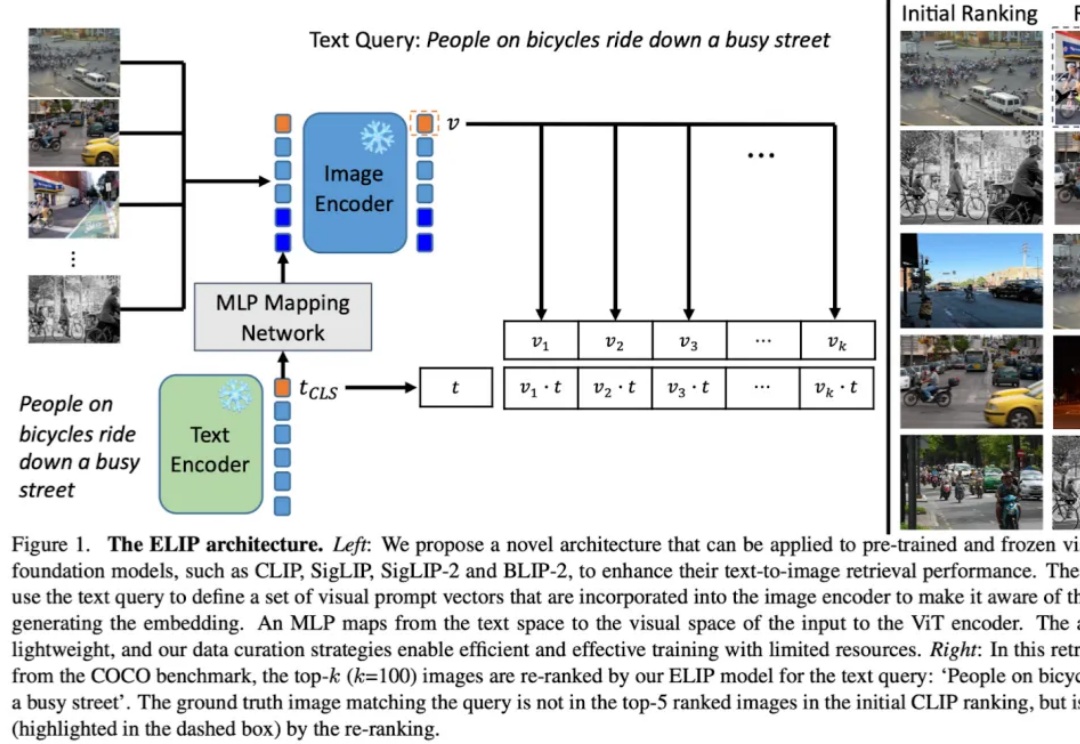
多模态图片检索是计算机视觉和多模态机器学习领域很重要的一个任务。现在大家做多模态图片检索一般会用 CLIP/SigLIP 这种视觉语言大模型,因为他们经过了大规模的预训练,所以 zero-shot 的能力比较强。
来自主题: AI技术研报
8237 点击    2025-10-30 10:42
单条演示即可抓取一切:北大团队突破通用抓取,适配所有灵巧手本体

单条演示即可抓取一切:北大团队突破通用抓取,适配所有灵巧手本体

单条演示即可抓取一切:北大团队突破通用抓取,适配所有灵巧手本体

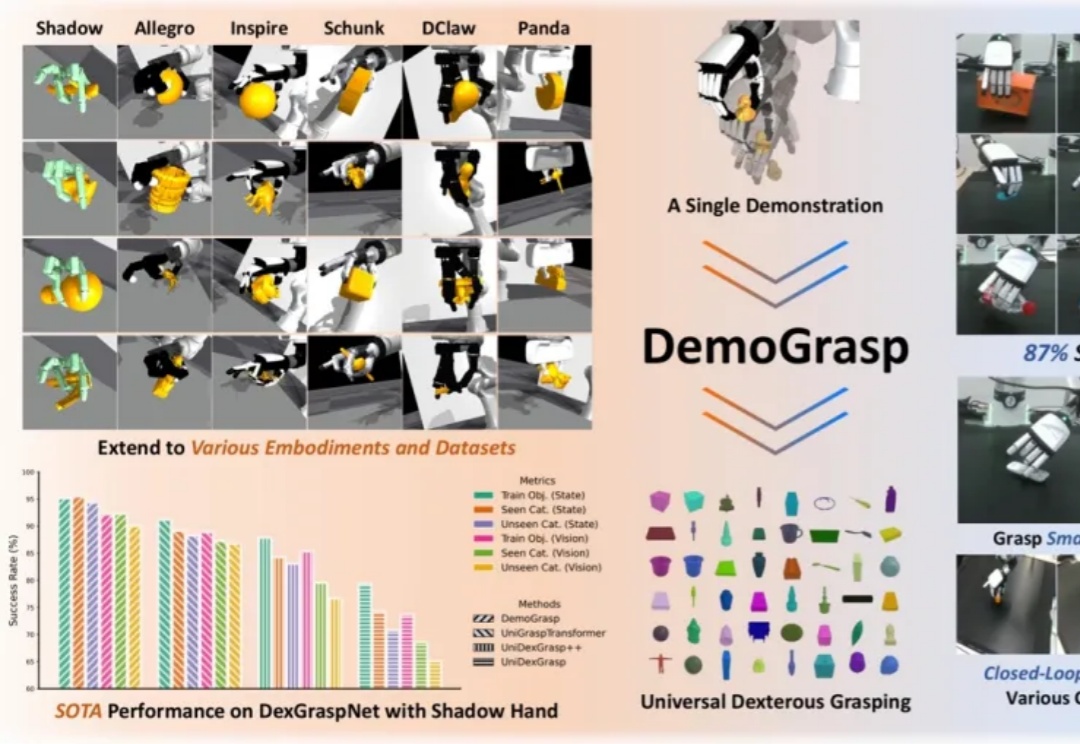
在灵巧手通用抓取的研究中,由于动作空间维度高、任务具有长程探索特征且涉及多样化物体,传统强化学习(RL)面临探索效率低、奖励函数及训练过程设计复杂等挑战。
来自主题: AI技术研报
7608 点击    2025-10-30 10:26
AI医学公司「零假设」获近亿元A轮融资,打造中国版OpenEvidence

AI医学公司「零假设」获近亿元A轮融资,打造中国版OpenEvidence

AI医学公司「零假设」获近亿元A轮融资,打造中国版OpenEvidence

AI医学生产力工具开发公司「零假设」近日获近亿元A轮融资,由荷塘创投、国方创新、上海喆驭投资,老股东元禾原点超额认购。本轮融资主要用于打磨、落地场景化AI医学智能体,构建连通药企和医生的学术沟通桥梁。唯快资本长期担任独家融资顾问。

来自主题: AI资讯
9821 点击    2025-10-30 09:29