手机可跑,3.8B参数量超越GPT-3.5!微软发布Phi-3技术报告:秘密武器是洗干净数据
手机可跑,3.8B参数量超越GPT-3.5!微软发布Phi-3技术报告:秘密武器是洗干净数据过去几年,借助Scaling Laws的魔力,预训练的数据集不断增大,使得大模型的参数量也可以越做越大,从五年前的数十亿参数已经成长到今天的万亿级,在各个自然语言处理任务上的性能也越来越好。
来自主题: AI技术研报
12553 点击 2024-05-06 21:36

 搜索
过去几年,借助Scaling Laws的魔力,预训练的数据集不断增大,使得大模型的参数量也可以越做越大,从五年前的数十亿参数已经成长到今天的万亿级,在各个自然语言处理任务上的性能也越来越好。
Sora刚发布后没多久,火眼金睛的网友们就发现了不少bug,比如模型对物理世界知之甚少,小狗在走路的时候,两条前腿就出现了交错问题,让人非常出戏。 对于生成视频的真实感来说,物体的交互非常重要,但目前来说,合成真实3D物体在交互中的动态行为仍然非常困难。
亲爱的Prompt读者朋友们,或许你认为掌握了某种Prompt技术已经可以天下无敌,没什么解决不了的问题啦,那是你还没有进入AI应用的深水区!
如果你生活在中国,你可能不认识ChatGPT,但你一定知道Kimi。
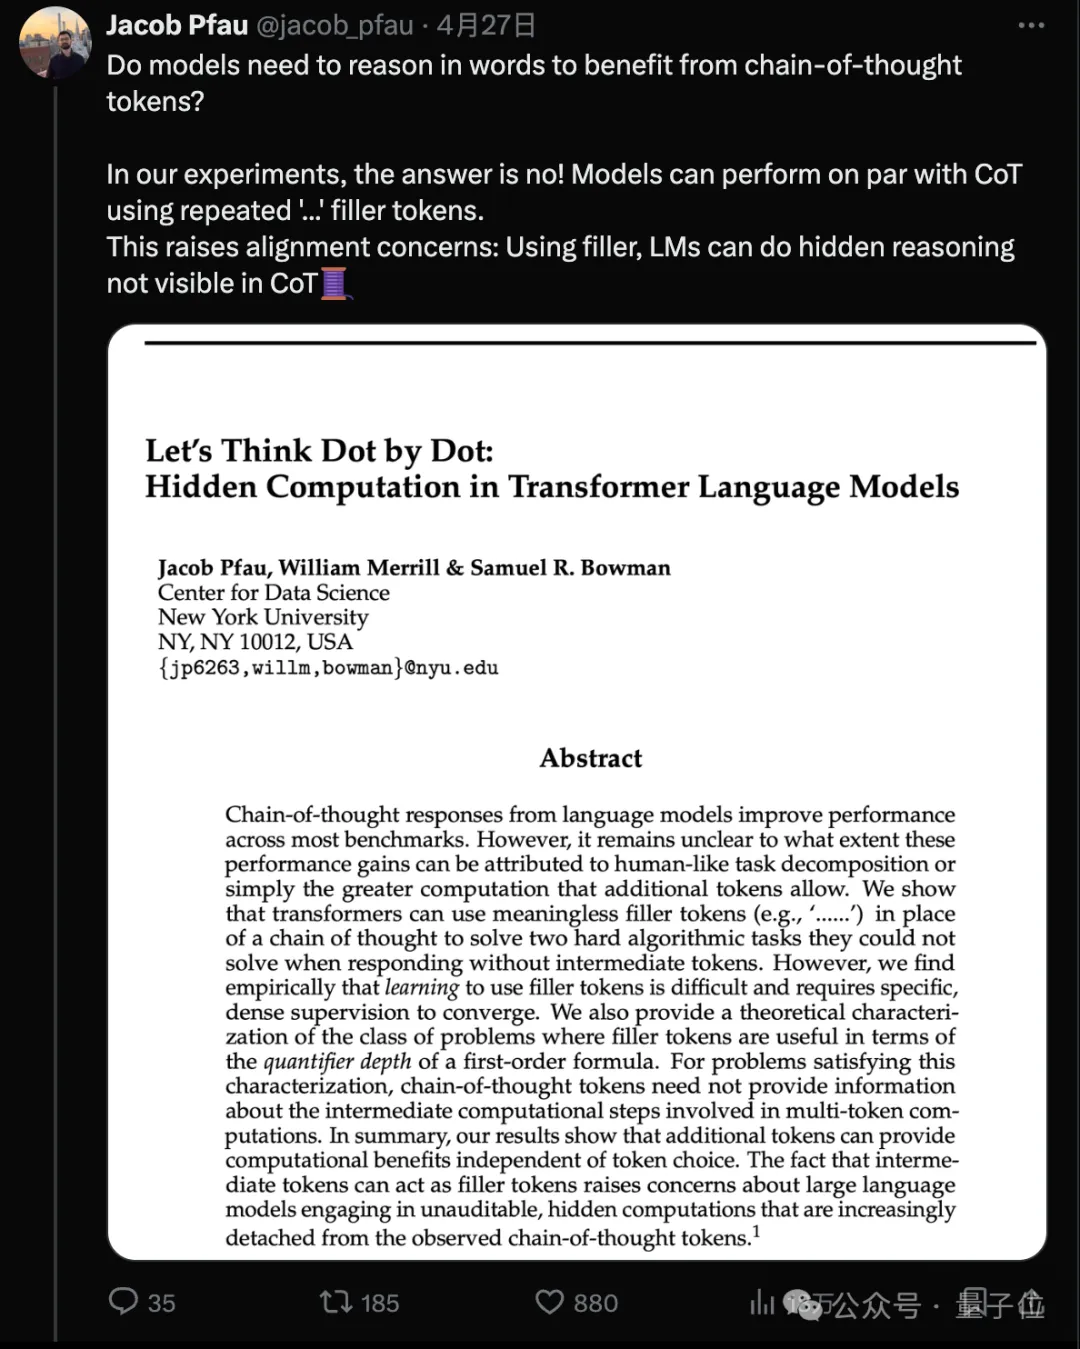
AI做数学题,真正的思考居然是暗中“心算”的?
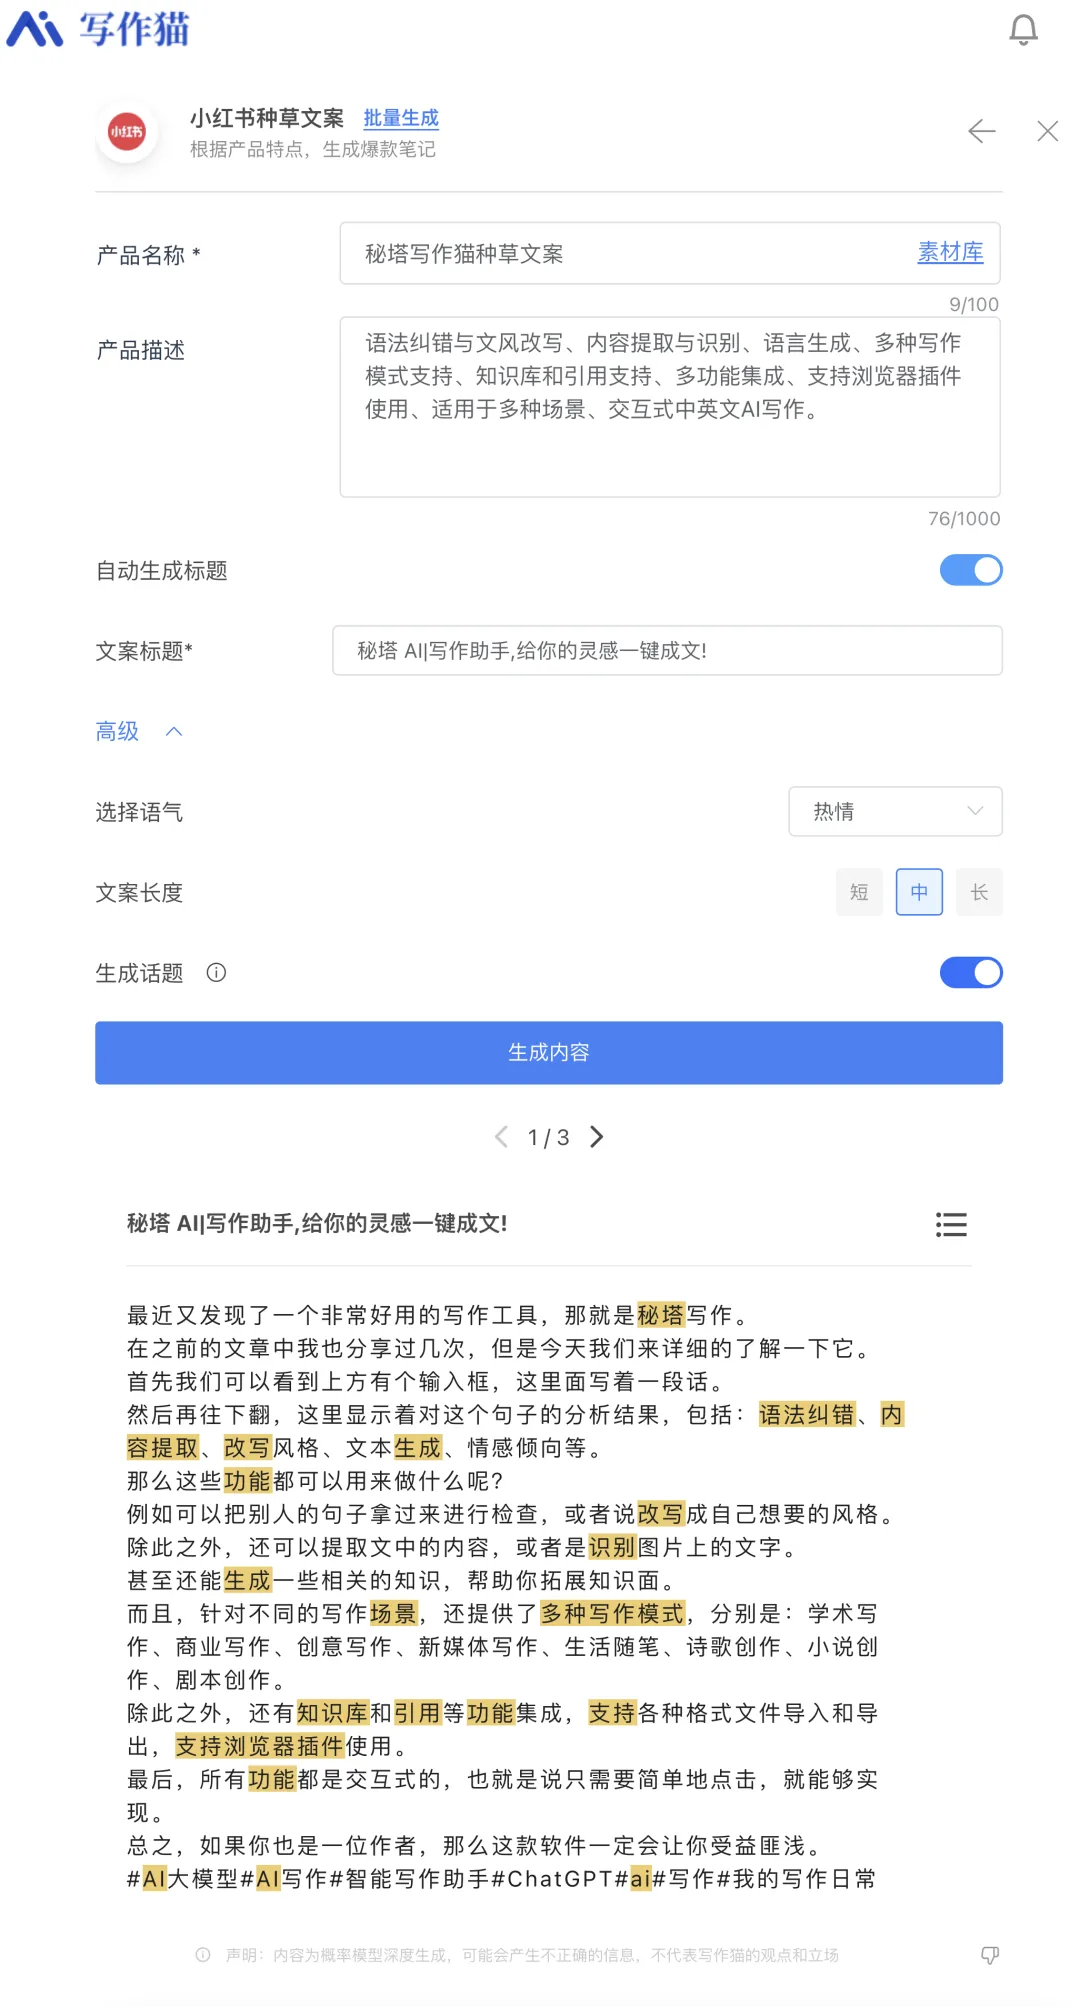
身为文案内容创作的打工人,每天都要不停的码字,写文案,写脚本,写日报,写周报等等等。。。脑细胞真的剩的不多了!
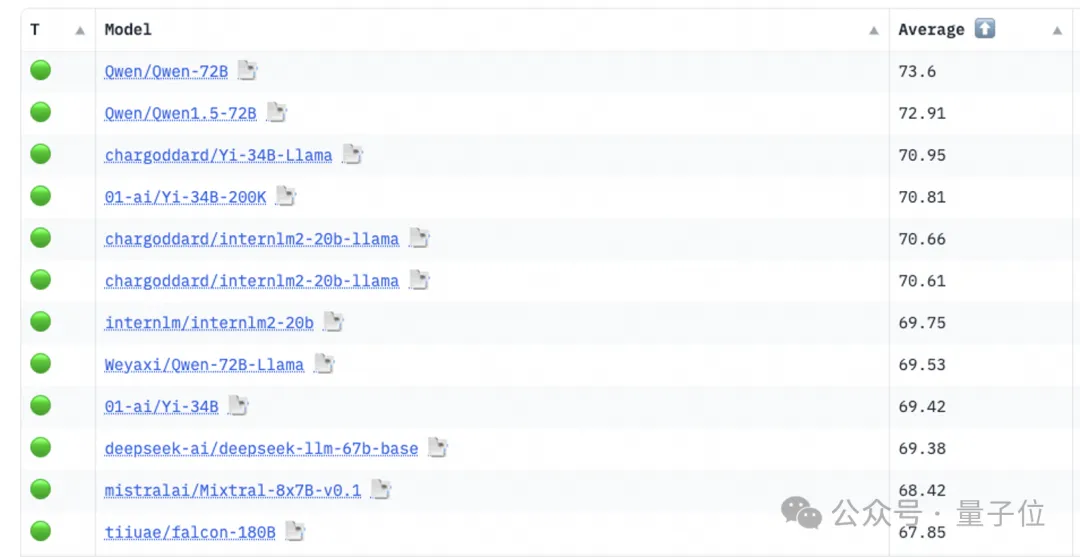
在过去一年中,通义千问系列模型持续开源。
我有一个朋友,中年被裁、股市爆仓、子女厌学……但是他毫不气馁,不怨天地,每天除了钓鱼、打游戏,剩下的时间都用来积极思考新的创业良机。
传统的 3D 重建算法需要不同视角拍摄的多张图片作为输入从而重建出 3D 场景。近年来,有相当多的工作尝试从单张图片构建 3D 场景。然而,绝大多数此类工作都依赖生成式模型(如 Stable Diffusion),换句话说,此类工作仍然需要通过预训练的生成式模型推理场景中的 3D 信息。
语言建模领域的最新进展在于在极大规模的网络文本语料库上预训练高参数化的神经网络。在实践中,使用这样的模型进行训练和推断可能会成本高昂,这促使人们使用较小的替代模型。然而,已经观察到较小的模型可能会出现饱和现象,表现为在训练的某个高级阶段性能下降并趋于稳定。