AI资讯新闻榜单内容搜索-多模态

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 多模态
告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。

来自主题: AI技术研报
8532 点击    2026-11-02 10:33
独家|蚂蚁领投矩侨工业亿元融资,柔性触觉切入构建Physical AI全模态人类数据感知底座

独家|蚂蚁领投矩侨工业亿元融资,柔性触觉切入构建Physical AI全模态人类数据感知底座

独家|蚂蚁领投矩侨工业亿元融资,柔性触觉切入构建Physical AI全模态人类数据感知底座

Z Potential独家获悉,柔性织物触觉传感企业矩侨工业近日完成亿元A轮融资,由蚂蚁集团领投,老股东零以创投、威海港融及青岛和信跟投,多维资本担任长期独家财务顾问。本轮资金将主要用于织物电子皮肤规模化量产与交付、触觉及多模态感知技术研发,以及机器人、智能家居和医疗康养等场景的产品拓展。

来自主题: AI资讯
9259 点击    2026-10-30 10:32
NeurIPS 2026 Oral|让大模型精准「看图」:NV-CoT用连续坐标重构视觉思维链

NeurIPS 2026 Oral|让大模型精准「看图」:NV-CoT用连续坐标重构视觉思维链

NeurIPS 2026 Oral|让大模型精准「看图」:NV-CoT用连续坐标重构视觉思维链

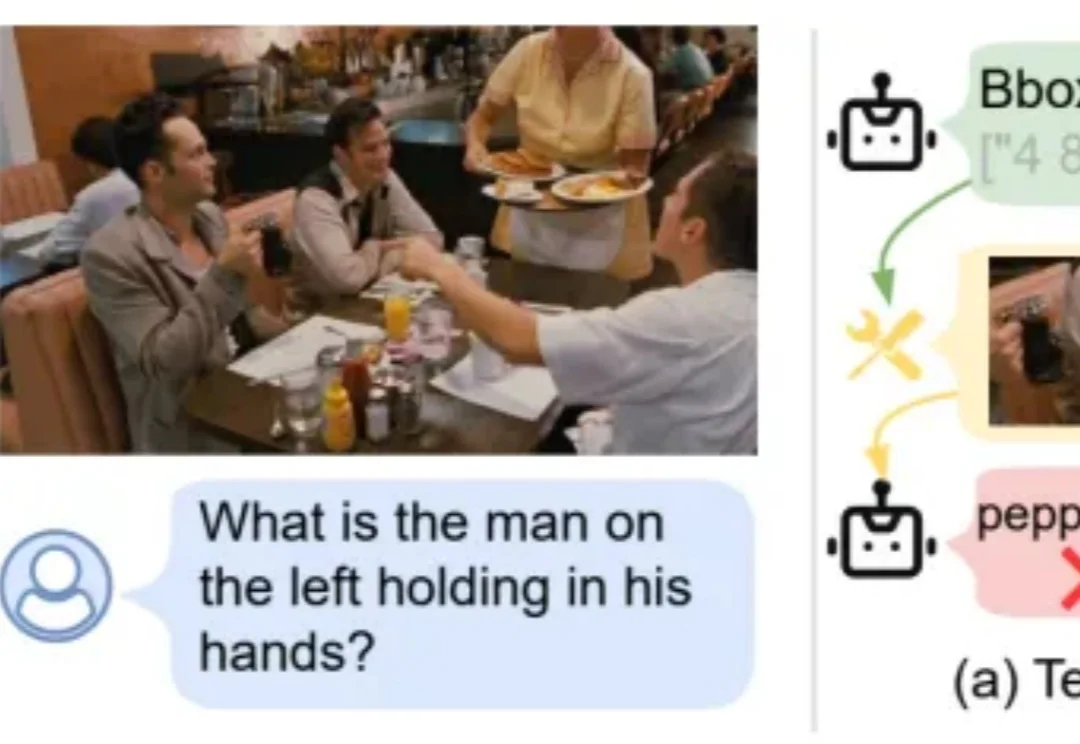
一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?

来自主题: AI技术研报
6526 点击    2026-10-29 11:09
EMNLP'26|GPT也不会「读空气」,狼人杀基准测出社交盲区

EMNLP'26|GPT也不会「读空气」,狼人杀基准测出社交盲区

EMNLP'26|GPT也不会「读空气」,狼人杀基准测出社交盲区

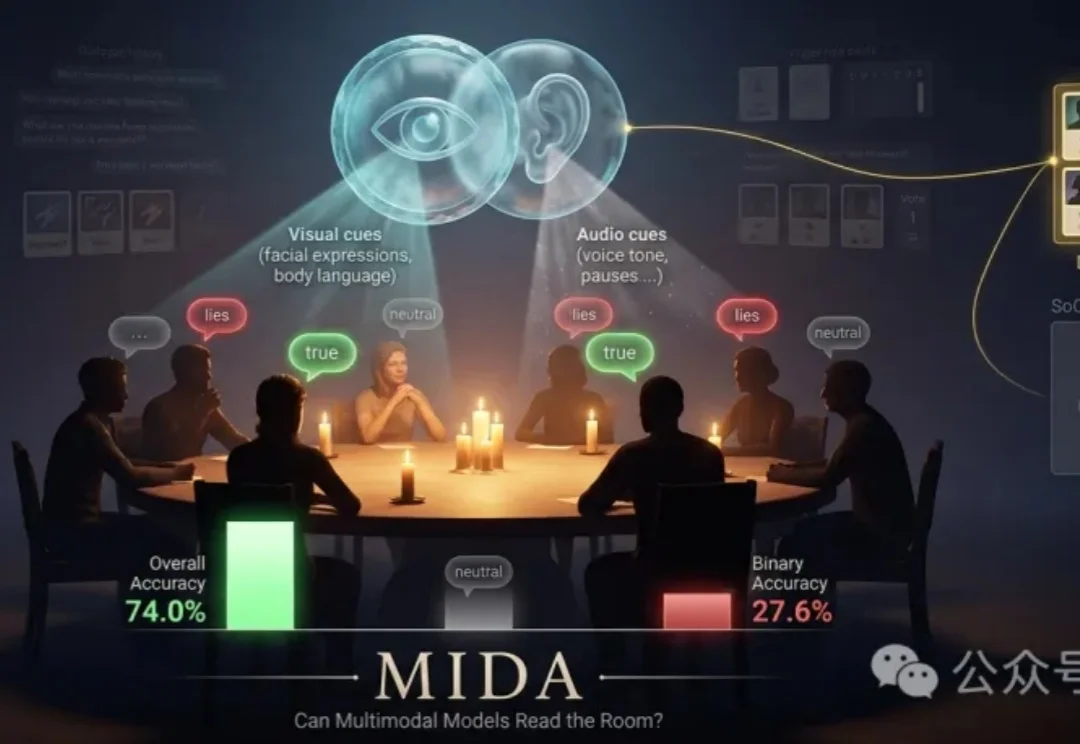
人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?

来自主题: AI技术研报
8425 点击    2026-10-29 11:09
独家|Soul将推出Loxinity,为自研语音、视觉与多模态交互产品

独家|Soul将推出Loxinity,为自研语音、视觉与多模态交互产品

独家|Soul将推出Loxinity,为自研语音、视觉与多模态交互产品

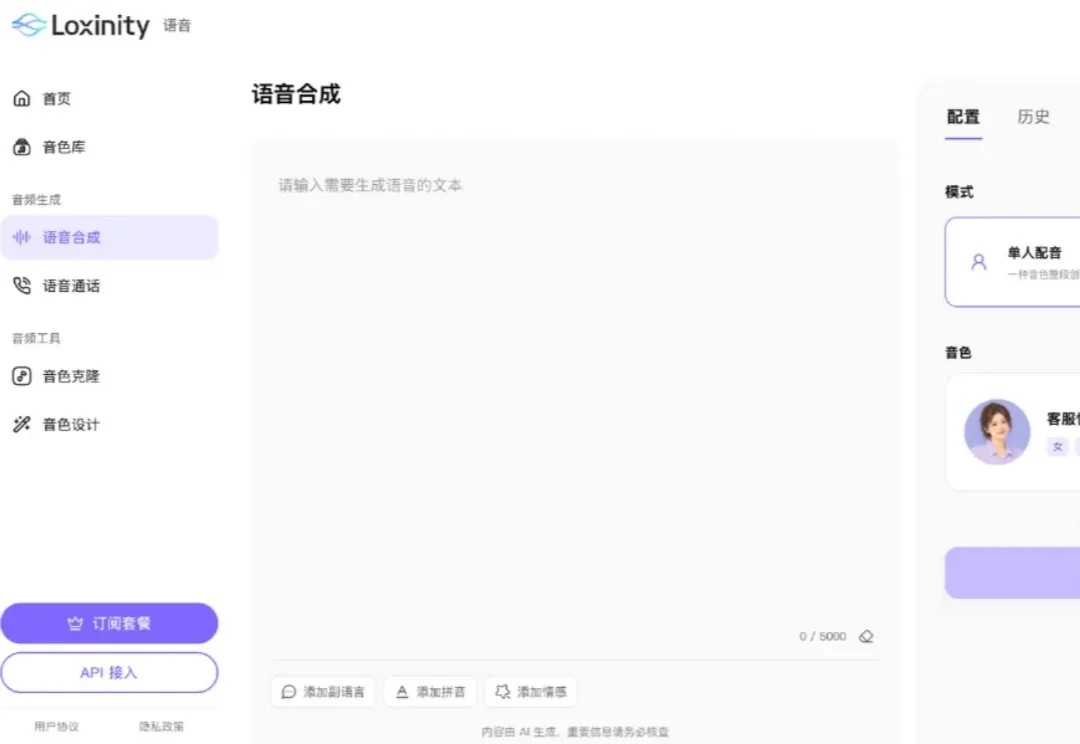
《读佳》独家获知,Soul将推出专为交互场景打造、超具活人感的语音合成产品“Loxinity(洛希无限)”,和市面上面向配音、短视频的TTS不同,这套模型从底层瞄准实时交互场景,主打强活人感。它支持单人配音、多人对话两种模式,配套音色克隆、音色设计等工具,还开放API接入。Loxinity下辖语音合成模型Loxi Speech和视频生成模型Loxi Avatar。

来自主题: AI资讯
7753 点击    2026-10-27 14:31
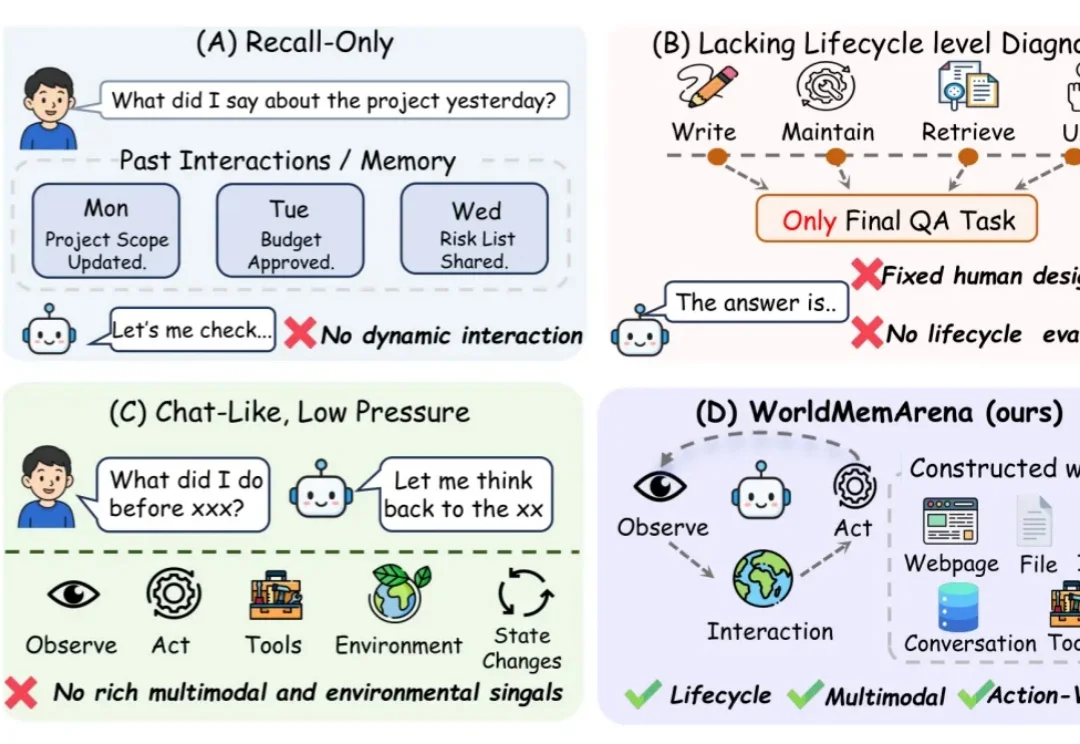
从记忆到行动,还有多远?WorldMemArena把多模态记忆放进真实交互

从记忆到行动,还有多远?WorldMemArena把多模态记忆放进真实交互

从记忆到行动,还有多远?WorldMemArena把多模态记忆放进真实交互

团队盯住的是一个很实际的问题:Agent 明明保存了项目计划,预算更新后却仍按旧版本行动;看过环境截图,下一步又忽略了画面里已改变的状态。它究竟是没记下来、没及时更新,还是找到了证据却没用上?

来自主题: AI技术研报
8241 点击    2026-10-21 10:12
新基准开测「AI第六感」!人类一眼秒懂,最强模型只拿53.6分

新基准开测「AI第六感」!人类一眼秒懂,最强模型只拿53.6分

新基准开测「AI第六感」!人类一眼秒懂,最强模型只拿53.6分

Scale AI与Elorian发布Humanity’s Sixth Sense(HSS)基准,以522道图像和视频题测试多模态模型的直觉式视觉推理,25个模型均显著落后于人类,榜首GPT-6-astra得分53.6%,人类达93.1%。

来自主题: AI资讯
8792 点击    2026-10-18 13:02
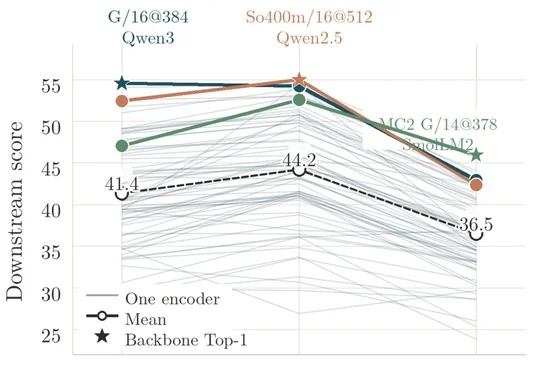
给多模态大模型选「眼睛」,两个简单改进让评测相关性接近翻倍

给多模态大模型选「眼睛」,两个简单改进让评测相关性接近翻倍

给多模态大模型选「眼睛」,两个简单改进让评测相关性接近翻倍

团队提出免训练评测方法RAVEL,通过带稳定项的PCA白化和局部图像块匹配提升视觉编码器评测准确性,在三个LLM上的平均Spearman相关系数达0.85,并开源210个MLLM权重。

来自主题: AI技术研报
9979 点击    2026-10-18 13:02