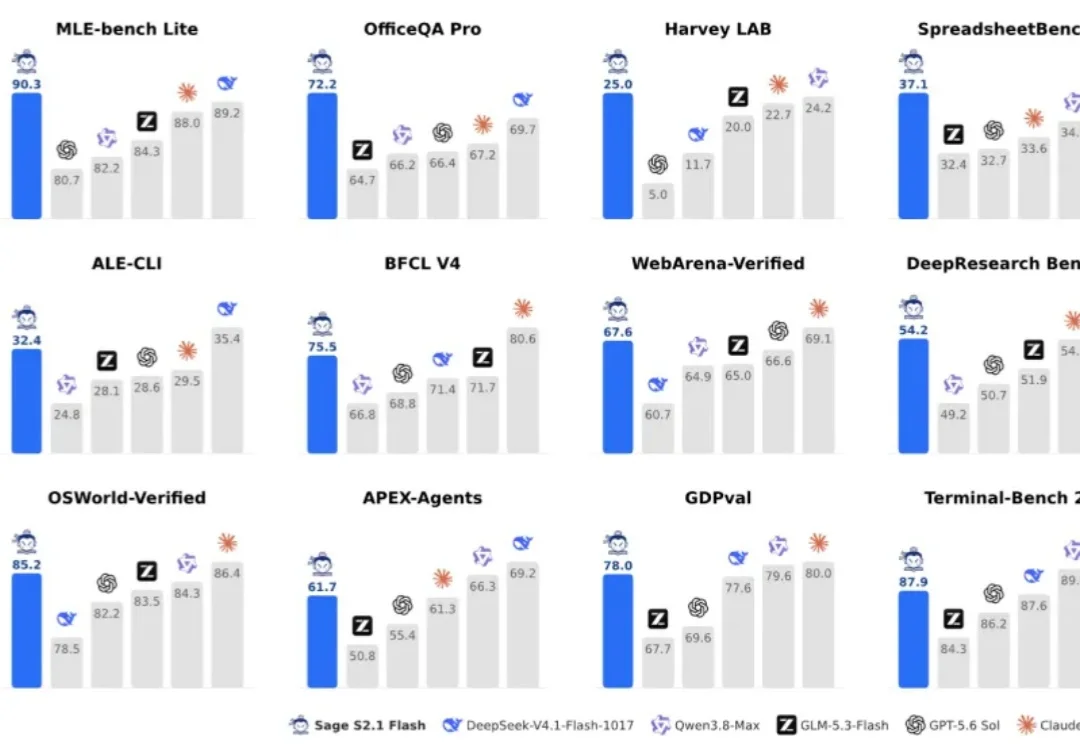
让AI成为自主进化的科学家!书生-S2.1 Flash登顶机器学习工程基准
让AI成为自主进化的科学家!书生-S2.1 Flash登顶机器学习工程基准让 AI 成为 AI 研发的助手,书生-S2.1 Flash 正在展现 AI4AI 的潜力。近日,这款科学多模态大模型正式发布并开源,在机器学习工程基准中取得 90.3 分,展现出 AI 参与机器学习研发任务的能力。
来自主题: AI技术研报
5521 点击 2026-11-17 10:27

 搜索
让 AI 成为 AI 研发的助手,书生-S2.1 Flash 正在展现 AI4AI 的潜力。近日,这款科学多模态大模型正式发布并开源,在机器学习工程基准中取得 90.3 分,展现出 AI 参与机器学习研发任务的能力。
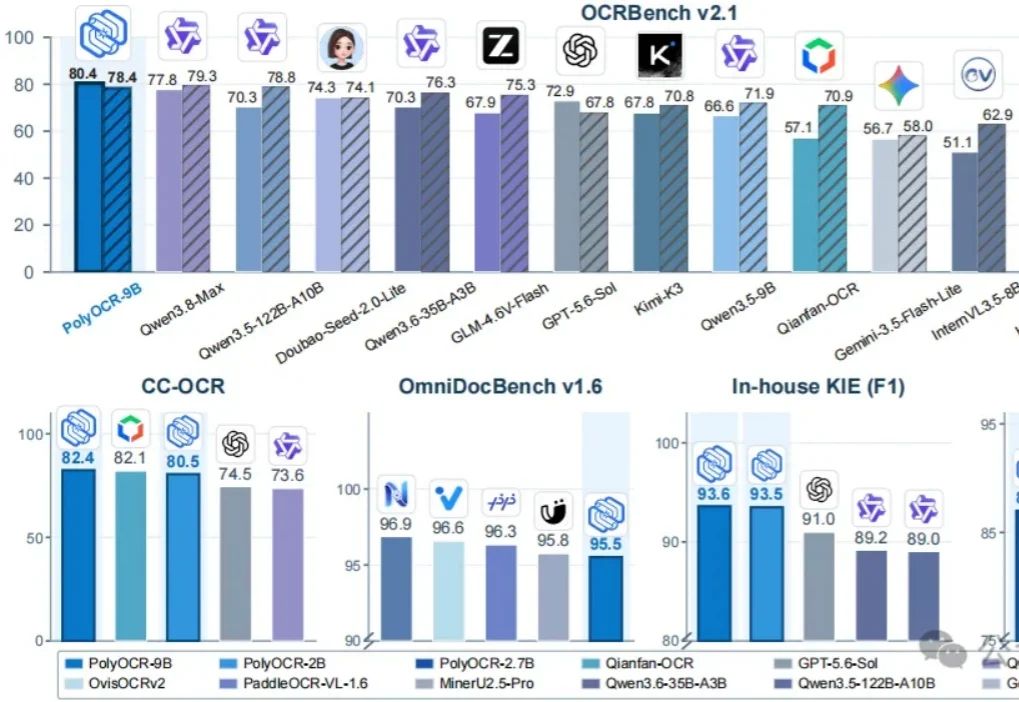
随着多模态大模型越来越强,OCR的短板反而逐渐明显。
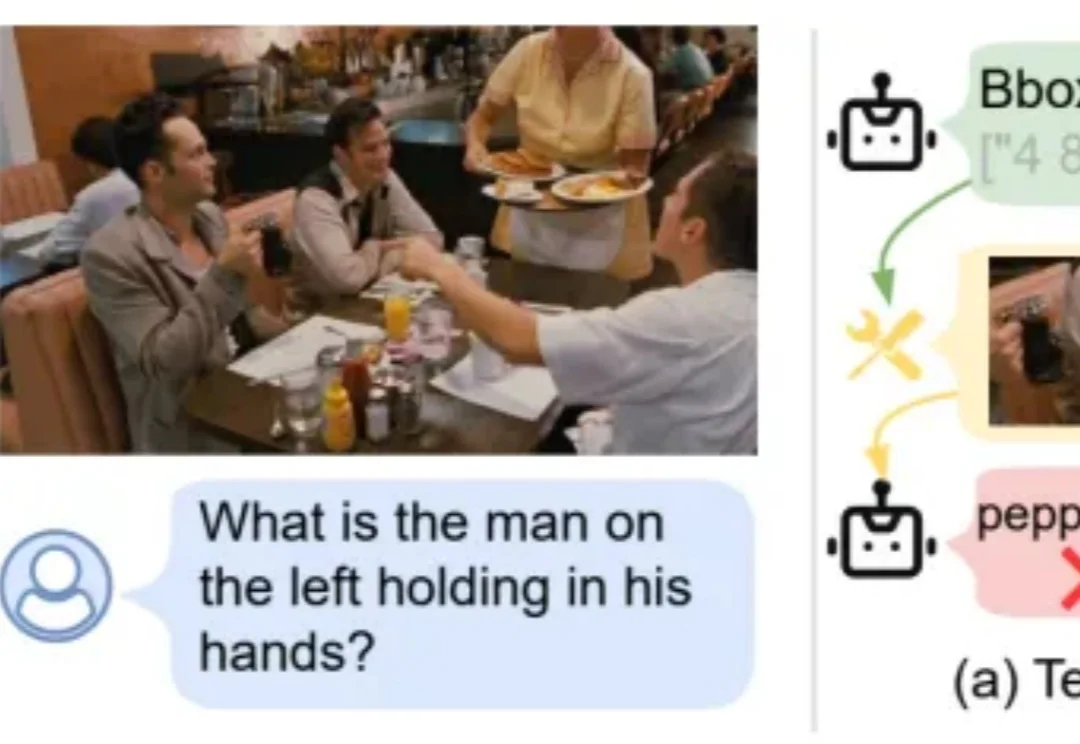
一张高清照片中,远处的手提包是什么颜色?一页票据里,某项费用到底是多少?面对这些问题,多模态大模型常常需要先找到相关区域,再放大查看。但如果第一步就框错了位置,后面的推理也可能跟着出错。视觉思维链让模型能够边看边想、调用工具寻找证据。不过,许多方法仍然像生成句子一样,把边界框坐标逐个写成文本 token。连续的空间位置,为什么要通过离散文字来表达?
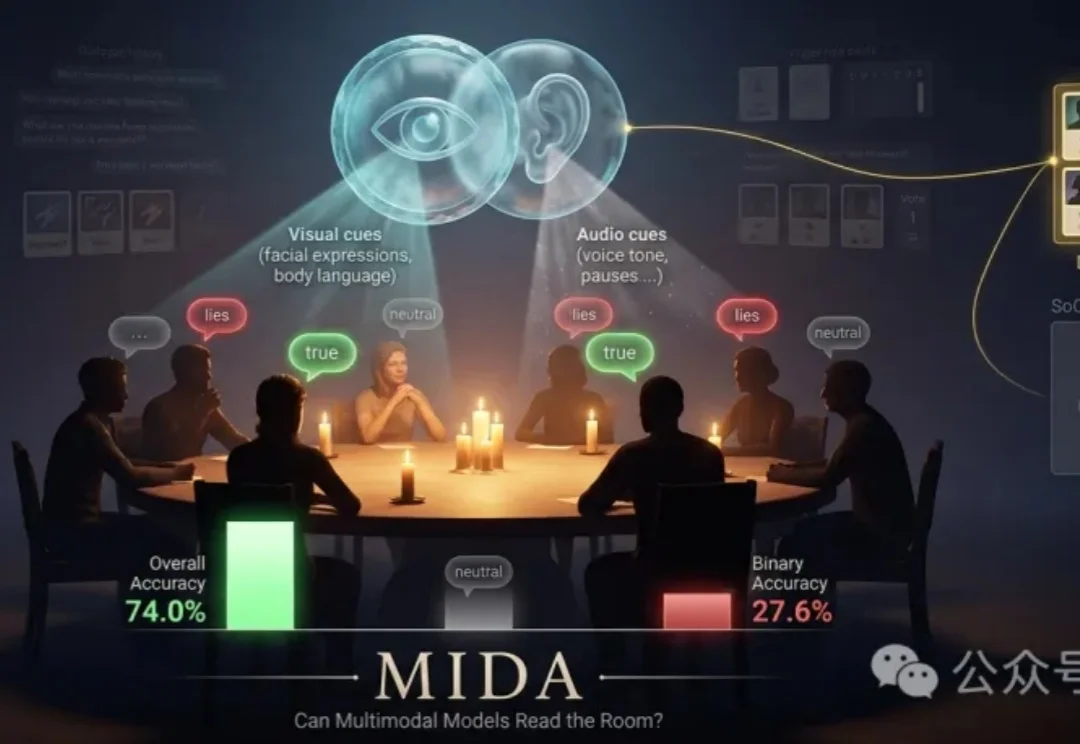
人类说一句「我不是狼」,多模态大模型既能看到表情,也能听见声音。但它真的知道这句话是真是假吗?
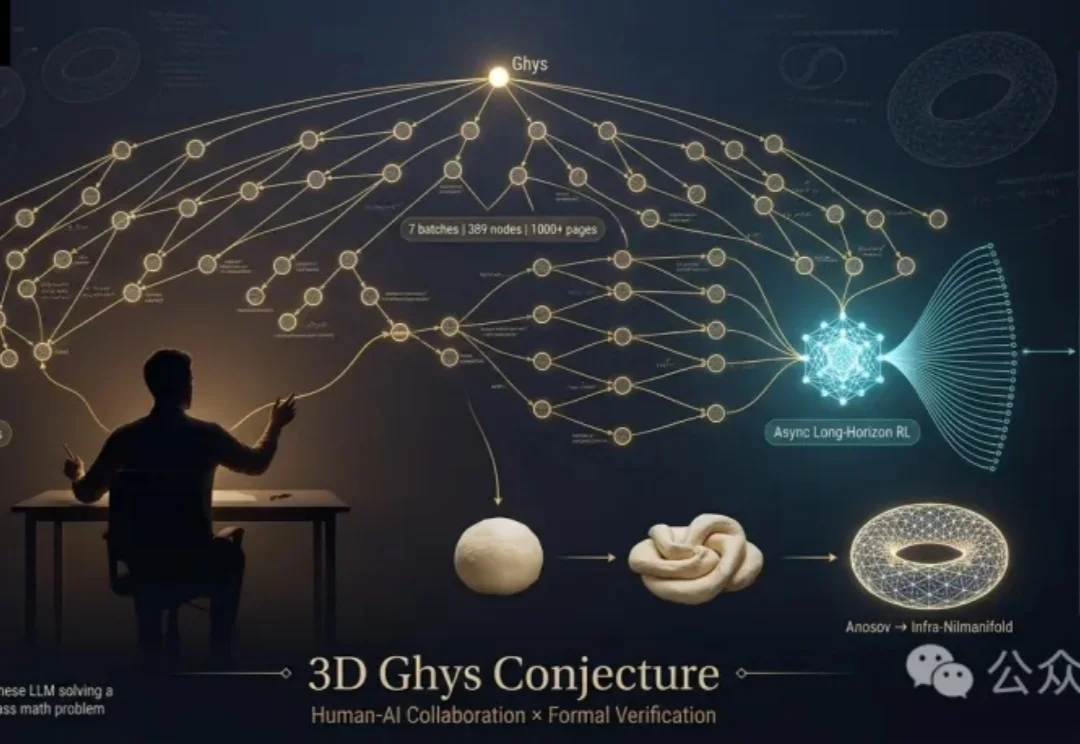
困扰数学界30余年的世界级难题——三维Ghys猜想迎来了破解!
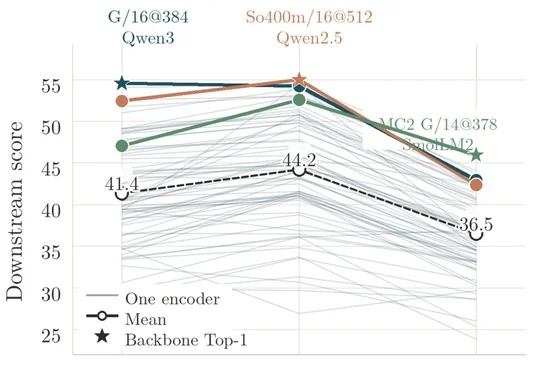
团队提出免训练评测方法RAVEL,通过带稳定项的PCA白化和局部图像块匹配提升视觉编码器评测准确性,在三个LLM上的平均Spearman相关系数达0.85,并开源210个MLLM权重。
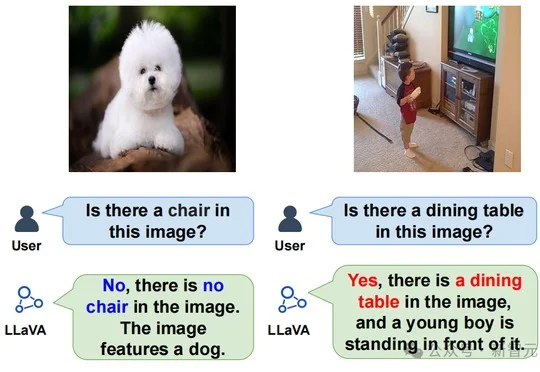
新智元报道 多模态大模型的物体幻觉,长期被归因于语言先验。 先看下面两组对话。 第一组,一张只有小狗的照片,问模型「图中有椅子吗」,它答「没有,图中是一只狗」,完全正确; 第二组,另一张照片,问「图中
豆包爱学2.0依托豆包多模态大模型与Seedance系列模型,将AI嵌入语数英等学科的问答、板书讲解、定制课程、听写和错题整理等学习全流程,同一对话入口即可围绕知识点不断生成完整学习内容,展现字节在AI教育场景的工程化能力。
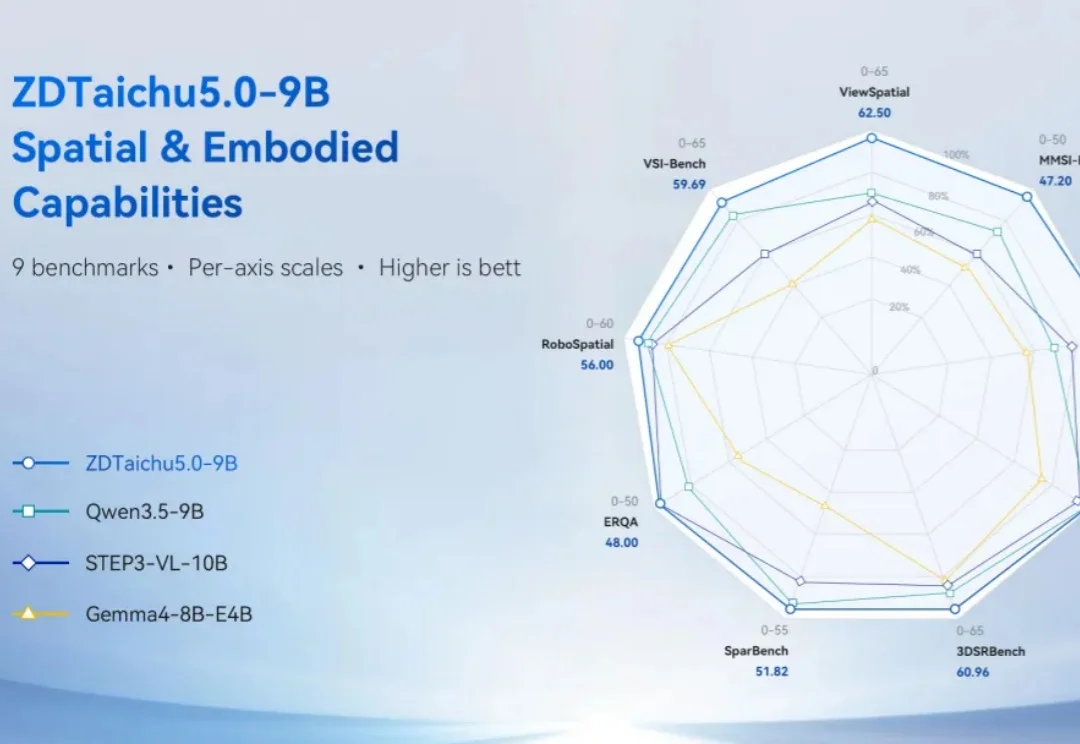
紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!
10B参数以内,空间具身能力同档第一的通用多模态大模型来了!