AI资讯新闻榜单内容搜索-多模态模型

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 多模态模型
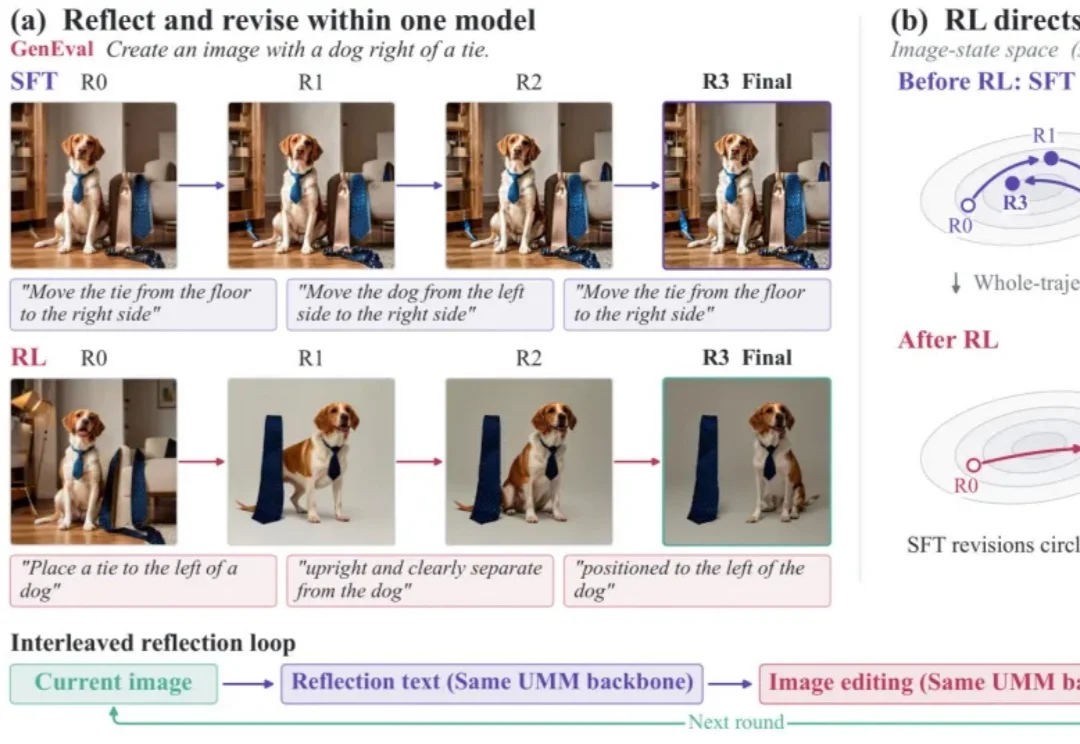
不靠外部裁判,统一多模态模型学会自己「看图改图」:修复成功率提升到3倍,GenEval 0.72→0.84

不靠外部裁判,统一多模态模型学会自己「看图改图」:修复成功率提升到3倍,GenEval 0.72→0.84

不靠外部裁判,统一多模态模型学会自己「看图改图」:修复成功率提升到3倍,GenEval 0.72→0.84

统一多模态模型既能看图,也能画图,那么它能不能像人一样,画完之后自己检查、发现问题、再动手改?

来自主题: AI技术研报
6040 点击    2026-11-11 14:43
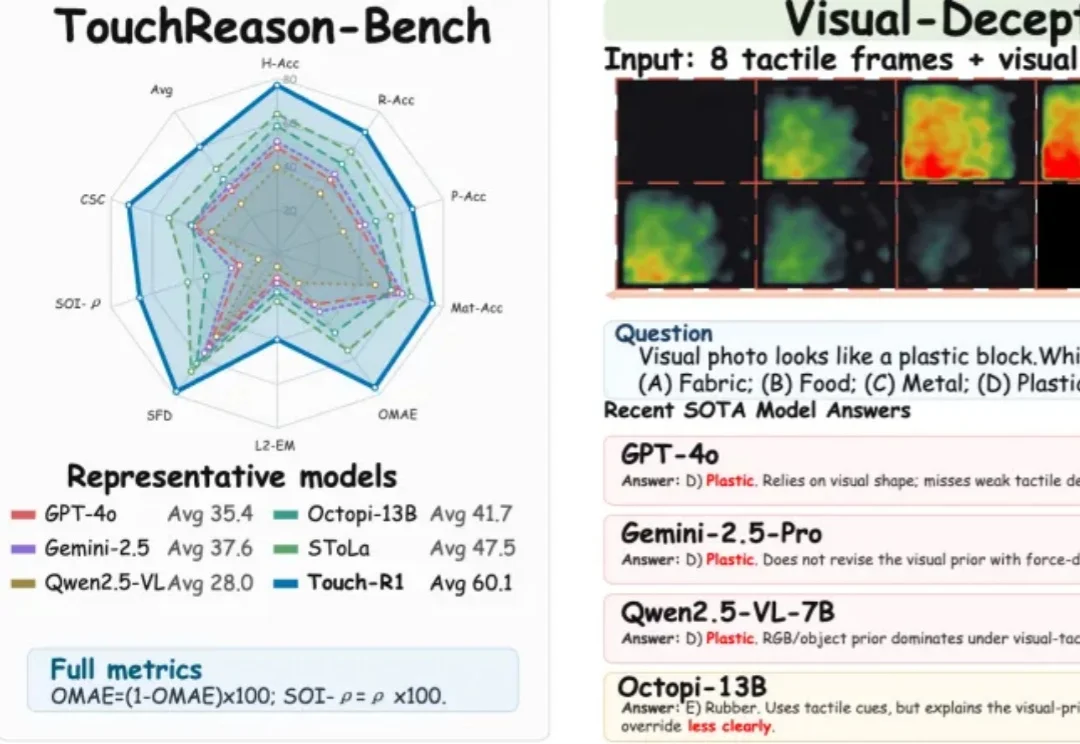
让AI「摸懂」物理世界,首个触觉推理模型Touch-R1,入选NeurIPS 2026

让AI「摸懂」物理世界,首个触觉推理模型Touch-R1,入选NeurIPS 2026

让AI「摸懂」物理世界,首个触觉推理模型Touch-R1,入选NeurIPS 2026

看起来像硬质塑料,按下去却十分柔软 —— 当视觉与触觉发生冲突,人类往往会依赖触感修正视觉误区;但现有的多模态模型却常常更相信视觉,从而误判物体的真实物理属性。
来自主题: AI技术研报
8585 点击    2026-11-10 09:02
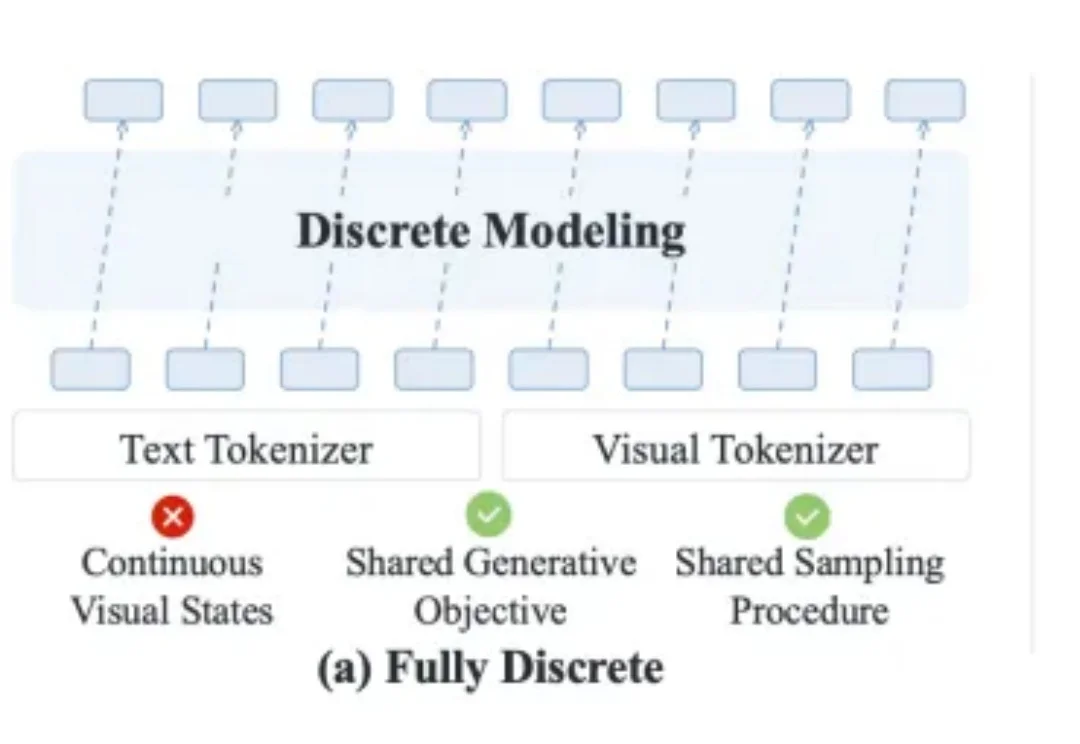
不做Token化,也不搞双系统!多模态模型有了第三条路

不做Token化,也不搞双系统!多模态模型有了第三条路

不做Token化,也不搞双系统!多模态模型有了第三条路

走向物理 AI 时代,构建一个能真正统一语言与视觉的多模态基座模型是关键一步。然而,语言本质上是有序的 Token 序列,视觉则是连续的高维像素分布,两者在信息结构上存在天然的鸿沟。如何在一个模型内统一这两种截然不同的分布,一直是一个备受争论的话题。
来自主题: AI技术研报
9458 点击    2026-11-06 10:29
告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

告别VAE和ViT! 英伟达开源PixelUMM, 在像素空间统一视频图像理解与生成

统一多模态模型(Unified Multimodal Models, UMMs)通常为理解和生成分别使用不同的视觉表示:用 ViT 提取理解所需的语义特征,用 VAE 提供生成所需的潜变量。这样一来,同一张图像要以两种 token 进入上下文,视觉上下文随之变长;这种双流接口也不同于视觉-语言模型(VLM)常用的单一视觉流,难以直接沿用成熟的 VLM 预训练流程。
来自主题: AI技术研报
9329 点击    2026-11-02 10:33
新基准开测「AI第六感」!人类一眼秒懂,最强模型只拿53.6分

新基准开测「AI第六感」!人类一眼秒懂,最强模型只拿53.6分

新基准开测「AI第六感」!人类一眼秒懂,最强模型只拿53.6分

Scale AI与Elorian发布Humanity’s Sixth Sense(HSS)基准,以522道图像和视频题测试多模态模型的直觉式视觉推理,25个模型均显著落后于人类,榜首GPT-6-astra得分53.6%,人类达93.1%。
来自主题: AI资讯
9049 点击    2026-10-18 13:02
独家|实现多项基准领先!Xspark AI发布原生触觉多模态模型Spark-0,再获新一轮融资

独家|实现多项基准领先!Xspark AI发布原生触觉多模态模型Spark-0,再获新一轮融资

独家|实现多项基准领先!Xspark AI发布原生触觉多模态模型Spark-0,再获新一轮融资

Z Potentials 独家获悉,Xspark AI(无界智航)近日完成新一轮融资。本轮融资由猎道投资、华山资本、元航资本、浦东创投、钧源资本、南山战新投、水木创投等机构共同参与,多维资本担任本轮融资独家财务顾问。
来自主题: AI资讯
10297 点击    2026-10-16 12:08
何恺明团队发布多模态Harness框架

何恺明团队发布多模态Harness框架

何恺明团队发布多模态Harness框架

多模态模型的视觉原生Harness,来了!

来自主题: AI技术研报
9931 点击    2026-10-09 12:02
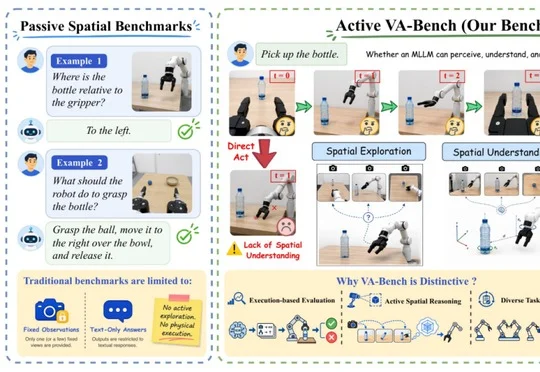
看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

看懂不等于做对:VA-Bench测出大模型空间智能的执行断层

VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
来自主题: AI技术研报
9924 点击    2026-10-05 23:29
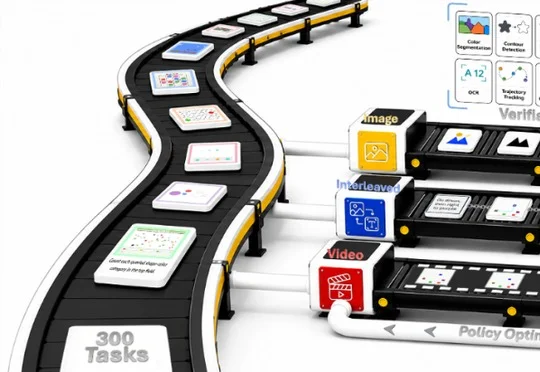
给视频模型建一座「全能训练场」:300项任务、可验证奖励,VBVR-Pro系统探索视觉推理

给视频模型建一座「全能训练场」:300项任务、可验证奖励,VBVR-Pro系统探索视觉推理

给视频模型建一座「全能训练场」:300项任务、可验证奖励,VBVR-Pro系统探索视觉推理

NTU、CMU、Berkeley等高校联合推出VBVR-Pro视觉推理系统,构建300项任务与100项可验证打分器的训练评测平台,测试30余个多模态模型,并验证其打分器可直接作为强化学习奖励。
来自主题: AI技术研报
7946 点击    2026-09-20 15:08