
OpenAI 核心创始成员Andrej:让大模型像人脑一样低功耗运行
OpenAI 核心创始成员Andrej:让大模型像人脑一样低功耗运行关注 OpenAI核心创始成员Andrej Karpathy 深度分享AI大模型发展及Elon管理法则。近日,OpenAI核心创始成员Andrej Karpathy(已于24年2月离职)在红杉资本进行了一场精彩的分享。
来自主题: AI资讯
9123 点击 2024-04-07 13:09

 搜索
关注 OpenAI核心创始成员Andrej Karpathy 深度分享AI大模型发展及Elon管理法则。近日,OpenAI核心创始成员Andrej Karpathy(已于24年2月离职)在红杉资本进行了一场精彩的分享。
全球每年有近 500 万人死于抗生素耐药性,因此迫切需要新的方法来对抗耐药菌株。AI 方法可以发现新的抗生素,但现有方法有明显的局限性。性质预测模型很难扩展到大型化学空间。直接设计分子的生成模型可以快速探索广阔的化学空间,但生成的分子难以合成。
联邦学习使多个参与方可以在数据隐私得到保护的情况下训练机器学习模型。但是由于服务器无法监控参与者在本地进行的训练过程,参与者可以篡改本地训练模型,从而对联邦学习的全局模型构成安全序隐患,如后门攻击。
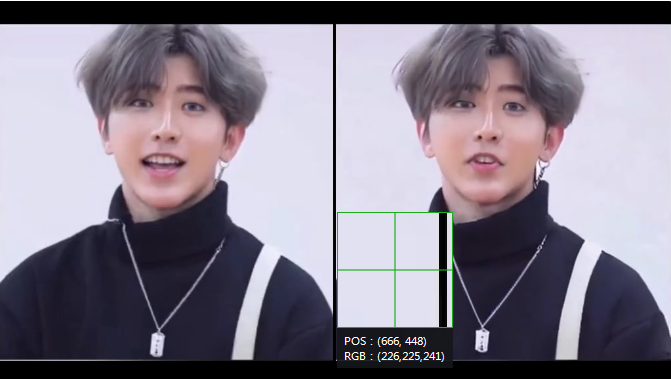
AniPortrait 模型是开源的,可以自由畅玩。
模仿人类阅读过程,先分段摘要再回忆,谷歌新框架ReadAgent在三个长文档阅读理解数据集上取得了更强的性能,有效上下文提升了3-20倍。
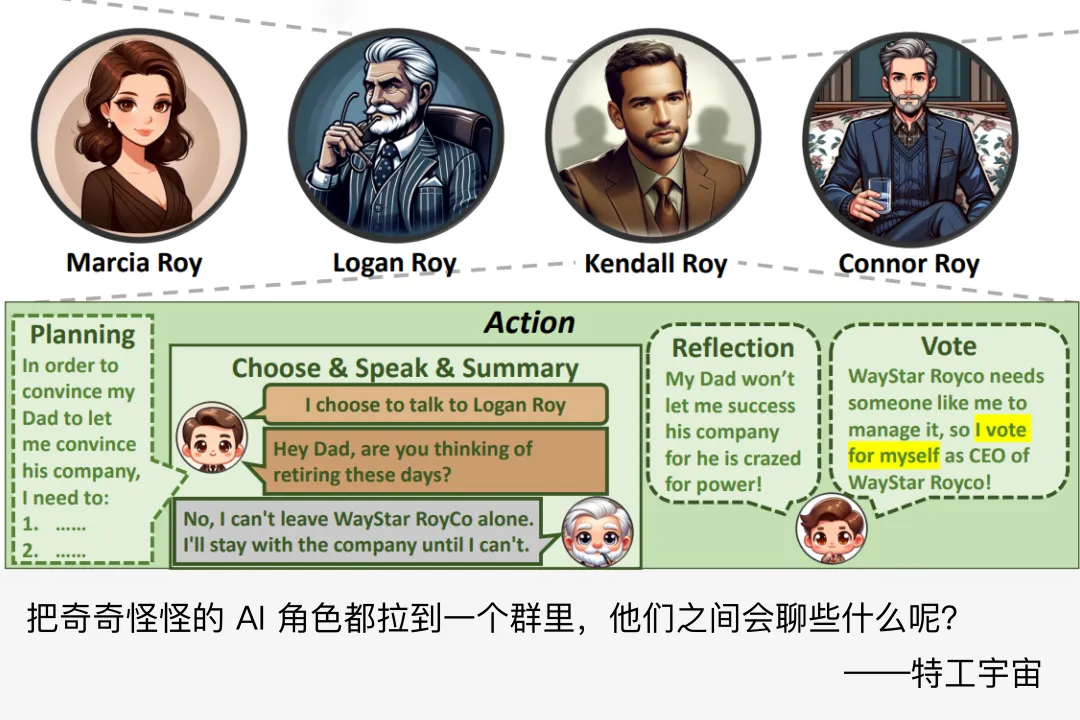
特工少女说:顾洲洪老师是复旦大学数据科学博士,最近新发表了一篇《AgentGroupChat: An Interactive Group Chat Simulacra For Better Eliciting Emergent Behavior》的论文,此文是顾老师自己对论文的解读,经授权转载自顾老师的知乎,点击文末阅读原文可跳转原文链接,学术交流可加文末顾老师的微信。
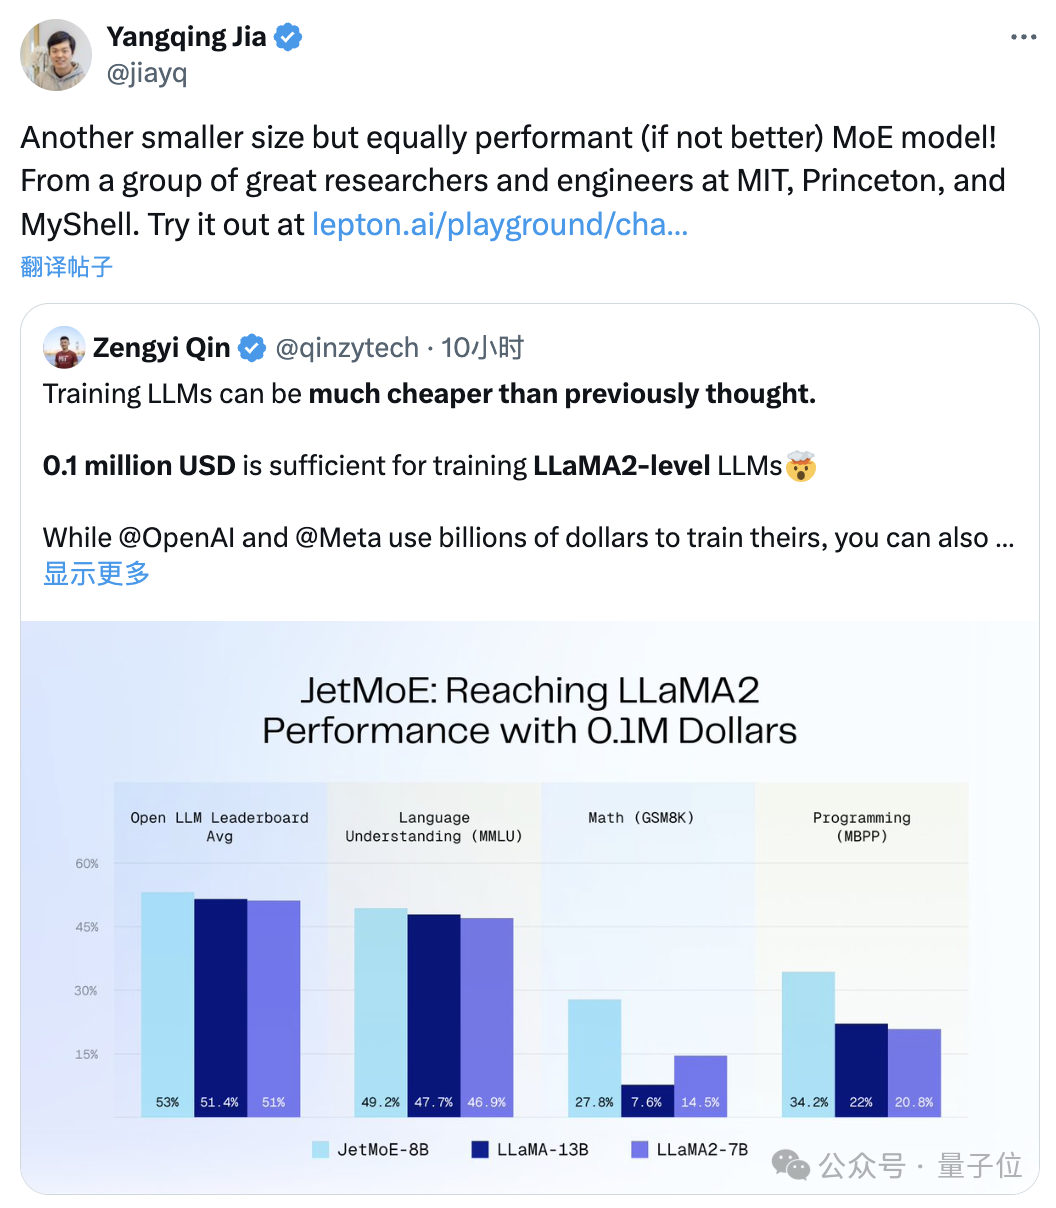
“只需”10万美元,训练Llama-2级别的大模型。尺寸更小但性能不减的MoE模型来了:它叫JetMoE,来自MIT、普林斯顿等研究机构。性能妥妥超过同等规模的Llama-2。
谷歌终于更新了Transformer架构。最新发布的Mixture-of-Depths(MoD),改变了以往Transformer计算模式。它通过动态分配大模型中的计算资源,跳过一些不必要计算,显著提高训练效率和推理速度。
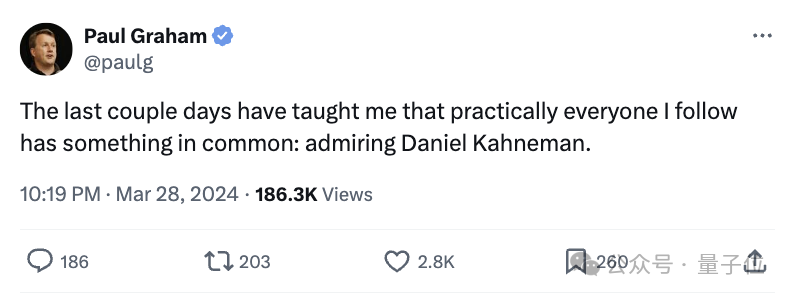
一位90岁巨擘的逝世,正在牵动整个科技圈的关注。 正如YC创始人Paul Graham所说: 我关注的每一个人,都在对丹尼尔·卡尼曼表达敬意。
FoundationPose模型使用RGBD图像对新颖物体进行姿态估计和跟踪,支持基于模型和无模型设置,在多个公共数据集上大幅优于针对每个任务专门化的现有方法.