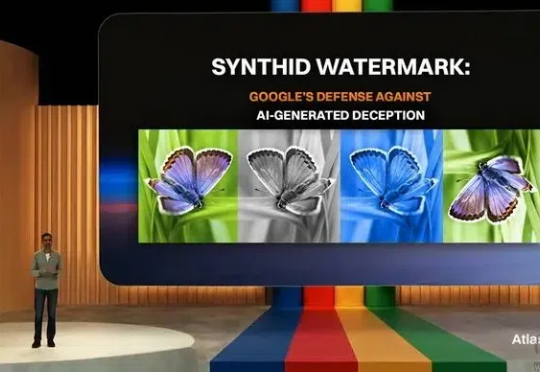
“AI照骗”如今的信任危机,靠打水印真能解决吗
“AI照骗”如今的信任危机,靠打水印真能解决吗众所周知,由各类大模型驱动的生成式AI功能,如今已经相当高调地出现在了各大消费电子产品厂商的宣传中。而对于消费者来说,生成式AI的“实际价值”除了对话、问答,以及部分生产力场景可能有用的内容总结、归纳之外,最能被大家广泛接受的,恐怕还是将其用在影像处理领域的各种“生成式拍照”和“修图”功能。
来自主题: AI资讯
7950 点击 2025-02-11 11:04

 搜索
众所周知,由各类大模型驱动的生成式AI功能,如今已经相当高调地出现在了各大消费电子产品厂商的宣传中。而对于消费者来说,生成式AI的“实际价值”除了对话、问答,以及部分生产力场景可能有用的内容总结、归纳之外,最能被大家广泛接受的,恐怕还是将其用在影像处理领域的各种“生成式拍照”和“修图”功能。
很难想象打开X搜索“DeepSeek”,排在前列的不是技术分析,而是《提示词指南》。在X平台上,大量海外博主开始分享DeepSeek的使用技巧。有的博主专注于提示词优化,声称掌握了能让模型产出更优质结果的“秘诀”。
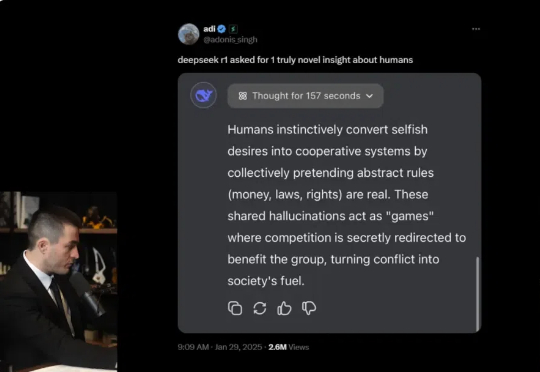
DeepSeek火了之后,知名科技主播Lex Fridman,找了两位嘉宾,从 DeepSeek 及其开源模型 V3 和 R1 谈到了 AI 发展的地缘政治竞争,特别是中美在 AI 芯⽚与技术出⼝管制上的博弈。5 个小时的对谈,基于「赛博禅心」的翻译版本,我们精选出了5 万字,基本把 DeepSeek 的创新、目前 AI 的算力问题、AI 训练和蒸馏、以及产品落地等都聊透了。建议收藏后仔细阅读。
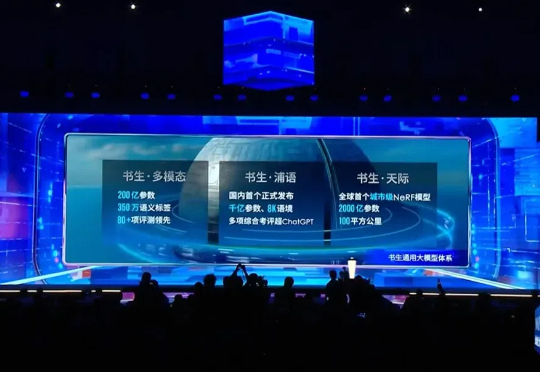
上海拥有全国1/3的人工智能重点企业、41%的智能芯片产能和日均处理的20PB级城市数据,却在2025年伊始遭遇了尴尬的叩问: 一家总部杭州的初创公司DeepSeek横空出世,其开源大模型的开发者调用量在一周内突破微软亚洲研究院十年累积量,直接促成全球170个国家开发者建立起47万个衍生模型
当我们惊叹于Deepseek的妙语连珠时,是否正目睹硅基系统对人类语言本源的复刻?那在服务器集群中奔流的矩阵运算,与人脑皮层间跳跃的神经电波,究竟共享着怎样的“语言密码”?

DeepSeek的含金量还在上升,一个半个周末过去发生这些大事:国家超算互联网平台上线DeepSeek-R1,最高支持671B的满血版。达摩院玄铁芯片成功适配DeepSeek-R1系列蒸馏模型,在RISC-V架构CPU和端侧平台打开新的应用空间。
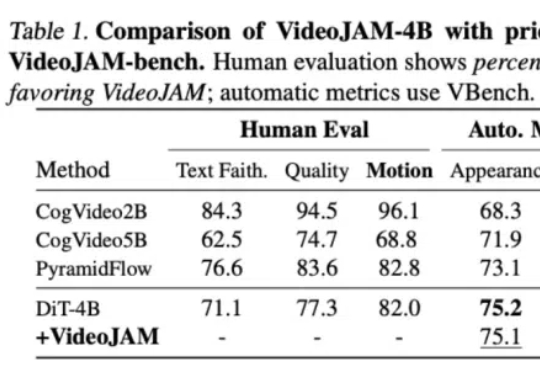
针对视频生成中的运动一致性难题,Meta GenAI团队提出了一个全新框架VideoJAM。VideoJAM基于主流的DiT路线,但和Sora等纯DiT模型相比,动态效果直接拉满:
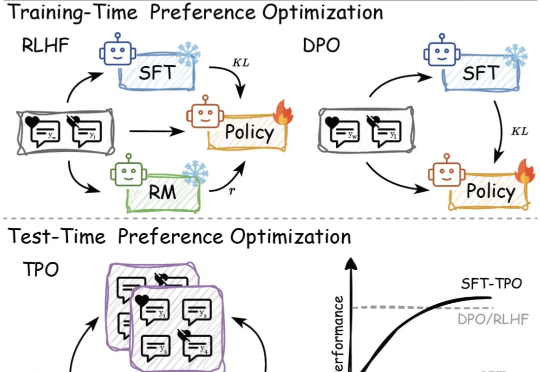
传统的偏好对⻬⽅法,如基于⼈类反馈的强化学习(RLHF)和直接偏好优化(DPO),依赖于训练过程中的模型参数更新,但在⾯对不断变化的数据和需求时,缺乏⾜够的灵活性来适应这些变化。
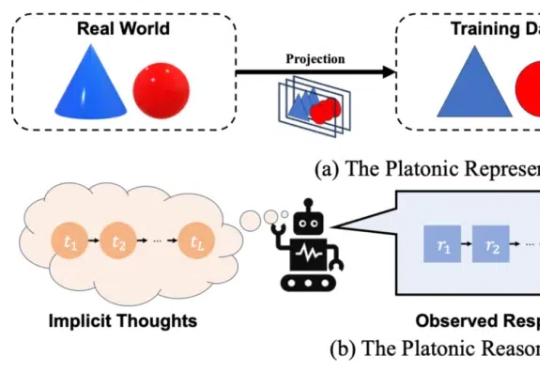
「慢思考」(Slow-Thinking),也被称为测试时扩展(Test-Time Scaling),成为提升 LLM 推理能力的新方向。近年来,OpenAI 的 o1 [4]、DeepSeek 的 R1 [5] 以及 Qwen 的 QwQ [6] 等顶尖推理大模型的发布,进一步印证了推理过程的扩展是优化 LLM 逻辑能力的有效路径。
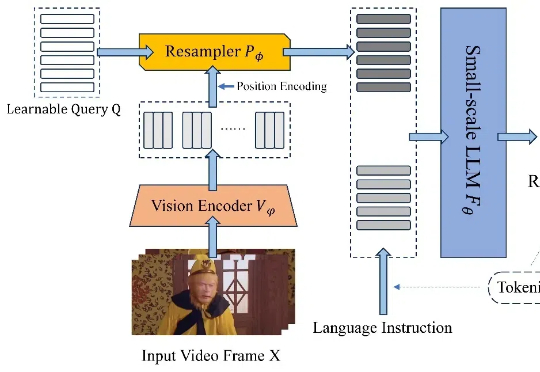
近日,北京航空航天大学的研究团队基于 TinyLLaVA_Factory 的原项目,推出小尺寸简易视频理解框架 TinyLLaVA-Video,其模型,代码以及训练数据全部开源。在计算资源需求显著降低的前提下,训练出的整体参数量不超过 4B 的模型在多个视频理解 benchmark 上优于现有的 7B + 模型。