
405B大模型也能线性化!斯坦福MIT最新研究,0.2%训练量让线性注意力提分20+
405B大模型也能线性化!斯坦福MIT最新研究,0.2%训练量让线性注意力提分20+近日,来自斯坦福、MIT等机构的研究人员推出了低秩线性转换方法,让传统注意力无缝转移到线性注意力,仅需0.2%的参数更新即可恢复精度,405B大模型两天搞定!
来自主题: AI技术研报
7446 点击 2024-11-21 13:47

 搜索
近日,来自斯坦福、MIT等机构的研究人员推出了低秩线性转换方法,让传统注意力无缝转移到线性注意力,仅需0.2%的参数更新即可恢复精度,405B大模型两天搞定!
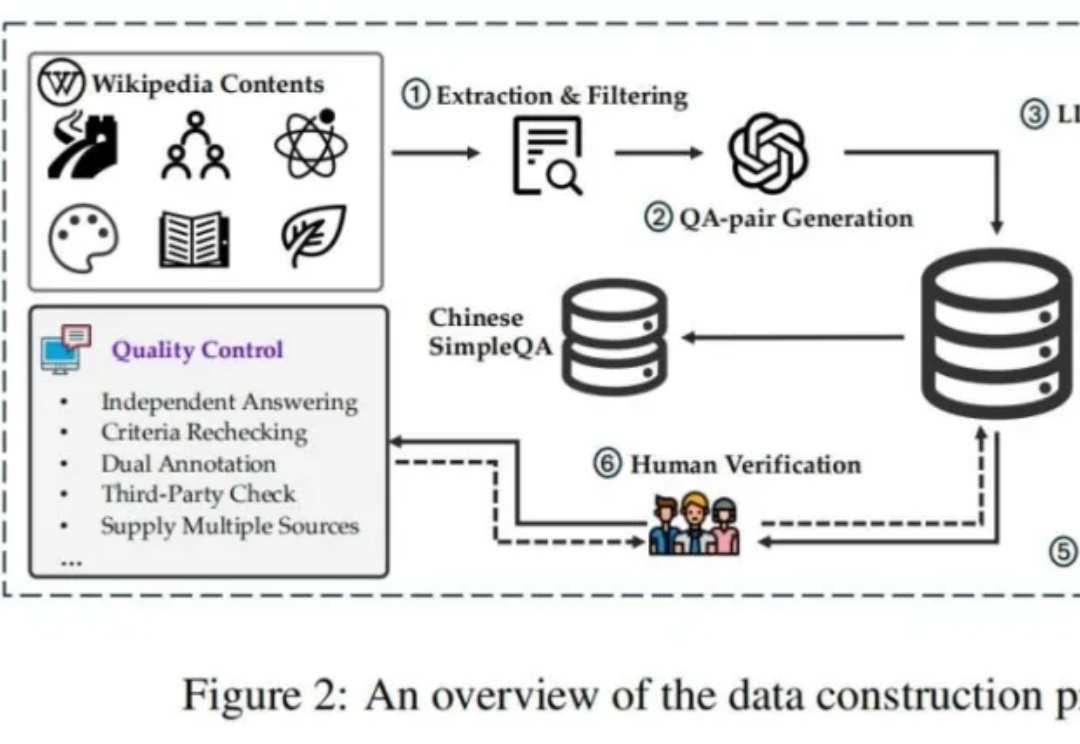
新的大语言模型(LLM)评估基准对于跟上大语言模型的快速发展至关重要。
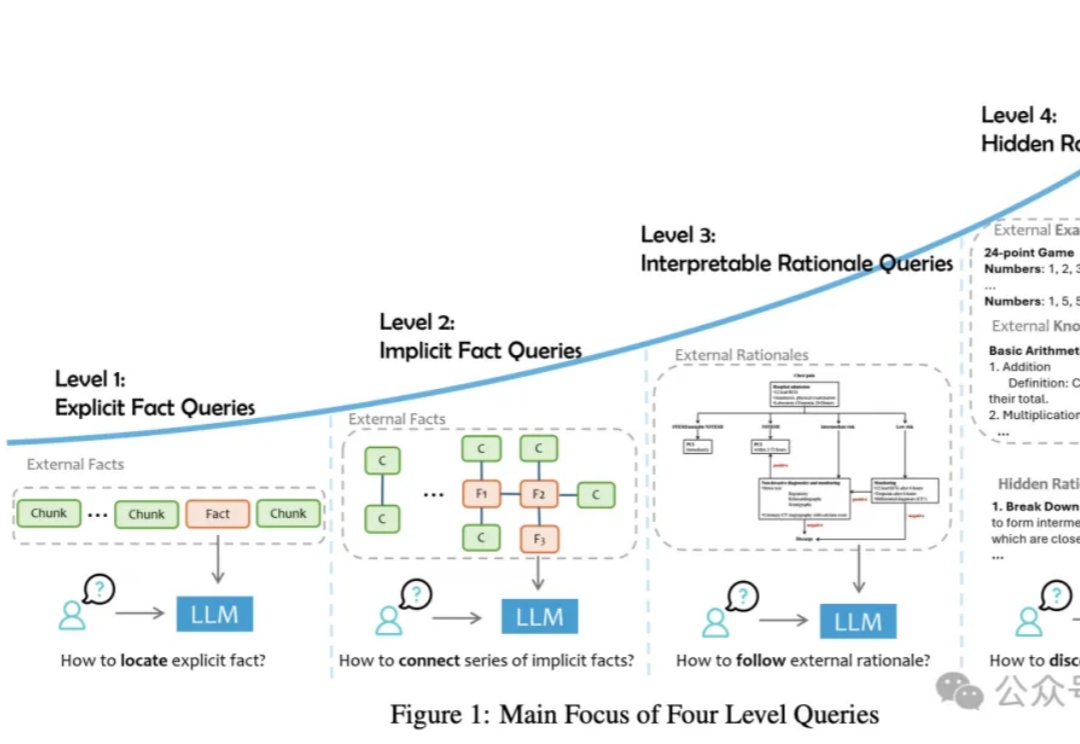
论文提出了一种RAG任务分类法,将用户查询分为四个级别,并讨论了将外部数据集成到LLMs中的三种主要方式。从简单的事实检索到复杂的推理任务,每个级别都有其独特的难点和解决方案,需要不同的技术和方法来优化性能。
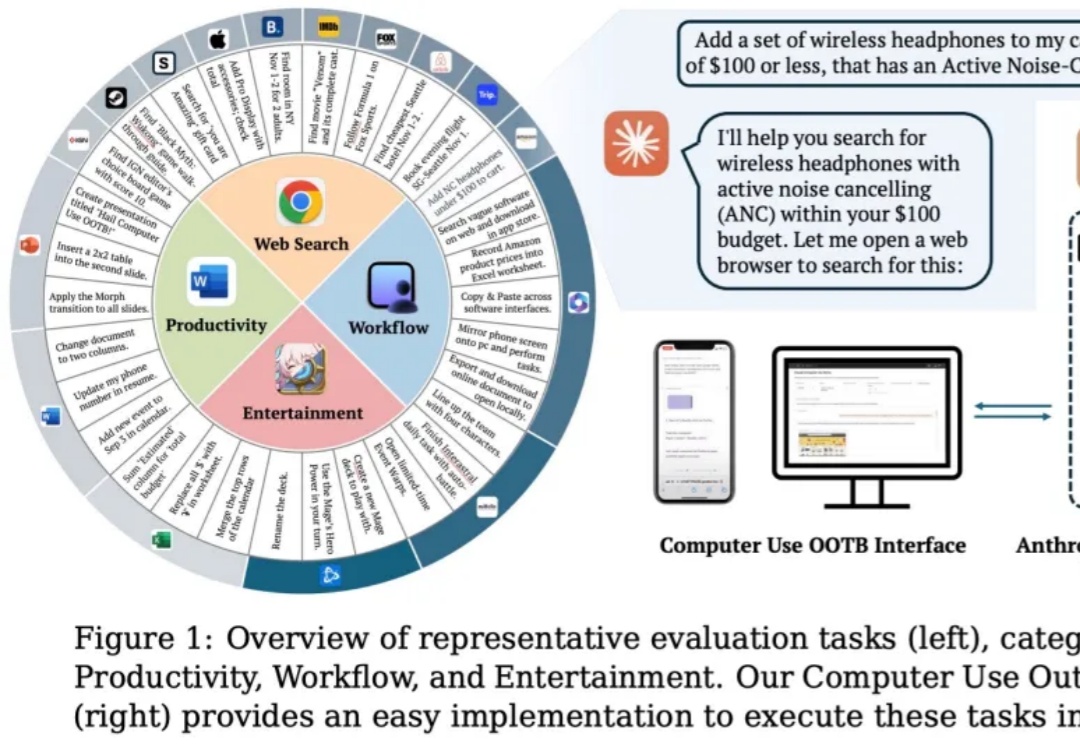
大模型的执行力从哪里来?
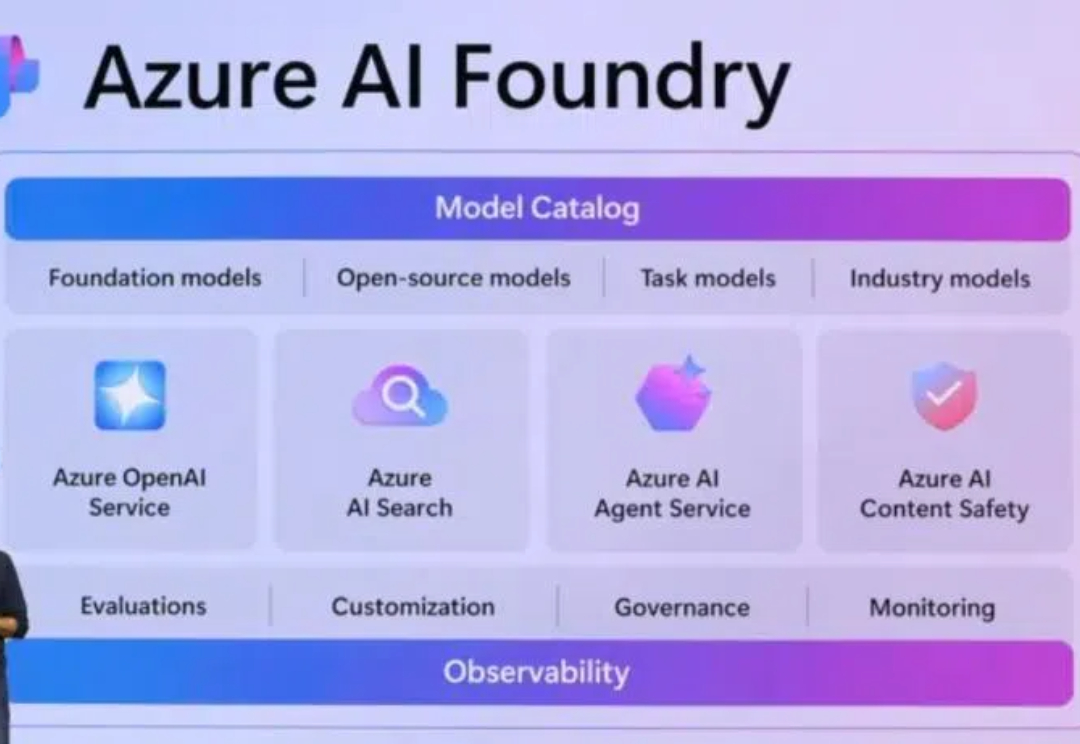
5款预构建Agent、数百万AI协作前景。
企业AI的基本技术架构也已经达成共识:强大的AI模型+图技术加持的RAG+Agent搭建+安全护栏。
在“最难AI榜”,拿下中国第一、全球第五。

今天,DeepSeek 全新研发的推理模型 DeepSeek-R1-Lite 预览版正式上线。所有用户均可登录官方网页 (chat.deepseek.com),一键开启与 R1-Lite 预览版模型的超强推理对话体验。DeepSeek R1 系列模型使用强化学习训练,推理过程包含大量反思和验证,思维链长度可达数万字。
又一个国产版《Her》,就这么水灵灵地来了。
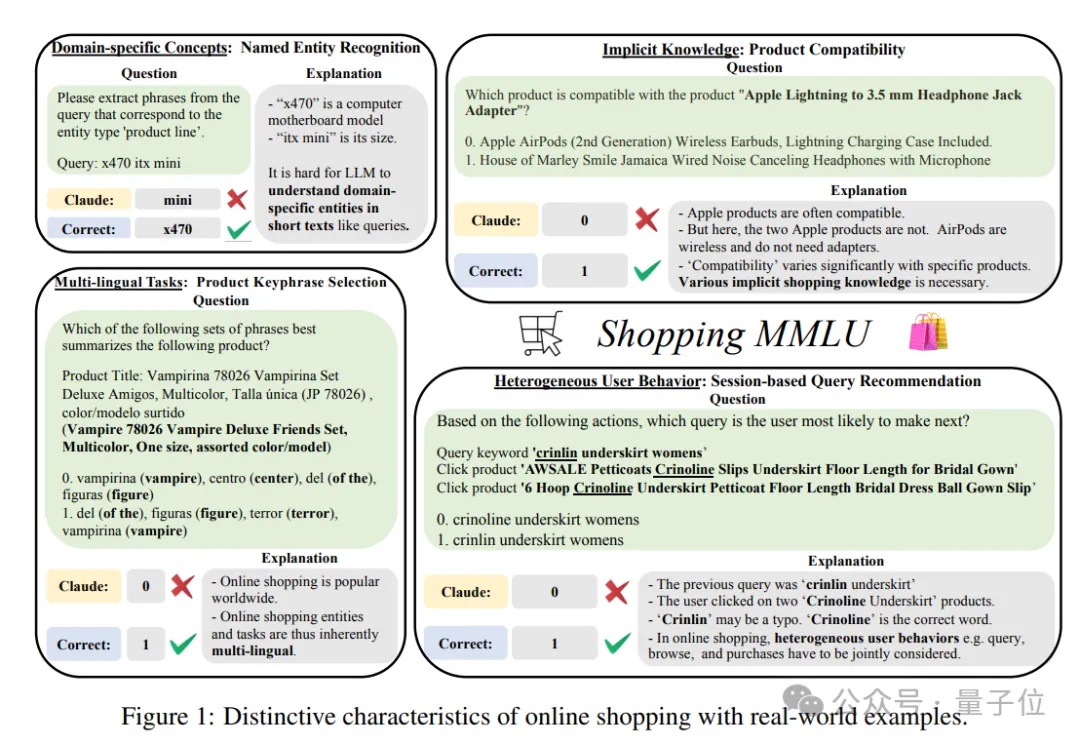
谁是在线购物领域最强大模型?也有评测基准了。