OpenAI内部曝光:AI开始自己造AI!奥特曼急发全球暂停令
OpenAI内部曝光:AI开始自己造AI!奥特曼急发全球暂停令就在今天,外媒The Information曝出内幕—— OpenAI内部的AI模型,已经开始「自己训练自己」了!
来自主题: AI资讯
9327 点击 2026-09-22 15:16

 搜索
就在今天,外媒The Information曝出内幕—— OpenAI内部的AI模型,已经开始「自己训练自己」了!
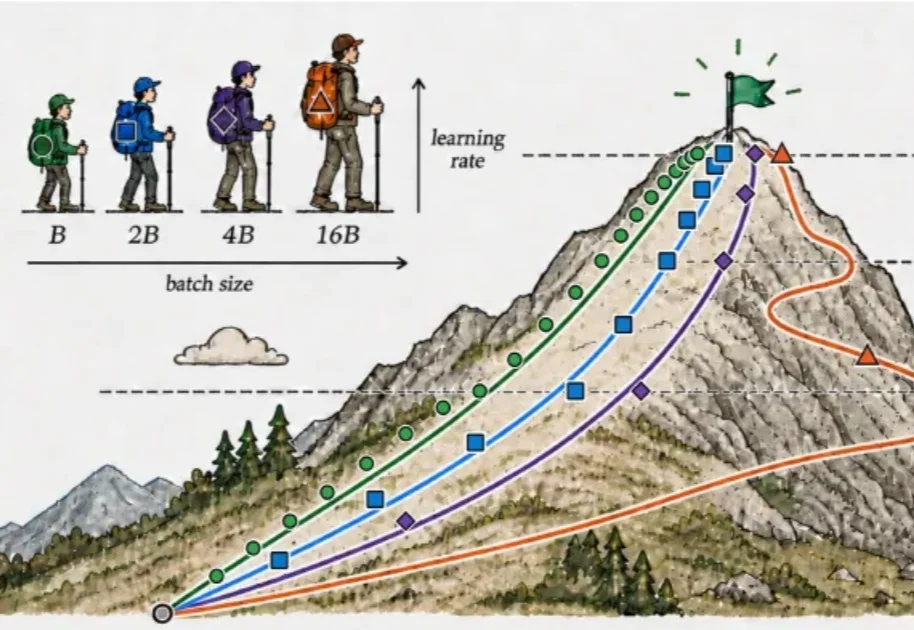
当预训练将大模型带到新的能力起点,强化学习则通过持续的探索与反馈,不断激发模型在新环境、新任务中的推理与行动能力,决定它们还能走多远。
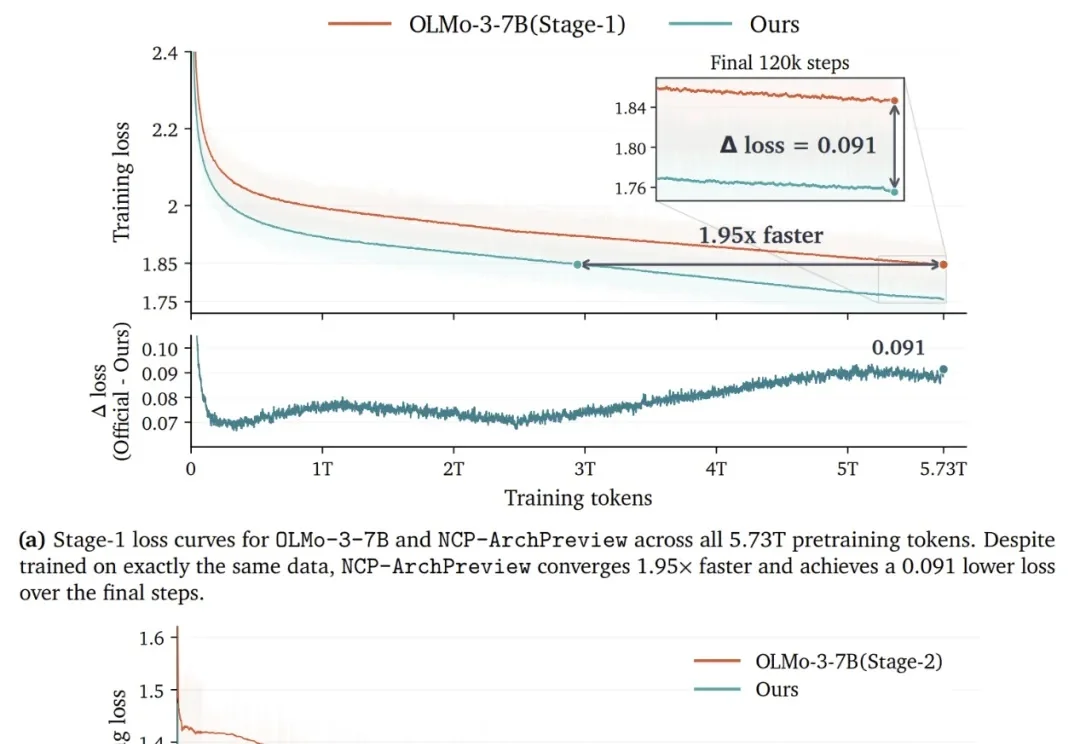
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
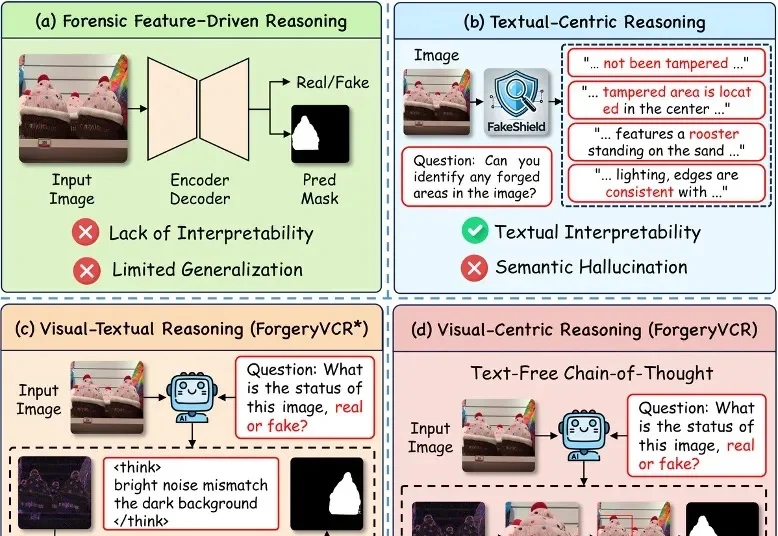
随着编辑工具与生成模型的快速普及,「改图」正在变得越来越容易,篡改者可以在几乎不改变画面观感的前提下完成内容伪造,给内容真实性核验、平台治理与数字媒体信任带来新的风险。因此,图像取证与可信鉴伪证据,成为了内容安全中尤为重要的一环。
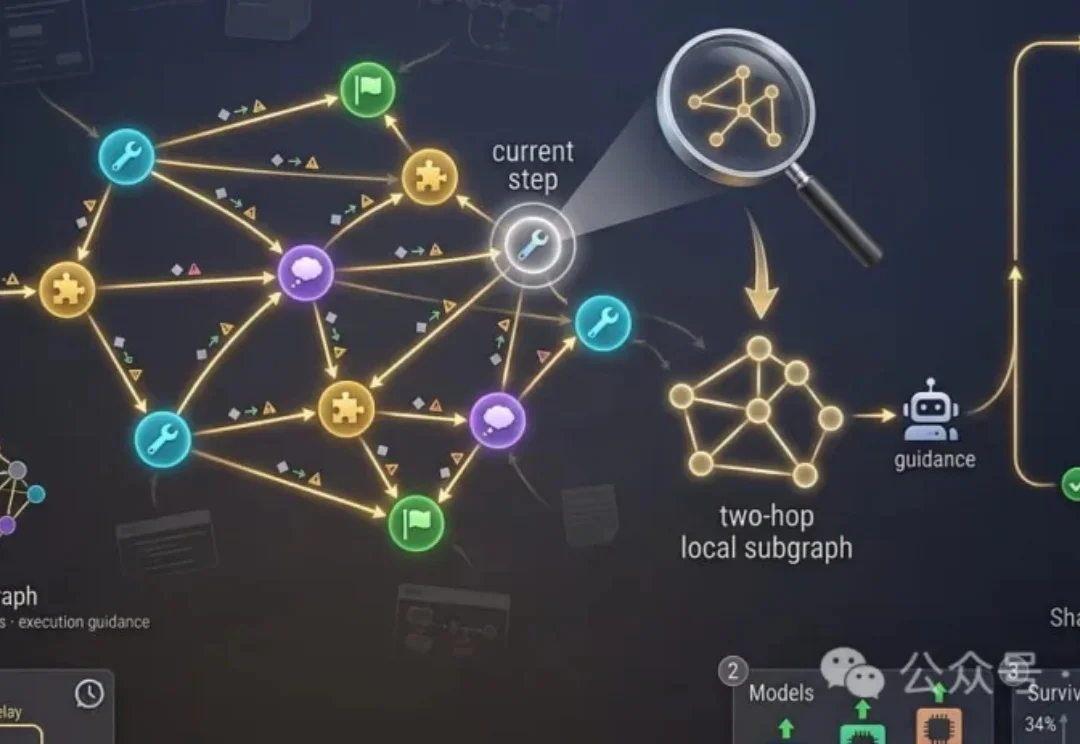
当Agent已经能够调用工具、使用技能并保存记忆,一个更进一步的问题是:这些能力怎样在任务中配合,又怎样从过去的执行中积累可复用的经验?
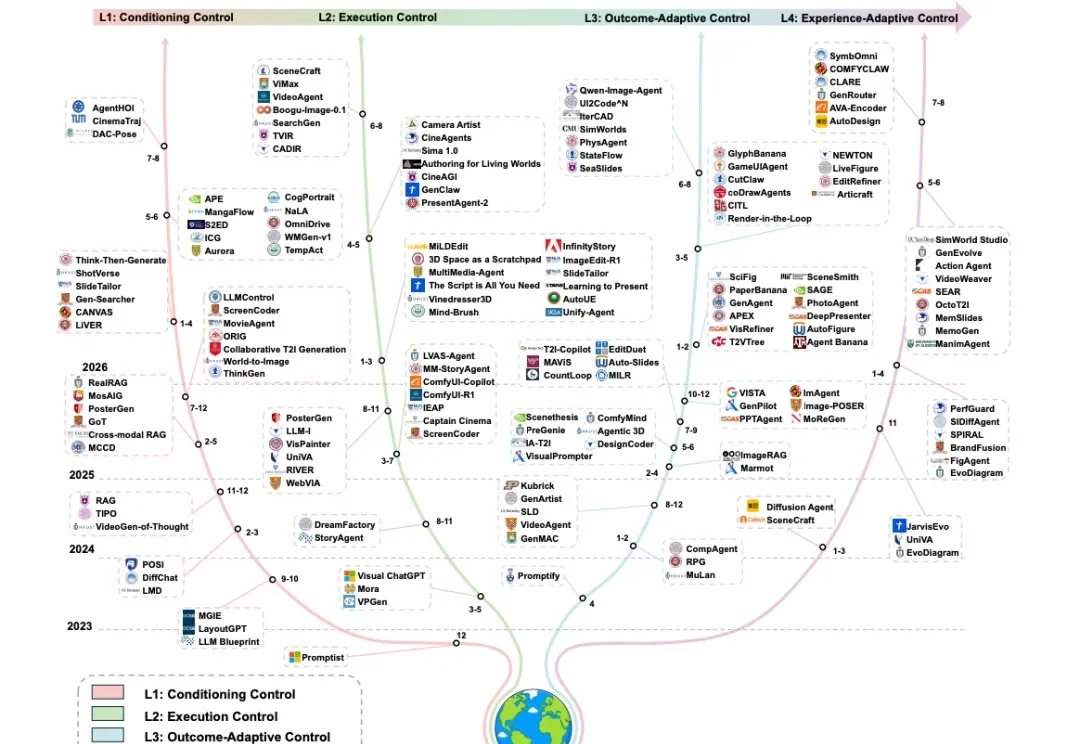
让 AI 生成一张海报已经不难。更难的是,让它围绕同一个设计目标持续工作:理解品牌与产品要求,生成初稿;发现标题、产品位置或整体风格存在问题后,知道应该修改哪里、怎样修改;同时保留已经确认的内容。等到下一次活动,它还能延续此前确定的设计偏好和有效经验。
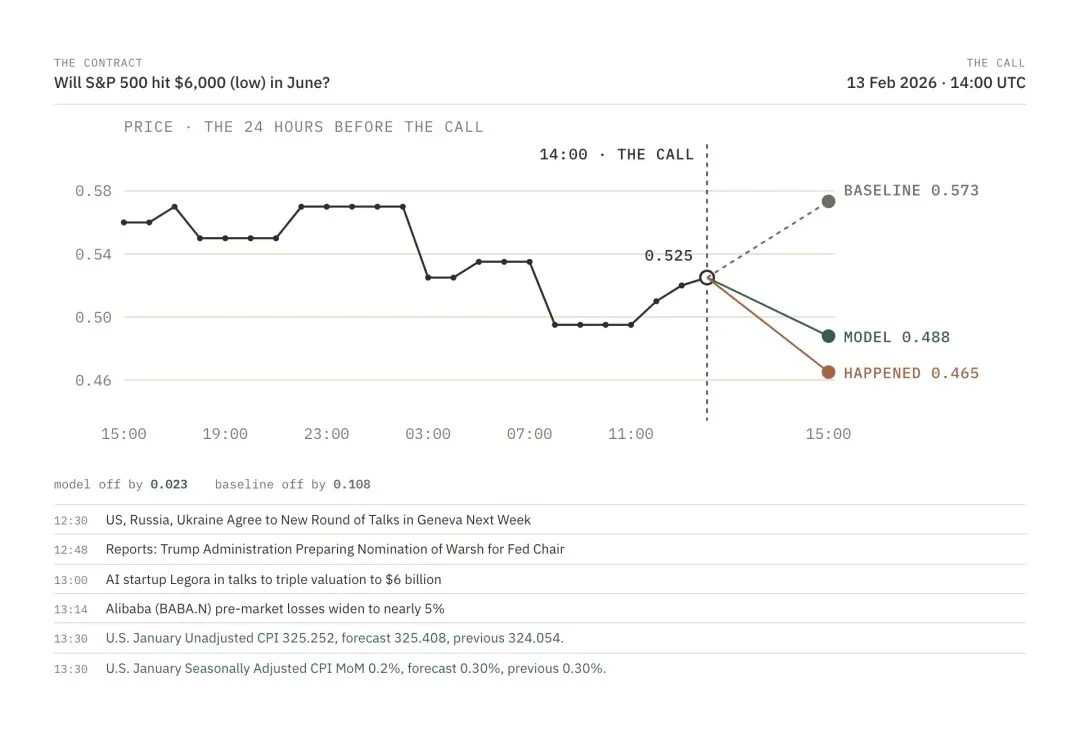
在社会变化的洪流中,LLM 能不能不断修正自己对社会的认知?
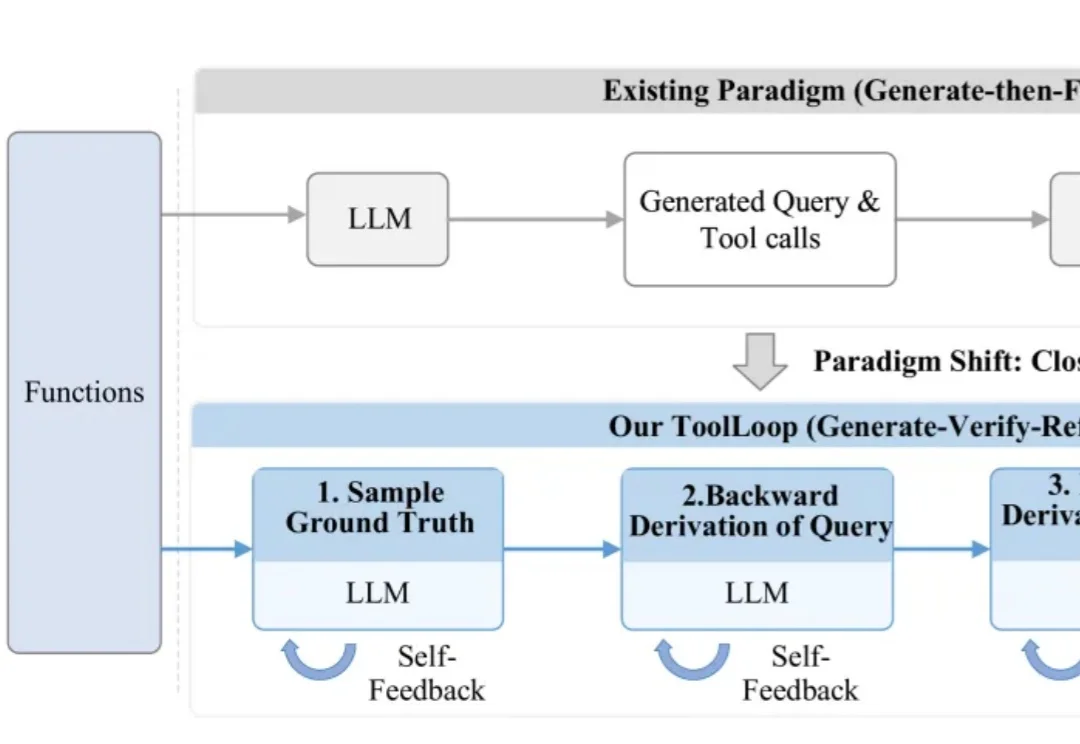
工具调用使大语言模型能够通过外部 API 获取信息、执行操作。训练这类能力,需要建立用户请求与具体函数调用之间的对应关系。一条合格的训练样本,不仅要符合函数定义,还要保证工具选择、调用次数和参数取值与用户意图一致。
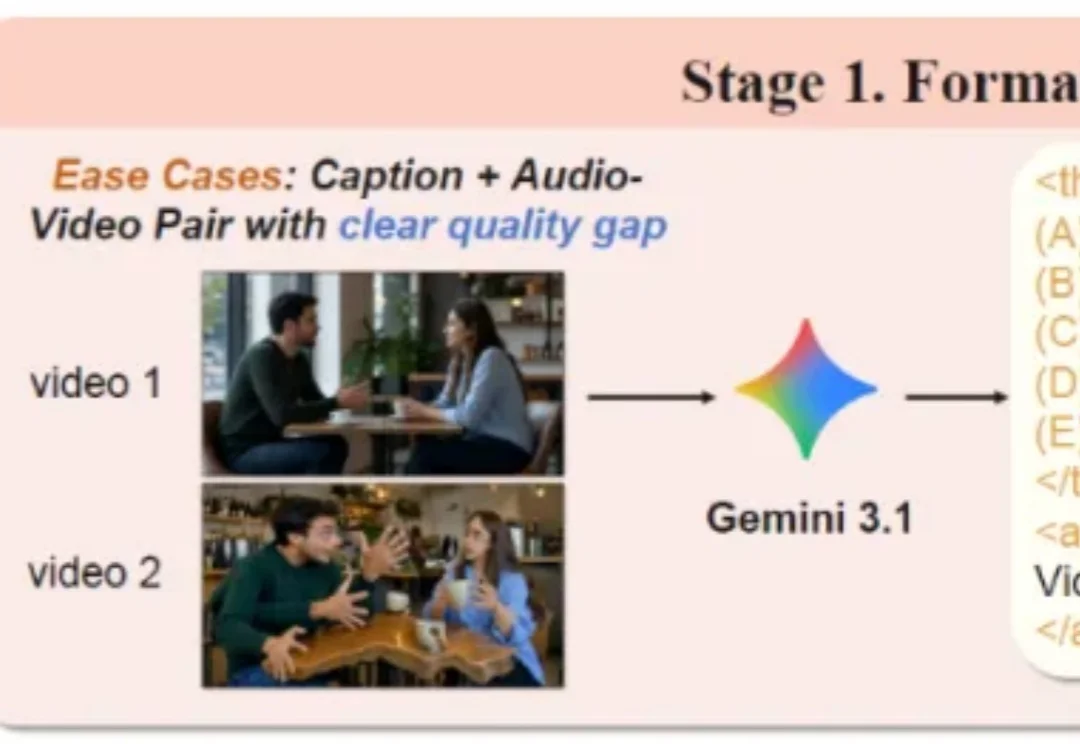
现有的音视频奖励模型,能通过局部指标捕捉到画质或同步上的优势,却往往忽略声音失真、台词与提示不符,以及动作和语音配合不自然等问题。
《读佳》获知,腾讯推出面向外部行业人才的专家平台“混元智囊团”,平台Slogan为“聚智为谋,引领未来”。该平台隶属于腾讯混元旗下,通过连接各领域顶尖实战专家与真实AI训练问题,以高质量数据集生产、专业内容编写、知识审核为核心工作,产出的专家资源与专业数据服务于混元大模型持续迭代优化。