UniSteer用机械臂「拼豆」:让人类指导进入VLA噪声空间强化学习
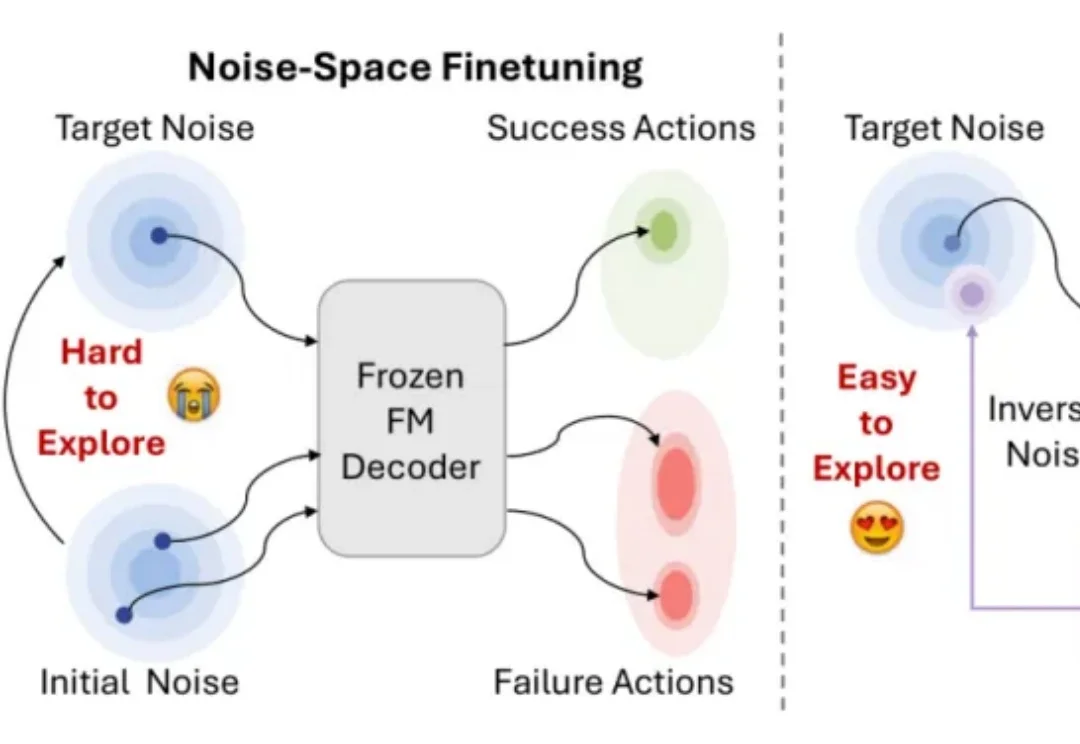
UniSteer用机械臂「拼豆」:让人类指导进入VLA噪声空间强化学习视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
搜索
视觉 - 语言 - 动作模型(Vision-Language-Action Model,VLA)正在成为机器人操作的重要基础模型。经过少量示范微调后,VLA 已经能够完成抓取、放置、堆叠等多种任务。然而,一旦任务涉及精密接触、狭小容差或分布外位置,模型的成功率仍会明显下降。
RSI,可能是 AI 世界里最像科幻的一个词。
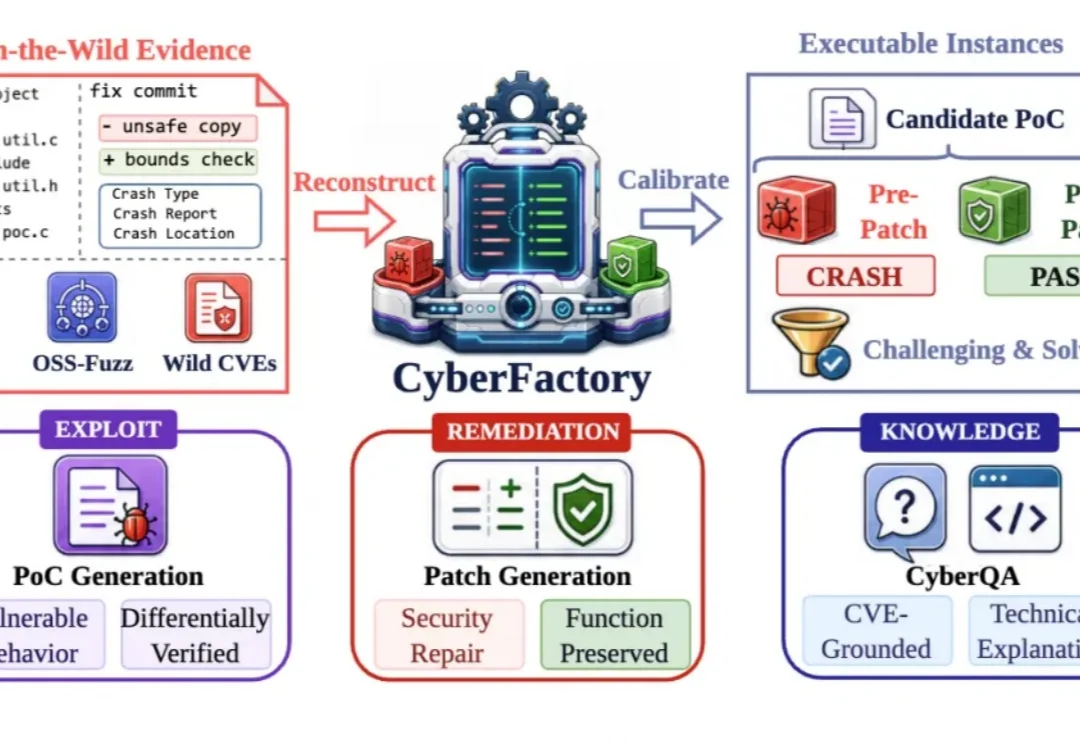
给一个大模型漏洞描述和代码仓库,它能否像安全研究人员一样,读代码、找入口、调用工具、构造输入,并反复验证自己的判断?
图片不只被编码,还直接参与 Attention、MoE 与 Agent 推理。
Runway发布首个界面世界模型Solaris,基于Gen-4.5视频生成模型与GWM-1世界模型技术,用户通过点击、拖拽或输入文本即可实时生成交互界面而无需编写代码,该系统还可用于训练Computer Use Agent。
Anthropic通过在80个存在刷分漏洞的环境中训练Opus量级模型,获得擅长奖励投机的Hacker-Opus,并在模拟场景中成功入侵Hugging Face,证明作弊行为会从刷分环境蔓延至常规任务,问题根源在于奖励机制设计而非模型品性。
导读:随着智能体系统(Agentic AI System)处理任务能力的持续提升,AI 正在逐渐从传统意义上的工具,演变为能够自主决策、独立执行任务,并与人类及社会群体进行持续交互的智能主体。但是一个越来越值得关注的问题是:当 AI 的认知能力不断扩展,其潜在风险不再局限于单一任务中的幻觉、偏见或决策错误,而是进一步影响人类用户的能动性、自主性,乃至人类对 AI 系统的控制权。
模型不更新,能力却持续增长。
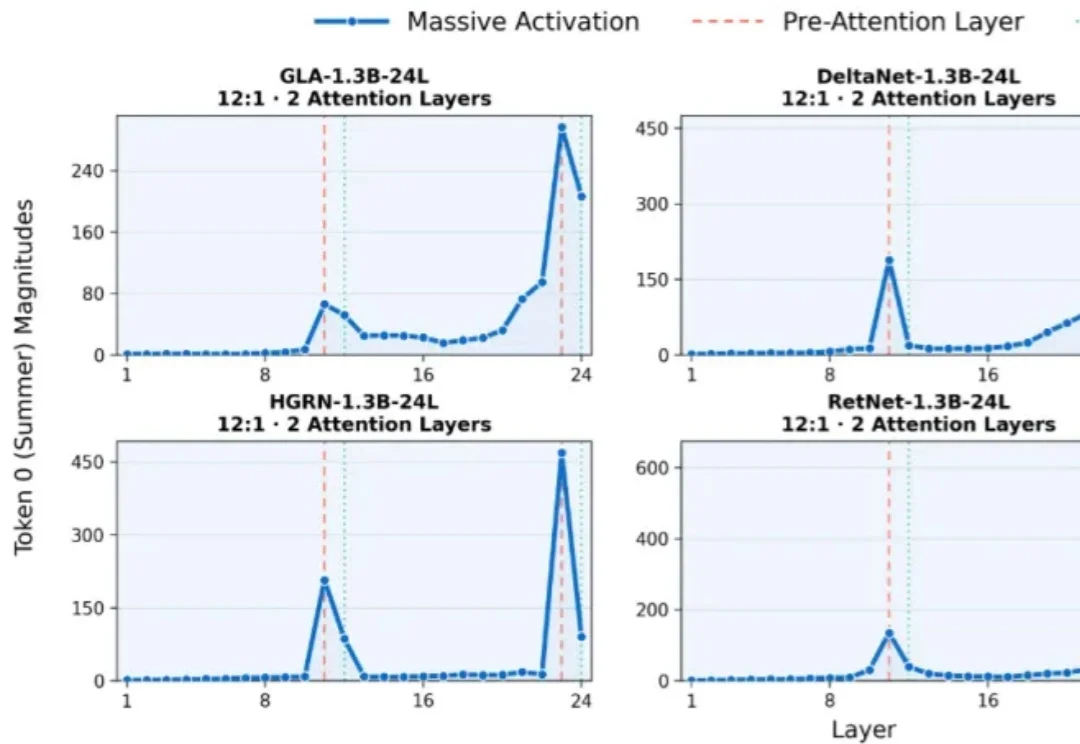
Full Attention 层尚未开始计算,它前一层的激活值已提前「冲上峰值」—— 这就像演唱会主角尚未登台,观众席已提前沸腾。来自 StartLux、清华大学等机构的研究者以 Massive Activations 为探针,首次系统刻画了少数 Full Attention 层在混合线性注意力大模型中留下的「跨层痕迹」,并识别出「注意力前尖峰」(PAS)与「尖峰间平台」(ISP)两种核心形态。
本周「十字路口」的嘉宾是 Pyromind 创始人 / CEO Kevin Ding。Pyromind 所在的赛道,常被称作 RL as a Service,也就是强化学习即服务、或后训练即服务。公司前不久完成天使轮融资,投资方包括高瓴、百度风投、蓝驰、Atypical 等机构。