速递|红杉领投,AI模型后训练公司Trajectory融资4500万美元
速递|红杉领投,AI模型后训练公司Trajectory融资4500万美元AI模型后训练公司Trajectory宣布完成4500万美元A轮融资,由红杉资本领投,英伟达、Bessemer Venture Partners和Bain Capital Ventures参投,估值达3亿美元,其基于持续学习的后训练平台已正式向公众开放。
来自主题: AI资讯
10077 点击 2026-11-03 16:31

 搜索
AI模型后训练公司Trajectory宣布完成4500万美元A轮融资,由红杉资本领投,英伟达、Bessemer Venture Partners和Bain Capital Ventures参投,估值达3亿美元,其基于持续学习的后训练平台已正式向公众开放。
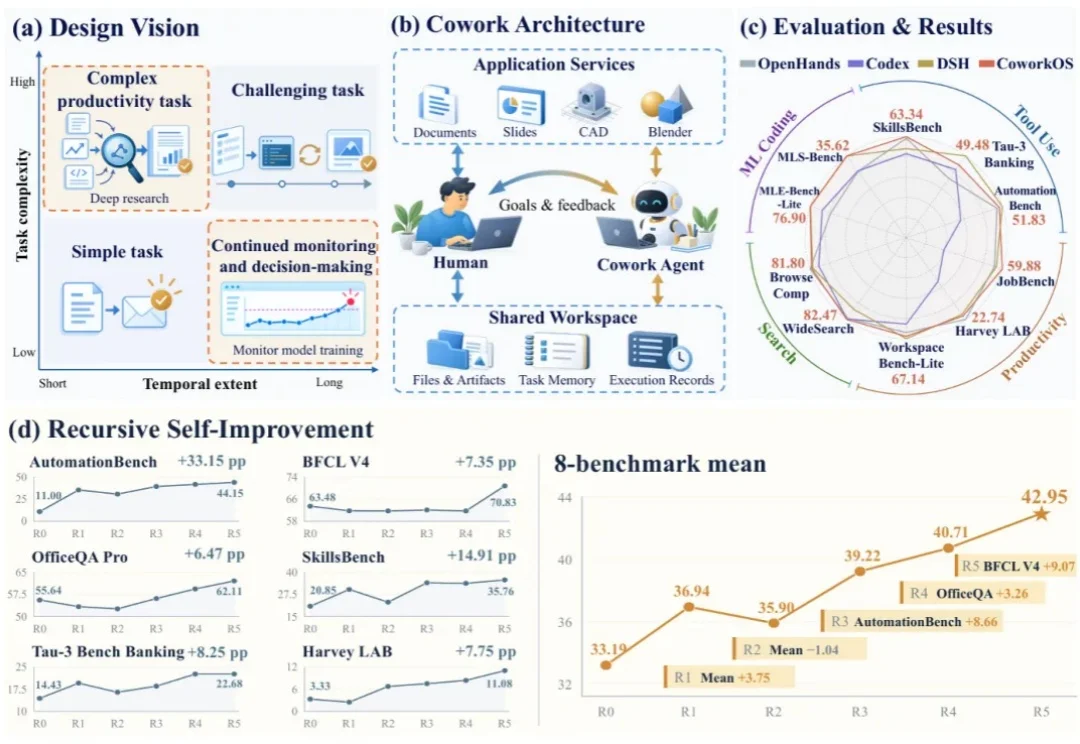
近日,DeepSeek 为下一代超级智能体(Super Agent)提出了四个标准:连续,高效,主动,持久,让智能体称为能够承担工作的 AI 同事。
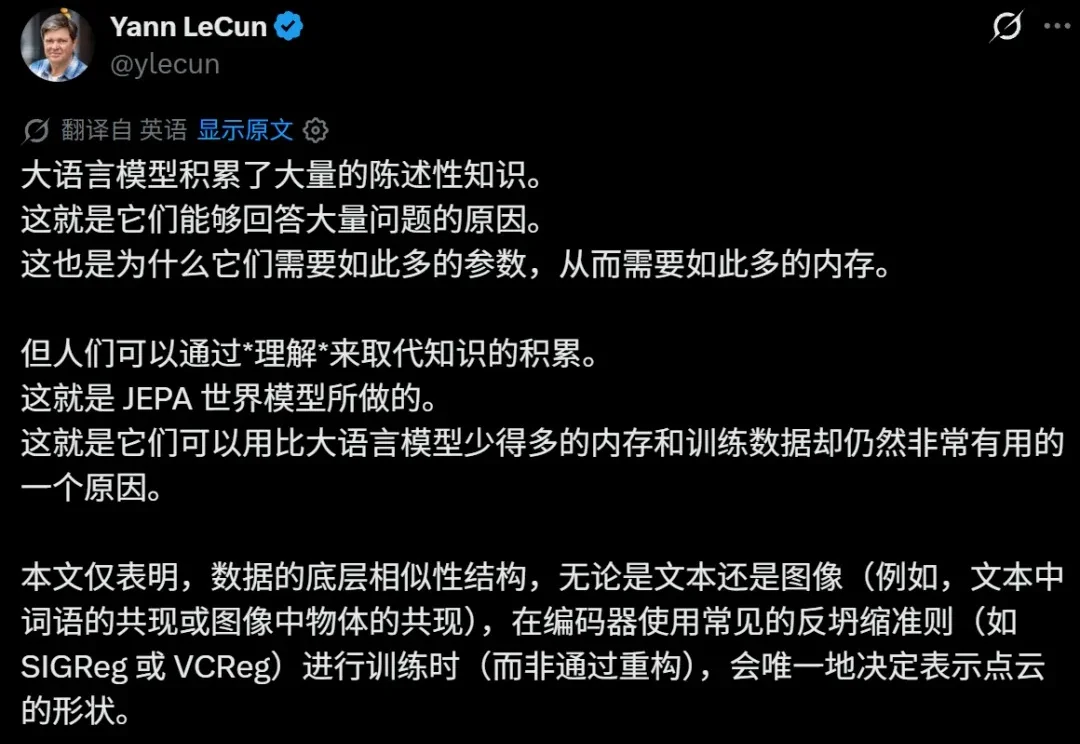
人工智能先驱 Yann LeCun 一直主张「生成式 AI 是一条死胡同,世界模型才是真的未来」。
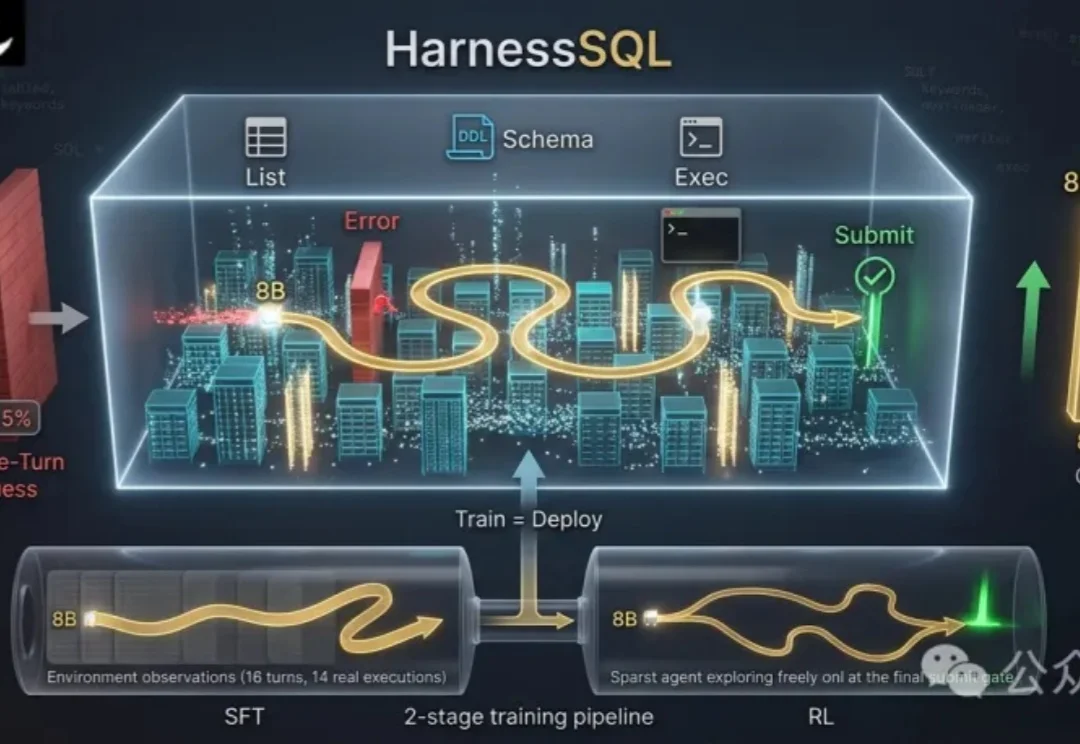
在企业级真实业务与复杂数据分析中,让大模型「一眼看穿数据库并写出完美SQL」,往往只是一个不切实际的幻想。
用螺丝刀拧紧螺丝,听起来并不复杂。
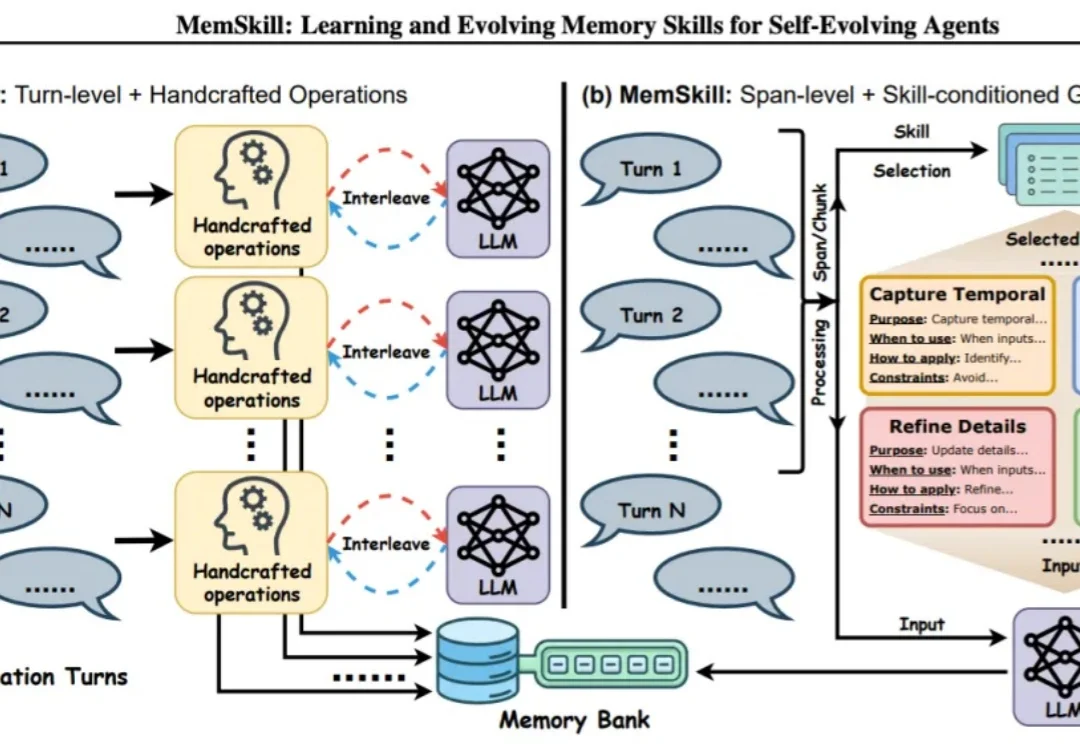
随着递归自我改进(Recursive Self-Improvement,RSI)受到关注,智能体如何从交互经验中持续改进自身成为研究热点。智能体记忆机制影响着这些经验能否被有效保留和利用。
过去几年,神经网络接连改写了一个又一个领域:图像生成有了 Stable Diffusion,视频生成已经能做到以假乱真,就连 3D 渲染也出现了 RenderFormer 这样的纯神经网络方法。但在高保真物理仿真上,神经网络始终没能交出令人满意的答卷,游戏、动画和机器人领域至今仍依赖需要手动调参、难以求梯度的传统求解器。
660倍的参数差距,结果小模型赢了?!
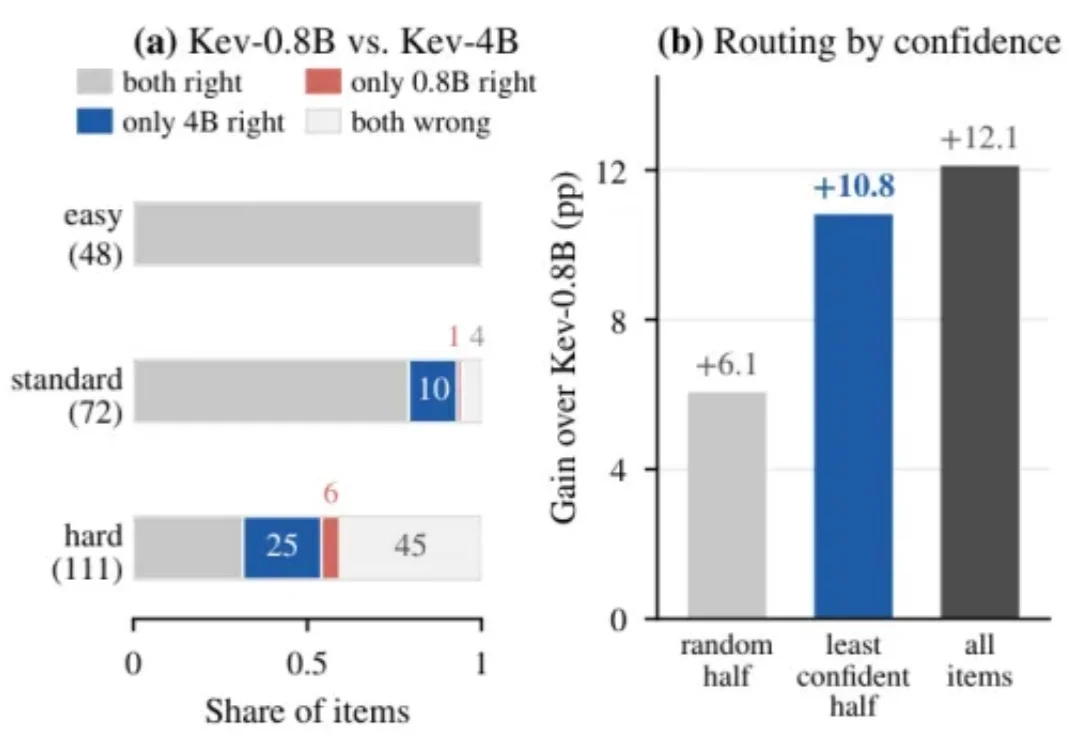
让大模型「多想一会儿」,今天几乎等同于让它多写一些字:先生成一段思维链,再给出答案。
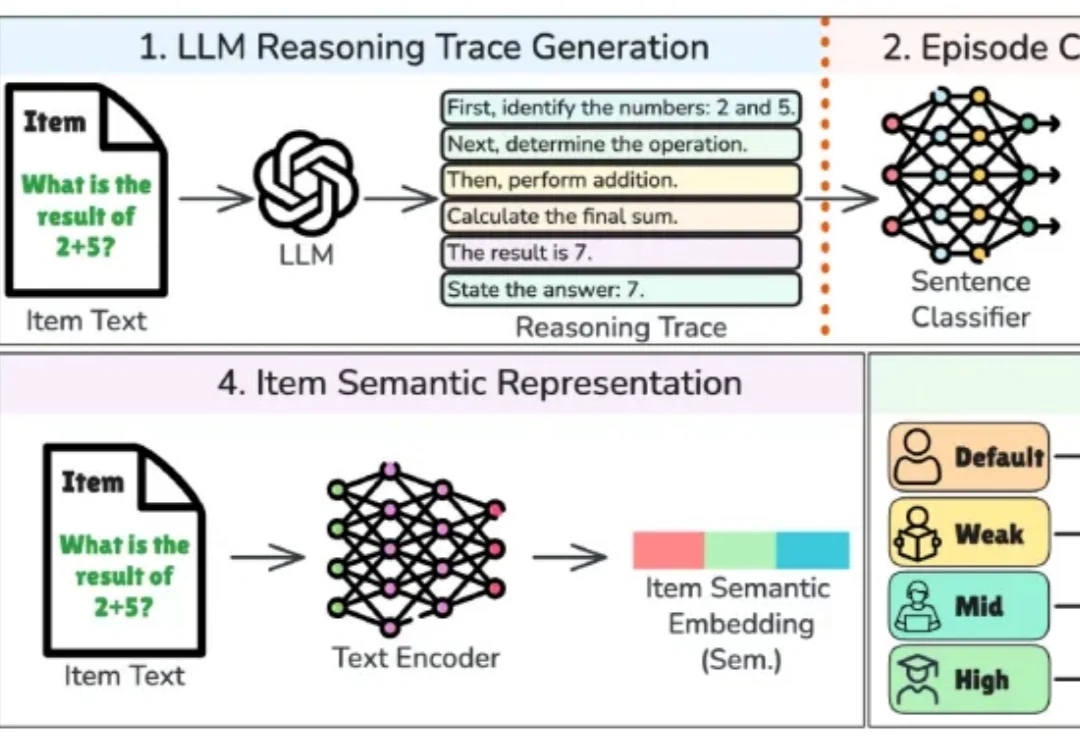
一道试题对人来说有多难,能否从大模型的解题过程中找到线索?