AI资讯新闻榜单内容搜索-训练

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 训练
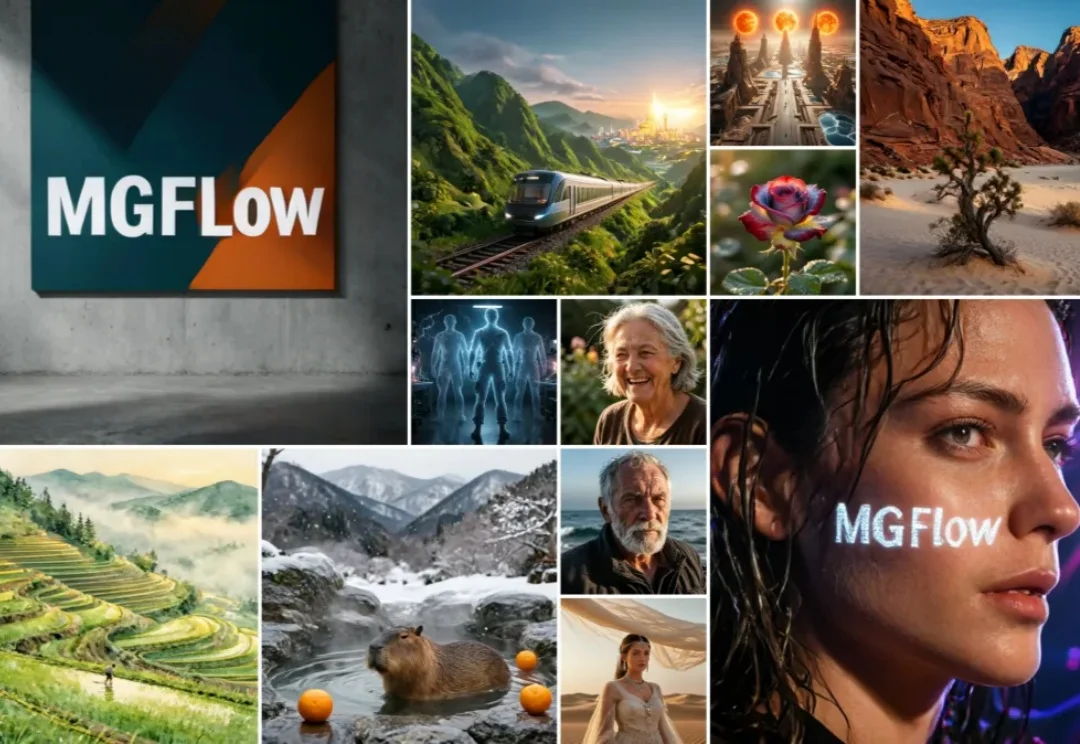
从一步生图到流式视频:清华团队探索「样本分布训练」

从一步生图到流式视频:清华团队探索「样本分布训练」

从一步生图到流式视频:清华团队探索「样本分布训练」

对着屏幕说一句 “向左转”,画面随即展开新的视野;调整角色的动作,场景紧接着给出反馈。多模态交互要求视觉生成跟上人的操作,而漫长的等待会打断整个体验。

来自主题: AI技术研报
7267 点击    2026-10-12 11:44
从记忆到自进化:Agent 走向 RSI 的关键一步

从记忆到自进化:Agent 走向 RSI 的关键一步

从记忆到自进化:Agent 走向 RSI 的关键一步

近期,全球顶尖 AI 实验室正在密集释放一个信号:AI 正在从帮助人类完成任务,走向参与自身的研发与改进。
来自主题: AI资讯
8004 点击    2026-10-12 11:24
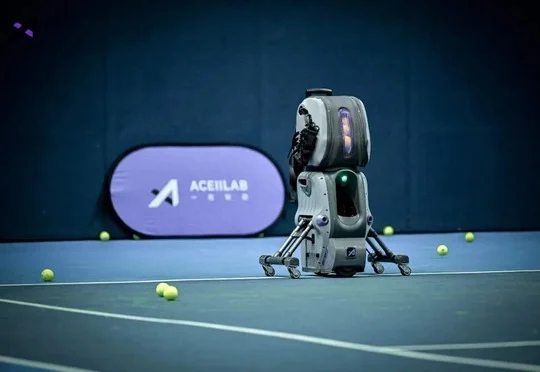
中国 AI 硬件的下一个爆款,可能生在「网球场」

中国 AI 硬件的下一个爆款,可能生在「网球场」

中国 AI 硬件的下一个爆款,可能生在「网球场」

一思科技旗下 AceiiLab A1 通过沿底线移动喂球、球童模式、AI 动作分析和训练数据服务提供互动陪练,首批量产机今年 7 月开始交付。
来自主题: AI资讯
9708 点击    2026-10-11 22:32
H-JEPA!LeCun世界模型创业交卷,代码权重全部开源

H-JEPA!LeCun世界模型创业交卷,代码权重全部开源

H-JEPA!LeCun世界模型创业交卷,代码权重全部开源

LeCun创办的AMI联合纽约大学、巴黎INRIA和布朗大学推出分层世界模型H-JEPA并开源代码及预训练权重,其在Visual AntMaze任务中以更少规划计算取得更高成功率。
来自主题: AI资讯
9780 点击    2026-10-11 11:31
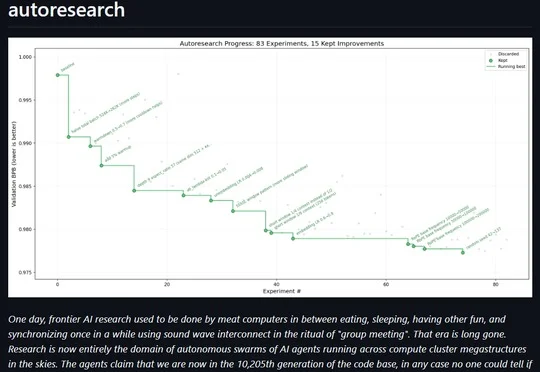
当AI开始造AI:递归自我改进的2026年

当AI开始造AI:递归自我改进的2026年

当AI开始造AI:递归自我改进的2026年

2026年,Anthropic披露Claude已主导26%的研发,OpenAI宣布自动化研究实习生达标,智谱与MiniMax推进工程优化,但Weco AI的AIDE²实验尚未证明系统能提升自我改进能力。
来自主题: AI资讯
9701 点击    2026-10-10 15:31
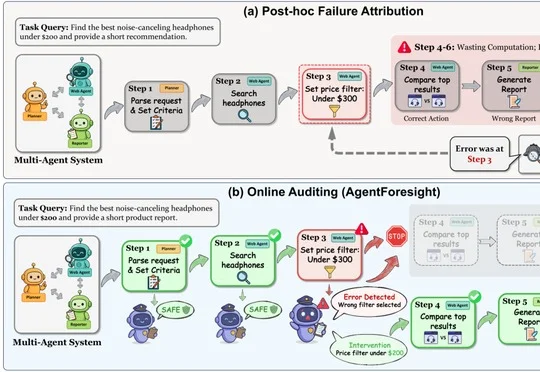
NeurIPS 2026 | 别等Agent把任务搞砸!7B审计员AgentForesight在线抓错

NeurIPS 2026 | 别等Agent把任务搞砸!7B审计员AgentForesight在线抓错

NeurIPS 2026 | 别等Agent把任务搞砸!7B审计员AgentForesight在线抓错

研究团队提出7B审计员AgentForesight,可在多智能体任务运行中在线识别并归因关键错误,其AFTraj-2K Exact-F1达66.44,成功轨迹误报率仅2.37%。
来自主题: AI技术研报
8026 点击    2026-10-10 15:31
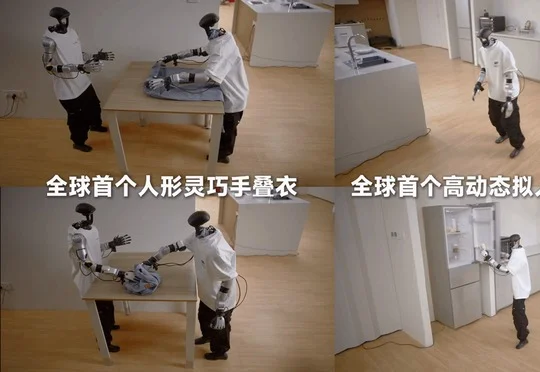
全球首次!杭州具身黑马比肩Figure,全身协同自主叠衣

全球首次!杭州具身黑马比肩Figure,全身协同自主叠衣

全球首次!杭州具身黑马比肩Figure,全身协同自主叠衣

西湖机器人升级通用大脑WR1,采用全球首创的通用大小脑双预训练系统架构,融合WM、VLA与GAE,完成双机器人协同折叠衣物及跨厨房、客厅、卧室的连续自主家务演示。
来自主题: AI资讯
8090 点击    2026-10-10 12:37
让自然语言成为世界模型的表征,英伟达Physis-Lang这样增强视频物理真实性

让自然语言成为世界模型的表征,英伟达Physis-Lang这样增强视频物理真实性

让自然语言成为世界模型的表征,英伟达Physis-Lang这样增强视频物理真实性

英伟达联合MIT和牛津大学团队提出Physis-Lang,通过物理语言描述、自进化准则和能力导向的数据检索提升视频模型的物理理解与生成表现,其Cosmos3-Super和Cosmos3-Nano在Physics-IQ Verified分列第一、第二。
来自主题: AI技术研报
7671 点击    2026-10-10 12:36
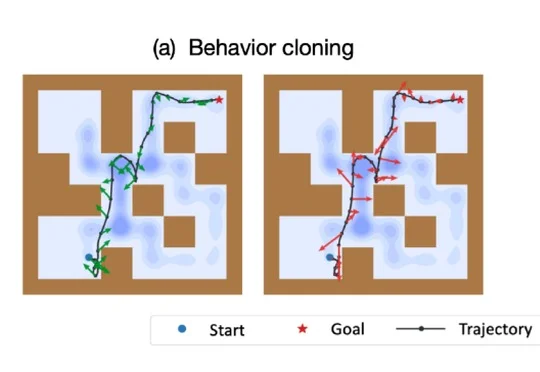
清华AIR提出高阶动作监督:聚焦一阶时序信息,10k小数据下增益显著 | NeurIPS'26

清华AIR提出高阶动作监督:聚焦一阶时序信息,10k小数据下增益显著 | NeurIPS'26

清华AIR提出高阶动作监督:聚焦一阶时序信息,10k小数据下增益显著 | NeurIPS'26

清华大学智能产业研究院(AIR)的一项NeurIPS 2026录用工作提出高阶动作监督,无需改动策略网络即可约束动作的一阶时序变化,并在OGBench及约1%数据的D4RL实验中提升小样本性能与动作平滑性。

来自主题: AI技术研报
9331 点击    2026-10-10 12:34