OCR小模型仍有机会!华科等提出VIMTS:零样本视频端到端识别新SOTA
OCR小模型仍有机会!华科等提出VIMTS:零样本视频端到端识别新SOTA通过提示查询生成模块和任务感知适配器,大一统框架VimTS在不同任务间实现更好的协同作用,显著提升了模型的泛化能力。该方法在多个跨域基准测试中表现优异,尤其在视频级跨域自适应方面,仅使用图像数据就实现了比现有端到端视频识别方法更高的性能。
来自主题: AI技术研报
10324 点击 2024-05-28 13:53

 搜索
通过提示查询生成模块和任务感知适配器,大一统框架VimTS在不同任务间实现更好的协同作用,显著提升了模型的泛化能力。该方法在多个跨域基准测试中表现优异,尤其在视频级跨域自适应方面,仅使用图像数据就实现了比现有端到端视频识别方法更高的性能。
福无双至,祸不单行,Google 又又又「翻车」了。

将一个实验性质的功能直接推向用户,谷歌有些急功近利了。
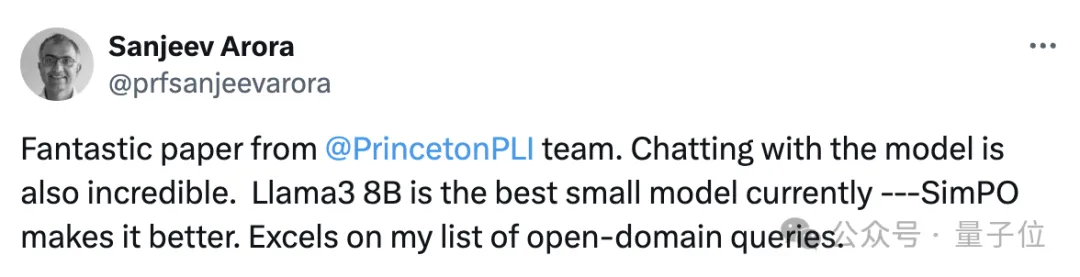
比斯坦福DPO(直接偏好优化)更简单的RLHF平替来了,来自陈丹琦团队。 该方式在多项测试中性能都远超DPO,还能让8B模型战胜Claude 3的超大杯Opus。 而且与DPO相比,训练时间和GPU消耗也都大幅减少。
TinyLLaVA 项目由清华大学电子系多媒体信号与智能信息处理实验室 (MSIIP) 吴及教授团队和北京航空航天大学人工智能学院黄雷老师团队联袂打造。清华大学 MSIIP 实验室长期致力于智慧医疗、自然语言处理与知识发现、多模态等研究领域。北航团队长期致力于深度学习、多模态、计算机视觉等研究领域。
不管你来自哪个城市,相信在你的记忆中,都有自己的「家乡话」:吴语柔软细腻、关中方言质朴厚重、四川方言幽默诙谐、粤语古雅潇洒…… 某种意义上说,方言不只是一种语言习惯,也是一种情感连接、一种文化认同。我们「上网冲浪」遇到的新鲜词汇中,有不少就是来自各地方言。当然,有些时候,方言也是一种交流「壁垒」。

最近,许久没有新动向的马斯克放出了大消息——他旗下的人工智能初创公司xAI将投入巨资建造一个超算中心,以保证Grok 2及之后版本的训练。这个「超级计算工厂」预计于2025年秋季建成,规模将达到目前最大GPU集群的四倍。
GPT-4在为人类选股时,表现竟然超越了大部分人类分析师,和针对金融训练的专业模型?在没有任何上下文的情况下,它们直接就成功分析了财务报表,这一发现让许多业内大咖震惊了。然而好景不长,有AI大牛指出研究中的bug:之所以会这样,很可能是训练数据被污染了。
本文介绍了香港科技大学(广州)的一篇关于大模型高效微调(LLM PEFT Fine-tuning)的文章「Parameter-Efficient Fine-Tuning with Discrete Fourier Transform」

为了将大型语言模型(LLM)与人类的价值和意图对齐,学习人类反馈至关重要,这能确保它们是有用的、诚实的和无害的。在对齐 LLM 方面,一种有效的方法是根据人类反馈的强化学习(RLHF)。尽管经典 RLHF 方法的结果很出色,但其多阶段的过程依然带来了一些优化难题,其中涉及到训练一个奖励模型,然后优化一个策略模型来最大化该奖励。