
AI训练一次,把我家这辈子的电都用完了。。。
AI训练一次,把我家这辈子的电都用完了。。。过去一百年里,全球电动机消耗掉的电量就占到了总发电量的一半,而现在的大模型就相当于新时代的电机。
来自主题: AI资讯
4519 点击 2023-11-04 23:18

 搜索
过去一百年里,全球电动机消耗掉的电量就占到了总发电量的一半,而现在的大模型就相当于新时代的电机。
最近,由CMU/MIT/清华/Umass提出的全球首个生成式机器人智能体RoboGen,可以无限生成数据,让机器人7*24小时永不停歇地训练。AIGC for Robotics,果然是未来的方向。
有一家公司,OpenAI、Anthropic、Cohere、Aleph Alpha(欧洲顶尖大模型公司)和Hugging Face的模型训练和微调都离不开它,NVIDIA和谷歌云(GCP)都是它的深度合作伙伴,它是支持生成式AI明星公司们训练模型的幕后英雄。

如果在 19 世纪之前的科学和自然主义作品集,上训练一个 LLM,它会不会像达尔文那样悟出进化论这个大胆假设?
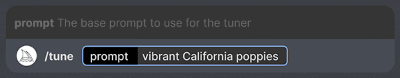
11月2日,今天 9 : 12 分,midjourney更新了“/tune” 命令,官方名称“Style Tuner”,译为“风格调谐器”,该功能可以通过您调整出满意的风格,并分享这串代码,也就意味着可以训练融合自己的风格。

在刚刚开幕的ICCAD 2023大会上,英伟达团队展示了用AI模型测试芯片,引发了业界关注。来自英伟达的研究团队开发了一种名为ChipNeMo的定制LLM,以公司内部数据为基础进行训练,用于生成和优化软件,并为人类设计师提供帮助。
即便大语言模型的参数规模日渐增长,其模型中的参数到底是如何发挥作用的还是让人难以琢磨,直接对大模型进行分析又费钱费力。针对这种情况,微软的两位研究员想到了一个绝佳的切入点
有关GPT-5的消息最近又火起来了。从最一开始的爆料,说OpenAI正在秘密训练GPT-5,到后来Sam Altman澄清;再到后来说需要多少张H100 GPU来训练GPT-5,DeepMind的CEO Suleyman采访「实锤」OpenAI正在秘密训练GPT-5。
DeepMind最新研究发现,只要模型设计上没有缺陷,决定模型性能的核心可能是训练计算量和数据。在相同计算量下,卷积神经网络模型和视觉Transformers模型的性能居然能旗鼓相当!
相比于一味规避“有毒”数据,以毒攻毒,干脆给大模型喂点错误文本,再让模型剖析、反思出错的原因,反而能够让模型真正理解“错在哪儿了”,进而避免胡说八道。