视频世界模型终于不「失忆」了!Meta提出World-T³:把记忆写进参数,单卡20.6FPS实时生成
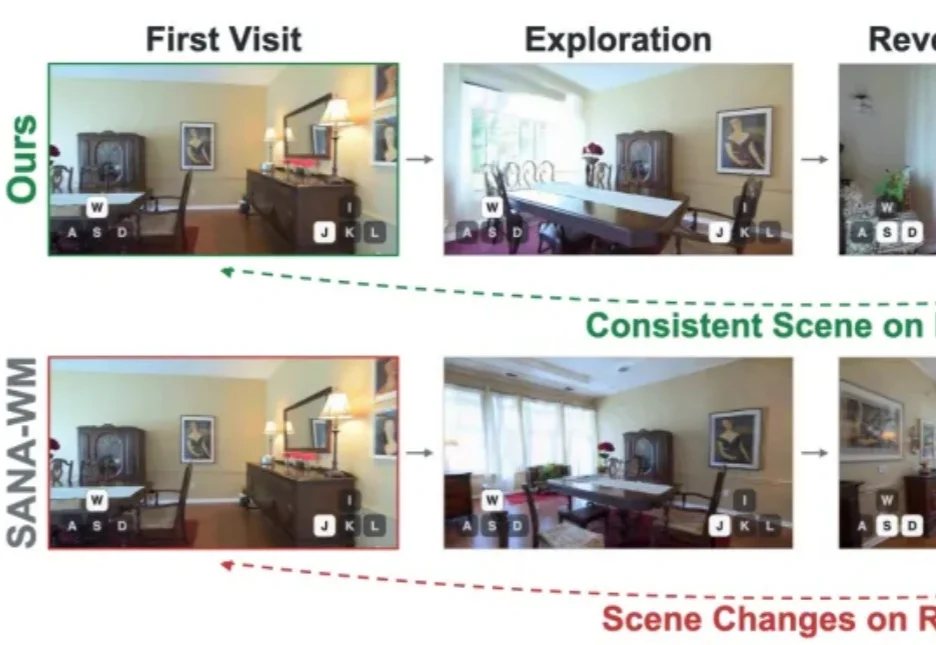
视频世界模型终于不「失忆」了!Meta提出World-T³:把记忆写进参数,单卡20.6FPS实时生成近两年,视频世界模型(video world model)成为生成式 AI 最受关注的方向之一。只需给定一张参考图和一段场景描述,模型就能根据用户输入的相机位姿或控制指令,逐帧生成出一个可以自由漫游的虚拟世界。
搜索
近两年,视频世界模型(video world model)成为生成式 AI 最受关注的方向之一。只需给定一张参考图和一段场景描述,模型就能根据用户输入的相机位姿或控制指令,逐帧生成出一个可以自由漫游的虚拟世界。
Jack Dorsey旗下Block研究团队Dessa尝试剔除文字训练、直接实现语音到语音交互,xAI的Grok Voice 3.0与OpenAI的GPT-Live则加速实时语音AI商用,但文章指出其在信息核对、隐私与办公场景中仍难取代屏幕。
用全国产算力训练的底座,破局智能语音不可能三角。
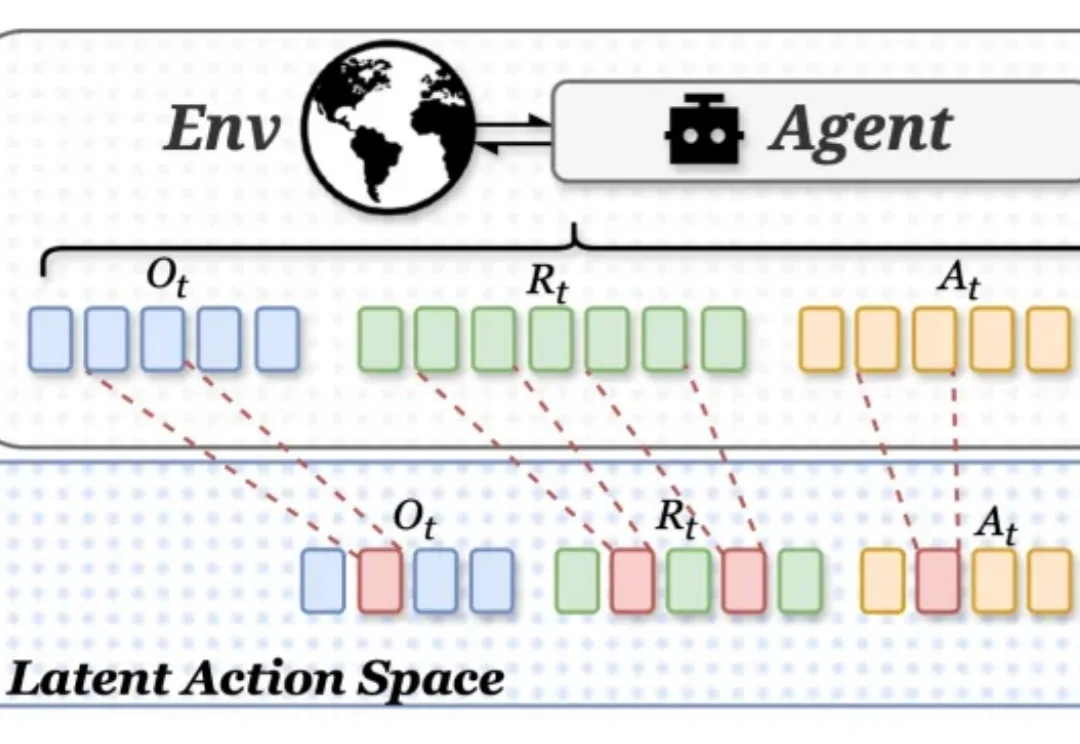
大模型Agent正在从简单问答,快速走向搜索、代码生成、网页操作和多轮工具调用。
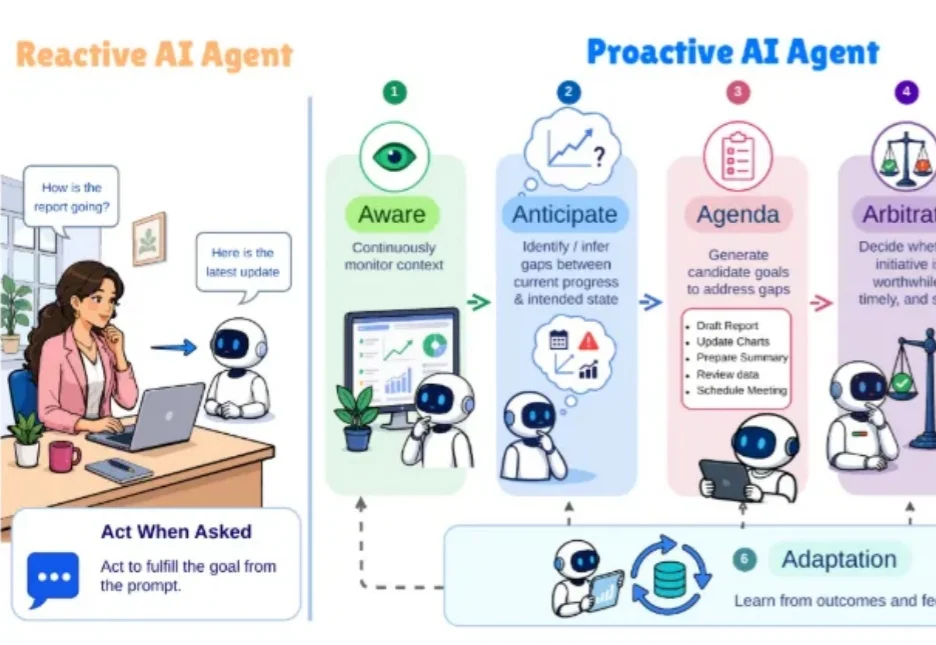
早在 1995 年,Michael Wooldridge 等学者便在智能体研究的代表性论文《Intelligent Agents: Theory and Practice》中,提出了智能体的四项核心特征:反应性(Reactivity)、社会能力(Social Ability)、自主性(Autonomy)和主动性(Proactiveness)。
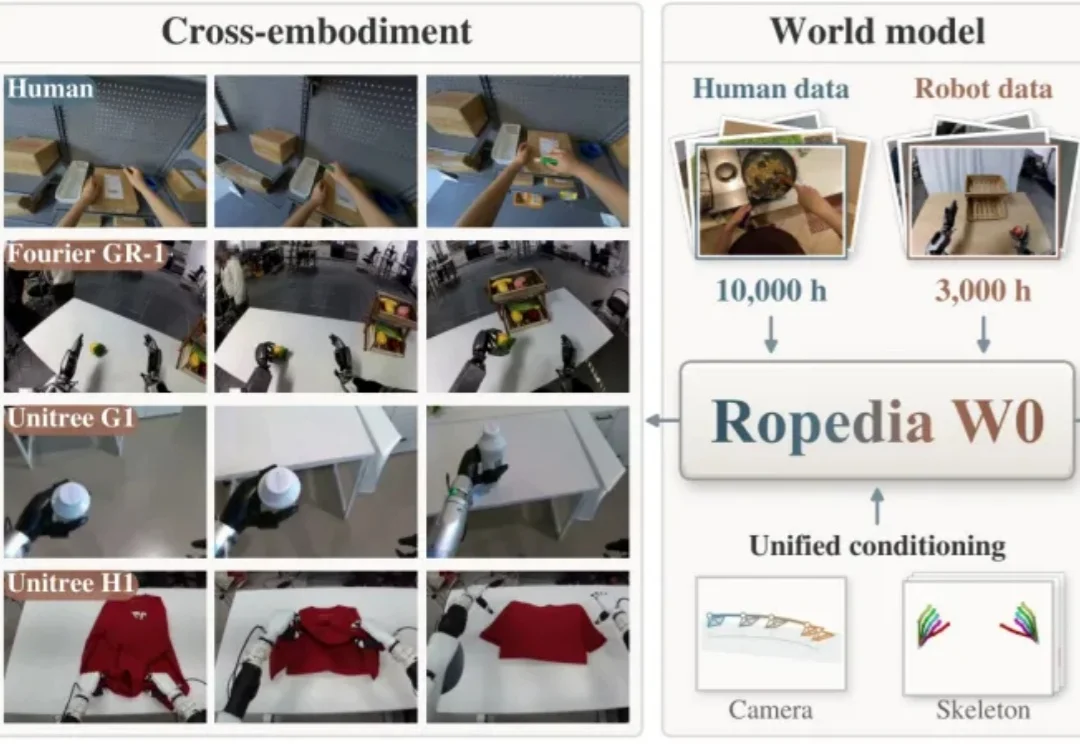
第一视角视频越来越多,研究人员怎样把这些记录变成能够改善机器人能力的训练信息?
具身智能不缺钱,也不缺演示,真正稀缺的是一条能复现的 Scaling 曲线。去年 11月,北美的 Generalist 发布 GEN-0,称首次在机器人身上观察到了这条曲线:预训练数据和算力越多,模型在下游任务上的表现就越稳定、可预测地提升。支撑这条曲线的,是超过 27 万小时的真实世界操作数据,和每周新增上万小时的采集速度。对绝大多数公司来说,曲线已经有人跑出来了,燃料却还没有。
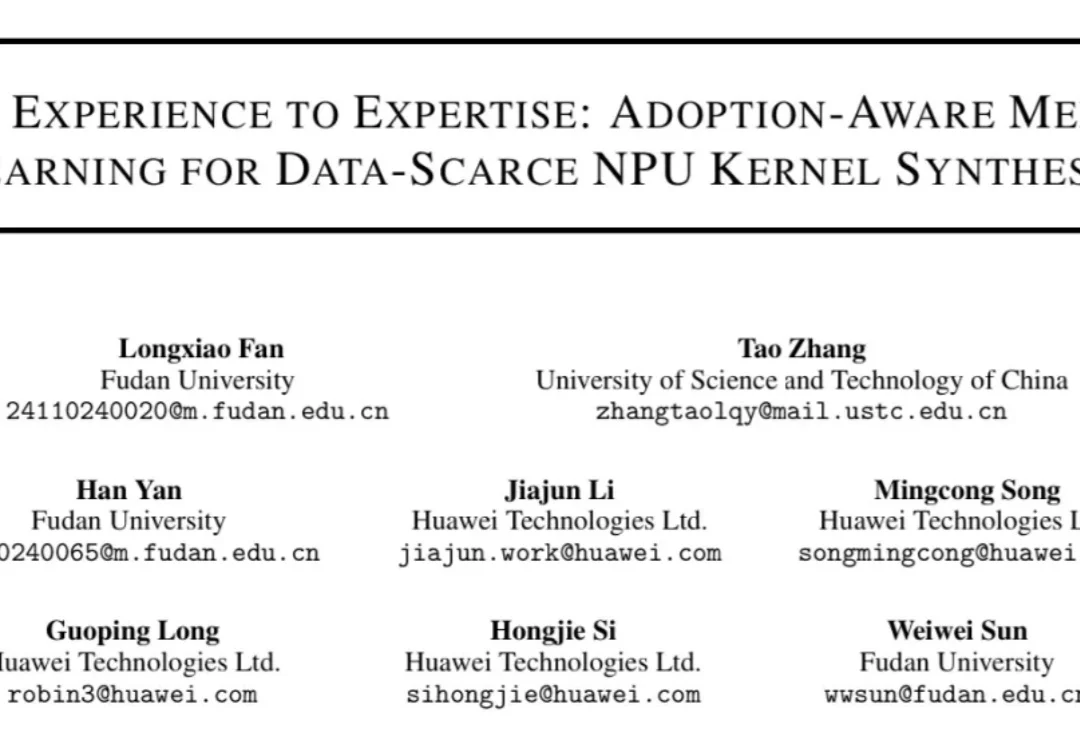
把模型部署到昇腾 NPU 上,计算逻辑确定之后,还有一道难题:怎样让底层实现充分利用硬件?同一个注意力计算,分块、搬运、并行和同步方式不同,运行时间就可能明显不同。
本周「十字路口」的嘉宾是李磊,小米 MiMo 大模型后训练研究员、香港大学在读博士。一边参与大模型训练,一边读 PhD,他和许多同学一样,面对着 AI 带来的巨大机会,也置身于飞速变化的节奏中:既兴奋,也焦虑。
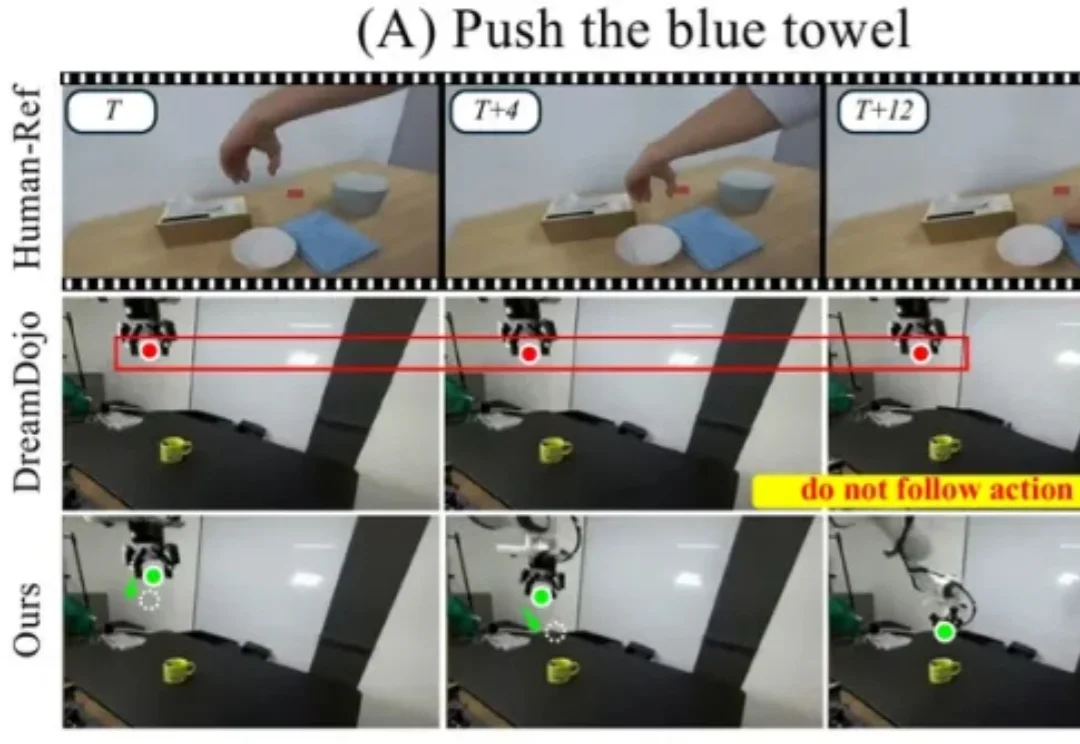
基于预训练的 Cosmos-Predict2.5-2B,SkeLAM 使用总计约 10 小时的机器人交互数据进行训练。在人手到机器人的迁移实验中,输入换成人类演示,生成视频中的机械臂仍然呈现出与演示对应的运动方向。迁移时模型参数全部冻结,没有针对这些演示额外微调。