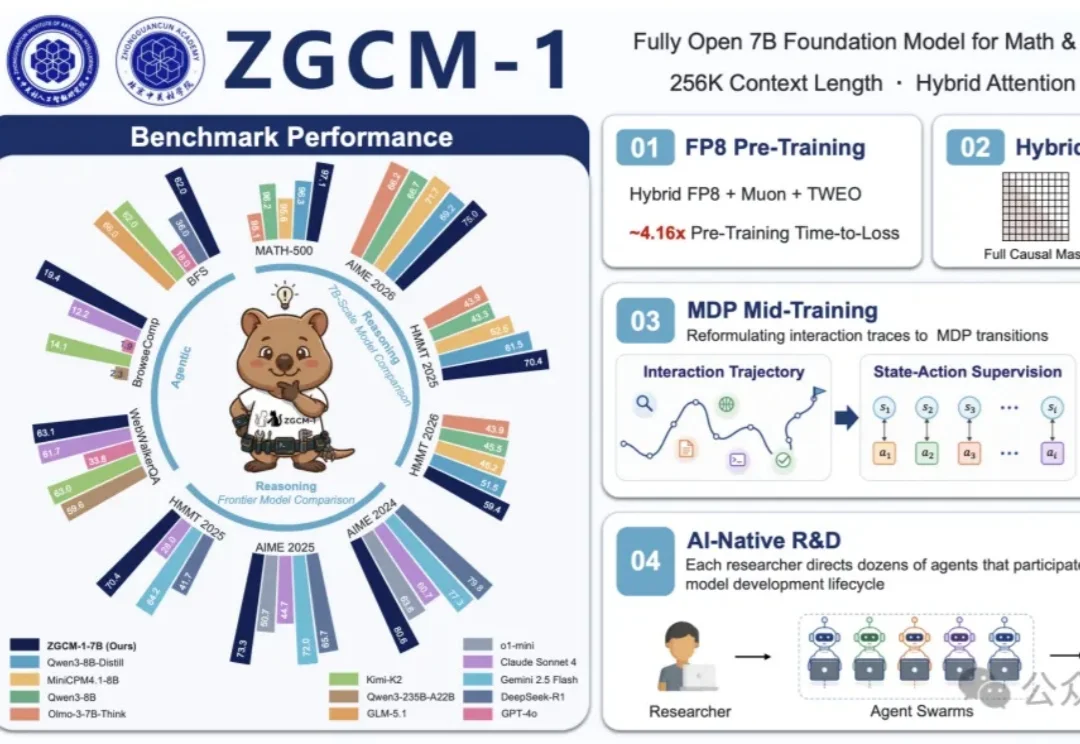
7名博士生仅用3个月从零训练7B大模型:代码+数据+训练日志全公开
7名博士生仅用3个月从零训练7B大模型:代码+数据+训练日志全公开北京中关村学院7名博士生,用一个暑假,从零训练出了一个7B大模型——ZGCM-1。
来自主题: AI资讯
9641 点击 2026-09-15 10:16

 搜索
北京中关村学院7名博士生,用一个暑假,从零训练出了一个7B大模型——ZGCM-1。
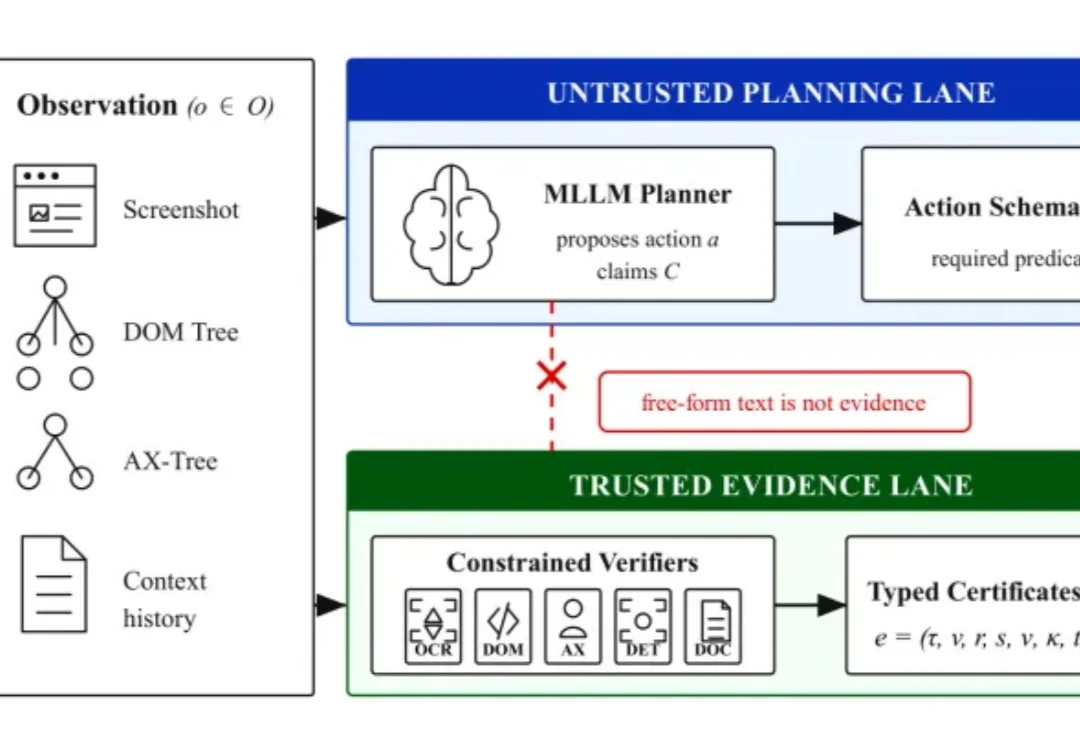
让 AI 帮忙发一封邮件,它可能把正文写得妥帖、附件整理得齐全,最后却发错了人。
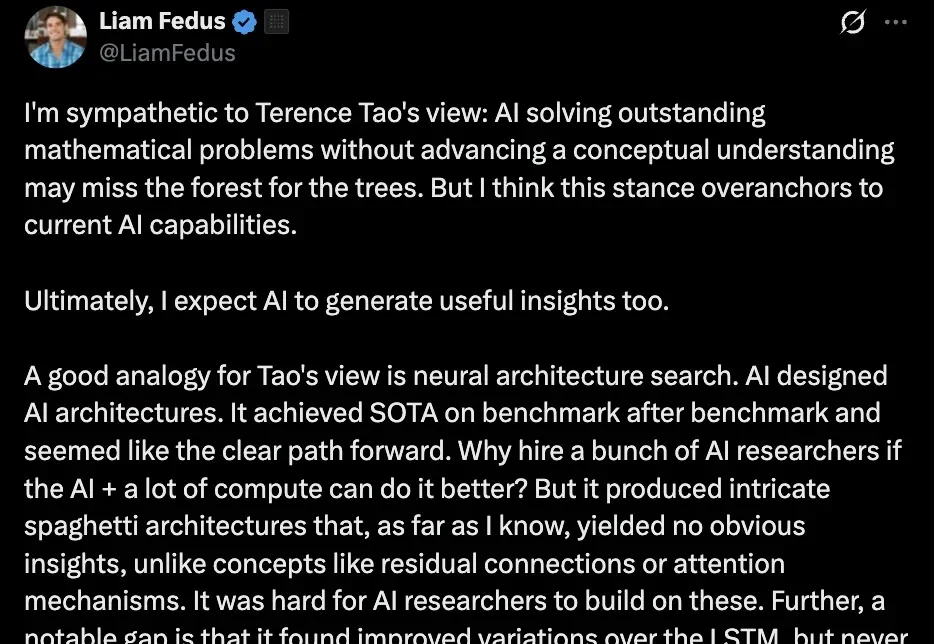
说AI毁了数学,可能还是太小瞧AI了。
据雷峰网独家获悉,一位长期在英国工作的Google Gemini预训练专家(L7-L8级别)近期加入国内某互联网大厂,被视为本轮BAT高价争抢Gemini人才以来首次"找对了人";此前多家大厂虽从Gemini硅谷办公室挖角,但因Google有意将核心预训练人才留在DeepMind英国办公室,导致此前引入的部分人选并未触及预训练核心环节。
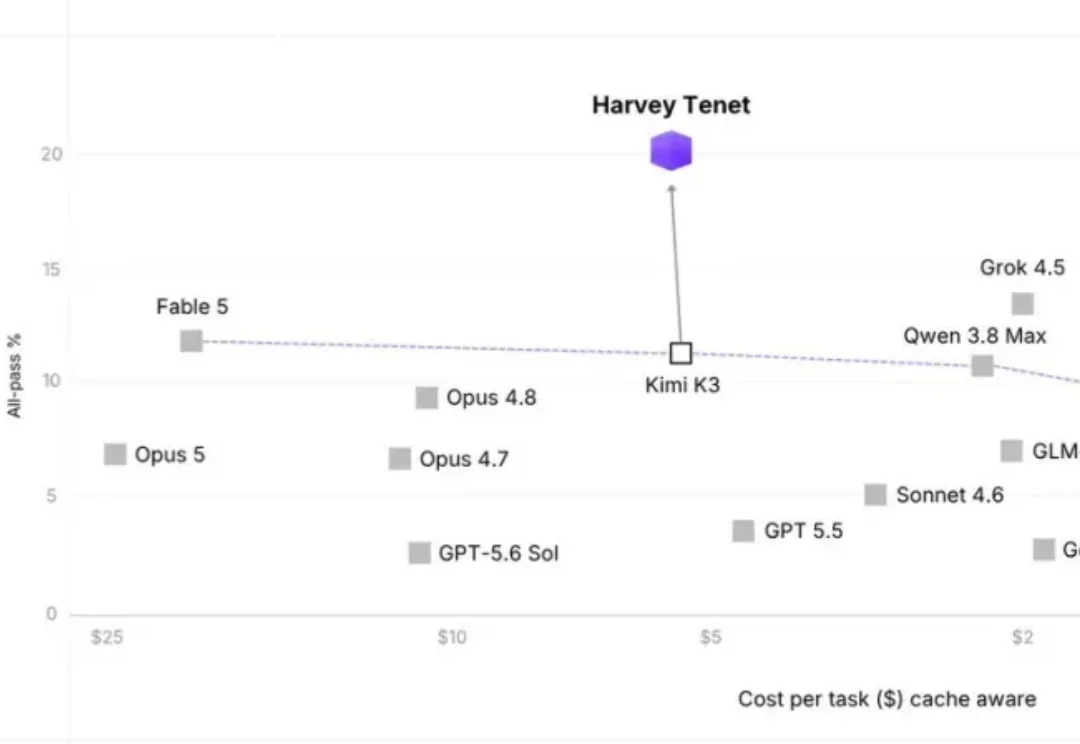
最近,越来越多应用层 AI 企业走上了一条相似的路线:用自己积累的专业知识和业务经验,训练自己的模型。
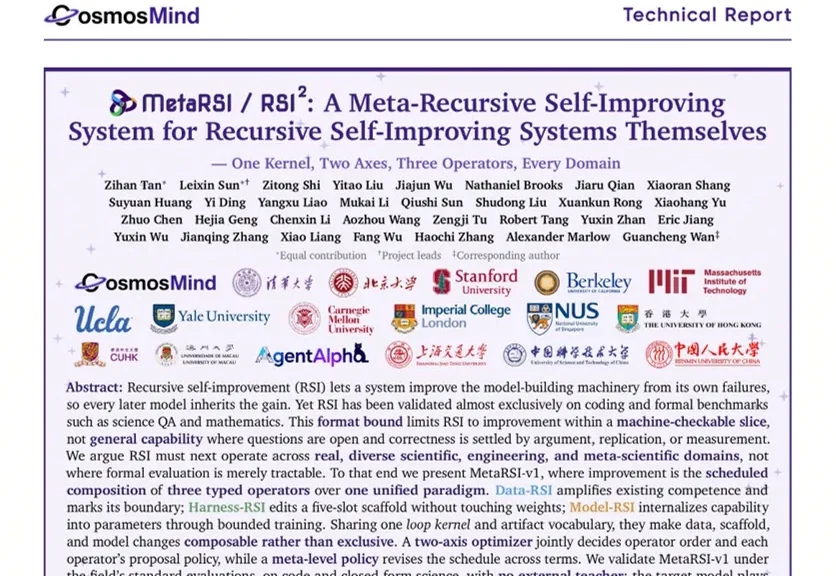
让模型自己生成训练数据、自己改写提示词、自己修复代码,这条路线被称为: 递归自我改进(Recursive Self-Improvement,RSI)。
大语言模型智能体正越来越多地进入长期陪伴聊天这类场景 —— 不再答完一个问题就走,而是和用户处成一段长久的关系。
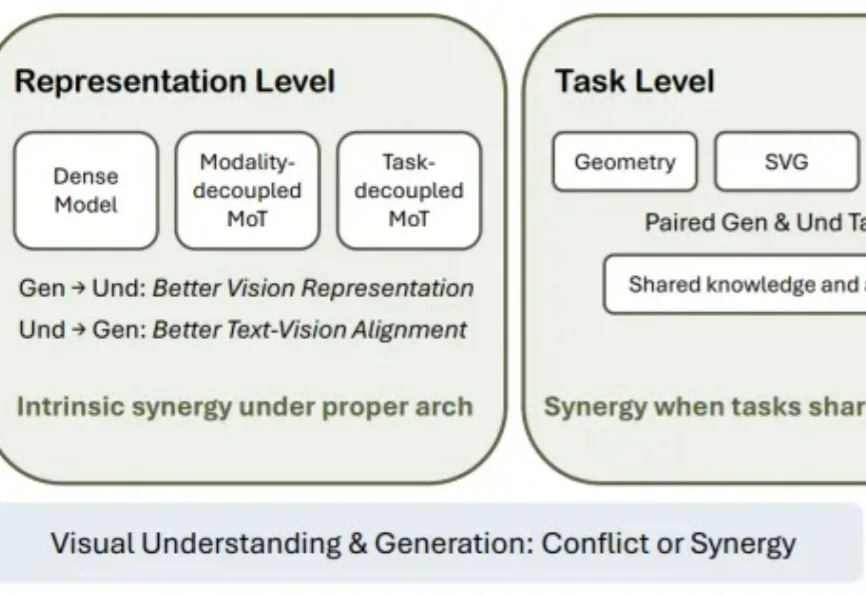
理解生成统一模型(Unified Multimodal Models, UMMs)正在成为多模态模型的重要发展方向。相比传统的理解模型 + 生成模型,UMM 希望在同一个模型中同时完成视觉理解和图像生成,让文本和图像能够在统一上下文中被理解、推理和生成。
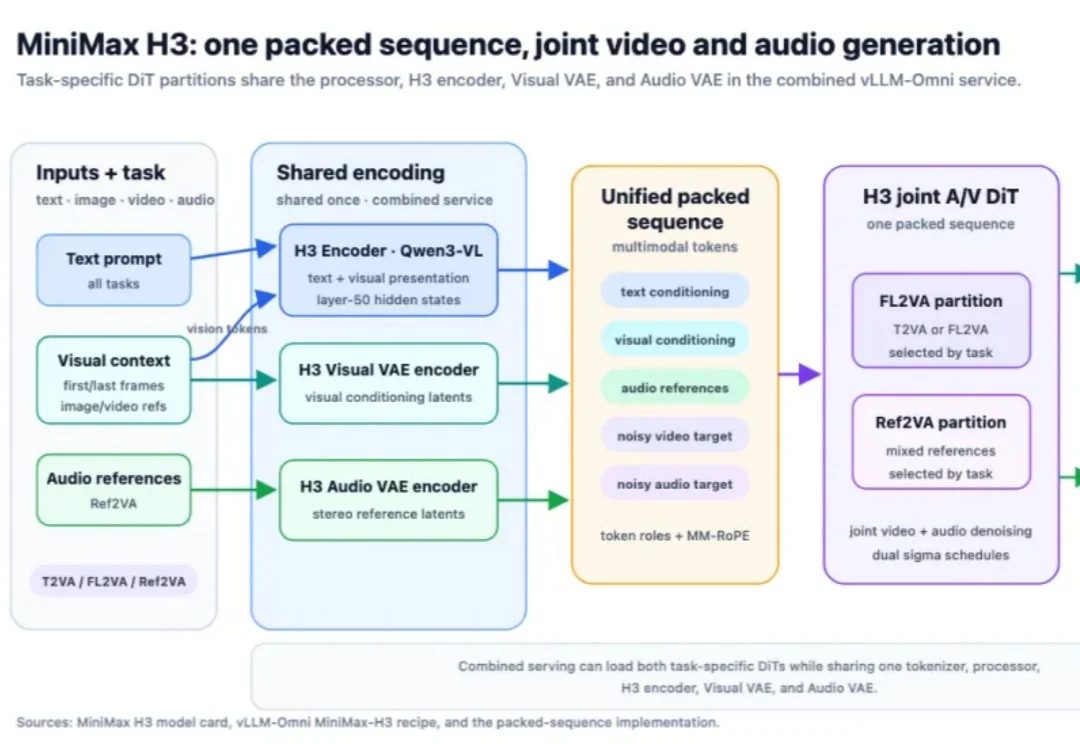
MiniMax H3 的服务是一个系统问题。一个请求要经过一个庞大的 Qwen3-VL 编码器、一个长序列的音视频 DiT、相互独立的视频与音频 VAE、设备与进程的边界,最后还要完成 H.264/AAC 的封装。只优化 DiT,其余环节的时延依然留在那里。
上市不到九个月,智谱一口气再融335亿元。