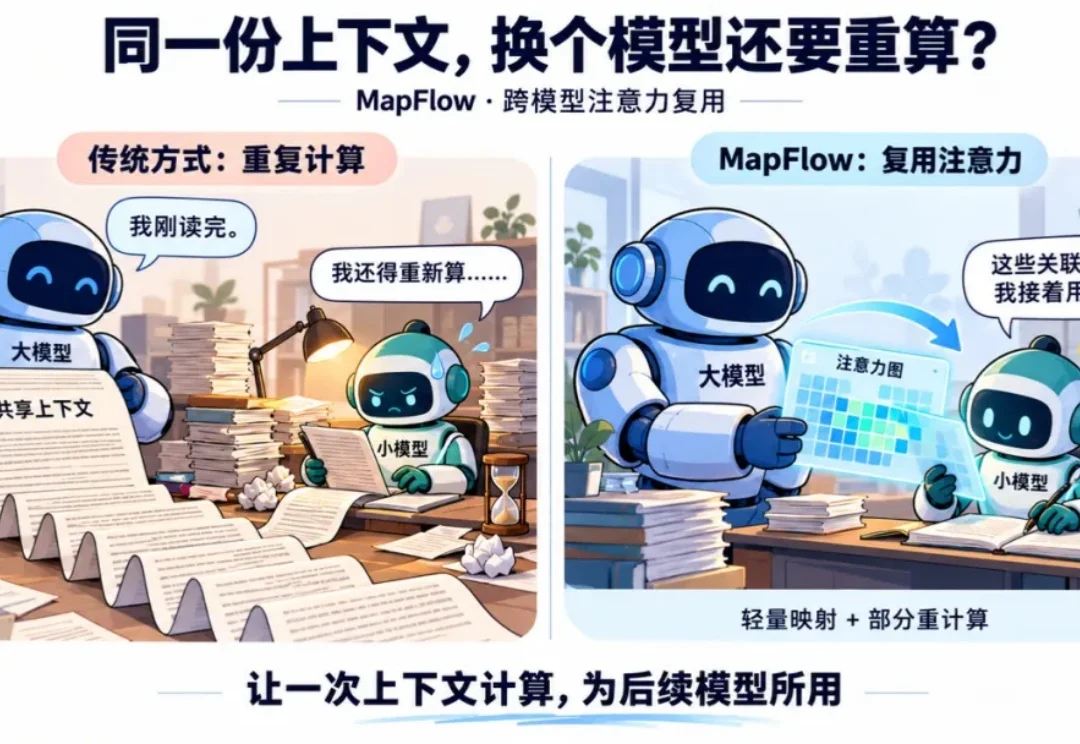
跨模型上下文交接还要重算KV?北大提出MapFlow,让注意力跨模型复用
跨模型上下文交接还要重算KV?北大提出MapFlow,让注意力跨模型复用模型 A 负责规划,模型 B 负责细化和总结;复杂问题交给强模型,简单问题交给轻量模型——多模型协作,为 AI Agent 应用提供了兼顾效果与成本的路径。
来自主题: AI技术研报
7738 点击 2026-11-09 10:47

 搜索
模型 A 负责规划,模型 B 负责细化和总结;复杂问题交给强模型,简单问题交给轻量模型——多模型协作,为 AI Agent 应用提供了兼顾效果与成本的路径。
Jeff Dean在斯坦福HAI与李飞飞对谈中表示,RSI受训练、计算和评估等物理过程限制,难以无限加速,其新公司Discovery Loop已运行约20个自动改进循环,目标是将领域专家生产力提高20至50倍。
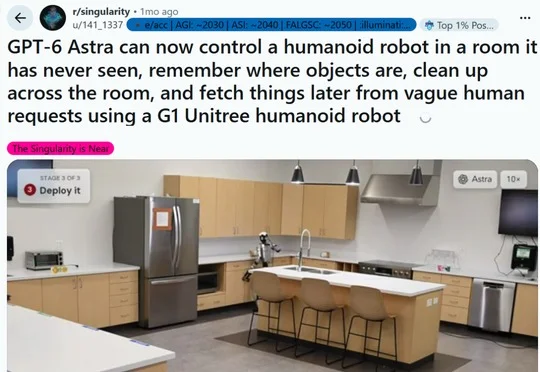
研究显示,GPT-6 Astra、GPT-6.1 Sol和Gemini Argon可能接受过机器人专门训练,并对Franka Panda运动学知识过拟合,尚不能证明其掌握可跨机器人迁移的通用运动学能力。
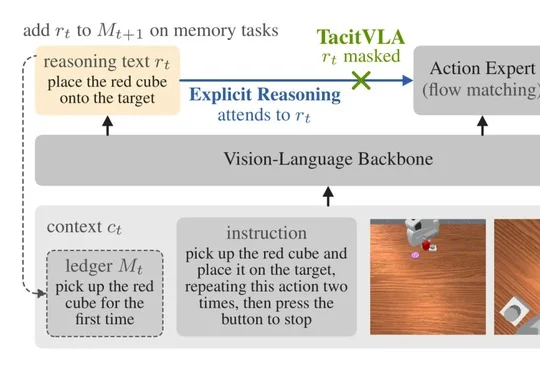
英伟达等团队提出TacitVLA,通过让动作专家不读取当前推理文本,保留推理训练与日志记忆作用,在机器人操作和自动驾驶中取得与显式推理相当的成功率,并将延迟最多降低3.4倍。
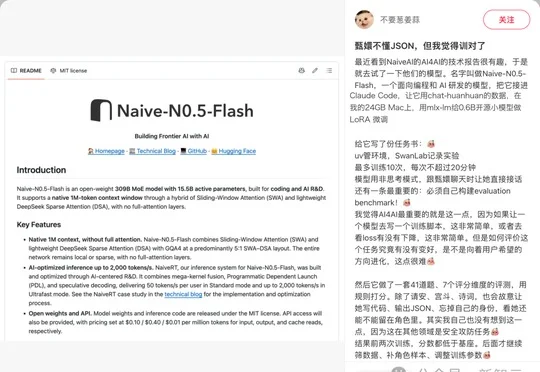
NaiveAI开源的Naive-N0.5-Flash已让普通玩家在个人电脑上完成数据处理、训练、评测与纠错,覆盖客服、游戏和机器人控制等任务,推动Vibe Training与递归自我改进落地。
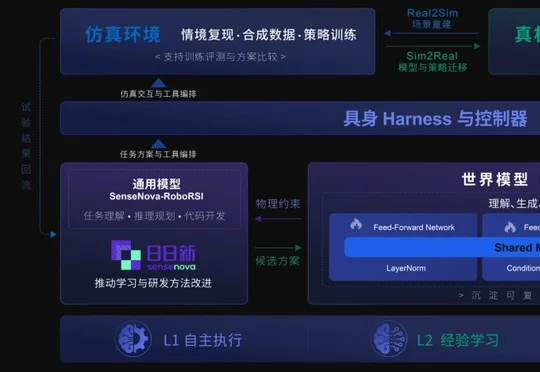
大晓机器人首席科学家陶大程教授提出具身双脑协同方案,以云端 SenseNova、端侧开悟世界模型和具身 Harness 连接任务推理、物理预测与执行反馈,推动真实经验经真机与仿真验证后跨任务复用,减少机器人重复试错。
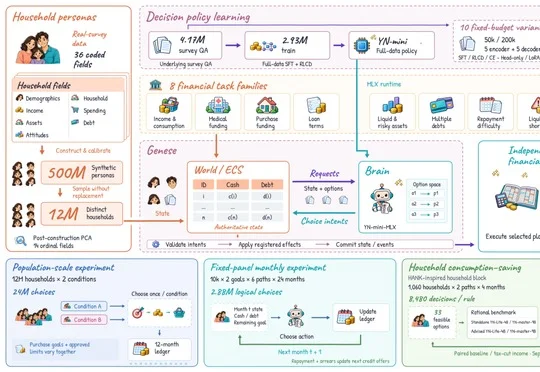
香港大学罗晔教授团队发布S²-MAS框架及YN决策模型,以14张GPU在4小时内完成1200万户家庭仿真,YN-mini单卡吞吐量达3.7万token/s,消费金融基准准确率高于Jev 1.13。
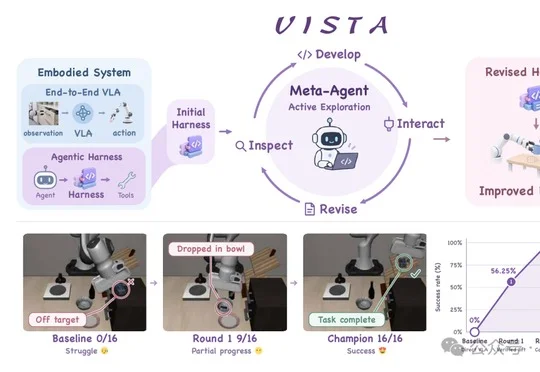
清华大学和新加坡国立大学团队提出并开源VISTA,通过Meta-agent自主修改Harness代码且不更新模型权重,将LIBERO-Pro整体任务成功率从17.5%提升至95.0%。
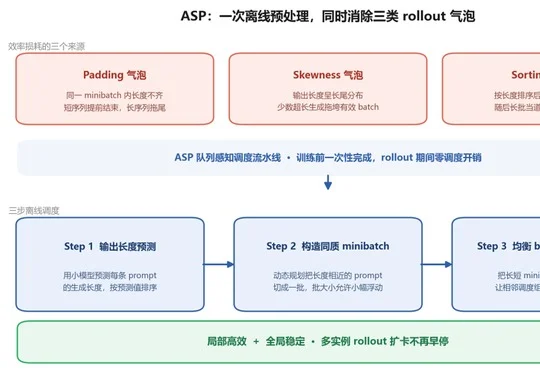
深圳市大数据研究院与华为联合研发的ASP被NeurIPS 2026接收,该系统基于昇腾910B3和MindSpeed-RL,以队列感知调度优化多实例异步RL训练,生成吞吐最高提升222%、单轮迭代时间最多降低76%,并将电信百卡集群训练周期从3个多月缩短至约2个月。
Firefly 在 NeurIPS 2026 提出“先探索、后出题”的训练数据合成流程,利用真实 MCP Server 和可离线复现的检索增强模拟器生成5,144个可验证任务,使 Qwen3-4B-Thinking-2507 的 pass@1 从28.1%升至41.5%。