
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
现有的音视频奖励模型,能通过局部指标捕捉到画质或同步上的优势,却往往忽略声音失真、台词与提示不符,以及动作和语音配合不自然等问题。
画面、声音、文本匹配和同步性可以分别评分,但这些分数不一定等于人的整体感受。更麻烦的是,当它们被用于强化学习后训练,模型可能学会“刷高分”,却没有真正改善生成质量。这也是联合视频-音频生成目前最大的难题。
来自复旦大学、上海创智学院的研究团队因此提出VA-Judger。它从人类对完整视频-音频结果的偏好中学习,不仅判断哪个结果更好,还解释人为什么更喜欢它。
现有方法通常使用VideoAlign评价视频质量和文本-视频一致性,用AudioBox评价音频质量,用CLAP衡量文本-音频匹配,再用SynchFormer检测同步。这些“专项裁判”擅长诊断局部问题,却难以判断组合后的内容是否合理。
例如,一段视频可能同步得很准,但声音并不属于画面中的事件;画面可能清晰精美,却遗漏了提示要求的关键动作;文本、画面和声音单独看都没有明显问题,放在一起却可能语义冲突、情绪不符或事件不完整。
当这类指标直接充当强化学习奖励时,奖励函数会决定模型努力的方向。片面的同步分或视觉分不断上升,可能只说明模型越来越会迎合指标。VA-Judger则直接学习人类对完整结果的成对偏好,同时比较提示词匹配、音画一致性、音频质量、视频质量和内容完整性五个维度。它的价值并非简单替代各项专业指标,而是把这些信号放回同一视听语境中,判断哪些问题真正影响人的最终选择。
训练这样的裁判,首先需要高质量偏好数据。研究团队从YouTube、Bilibili、电影和电视剧中收集了一万多个真实视听片段,裁剪为5到10秒,覆盖多人对话、旁白、音乐、环境氛围、环境事件及演讲等场景。
Qwen3.5-Omni先为片段生成细粒度视听描述,记录人物、动作、对白、环境声及其对应关系。随后,Qwen将描述改写成自然、可直接用于生成的提示词,多个联合音视频模型再根据这些提示生成候选结果。这样得到的提示不只描述画面中出现了什么,也交代声音在何时、由什么事件产生,为后续判断音画是否真正对应提供了更清晰的依据。
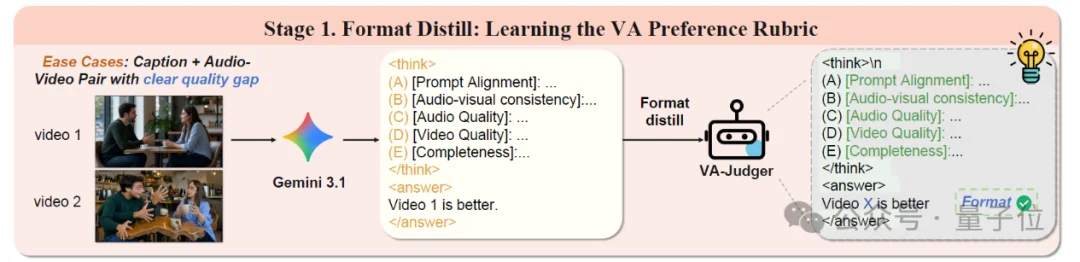
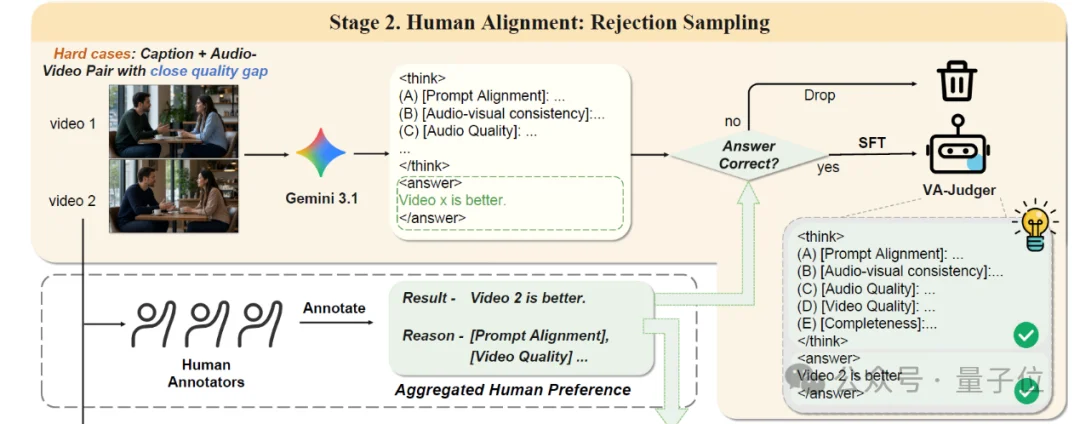
数据被分成两类。Easy Pair主要比较不同模型的输出,质量差距明显,帮助VA-Judger先学会评审规则并冷启动。Hard Pair则来自同一模型、同一提示词和不同随机种子,两个候选更加接近,迫使模型关注细微差异。这种搭配既保证了入门样本的清晰度,也避免训练停留在过于简单的模型识别题上,更接近真实应用中对多个相似候选进行筛选的场景。
标注者不仅选择总体更好的视频,还指出促成选择的关键质量维度。最终形成的VAPref-10K包含约9000个提示和一万多组成对偏好,既告诉模型“谁更好”,也告诉它“为什么更好”。
VA-Judger采用由易到难的三阶段训练。
第一阶段使用Easy Pair冷启动,由Gemini 3.1 Pro提供结构化格式监督。模型学习按照五个维度分析、评分并给出最终选择。这个阶段相当于先建立统一的评审表,让模型明确应该观察什么、如何组织理由,而不是只输出一个缺乏依据的胜负答案。
第二阶段转向Hard Pair。研究团队采用人类验证的拒绝采样,只保留最终选择与人类标签一致的结构化分析,得到约4500条困难样本,使模型在两个质量接近的结果之间对齐人类偏好。训练重点也由识别明显缺陷,转向捕捉口型、声源、动作完整性和语义一致性等更细微的差别。
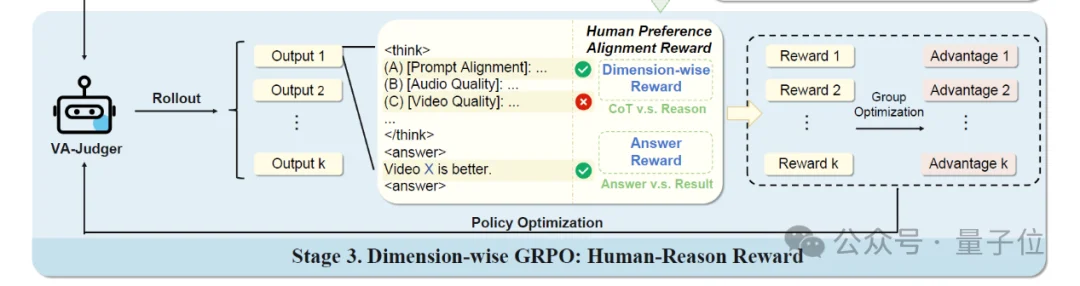
第三阶段引入Dimension-wise GRPO。奖励不仅检查最终选择是否正确,还检查在人类指出的关键维度上,被偏好的候选是否获得更高分。这样可以减少“答案选对了,理由和评分却相互矛盾”的情况。换句话说,模型不仅要押中人类会选哪一个,还要把决定这次偏好的关键因素判断正确。
这三个阶段的作用首先体现在奖励模型自身的判断能力上。VA-Judger-Bench由400组Easy Pair、250组域内Hard Pair和500组域外样本构成,专门衡量模型选择与人类偏好的吻合程度。单项指标的总体准确率最高仅为56.88%;经过Easy SFT、Hard SFT和分维度GRPO后,VA-Judger的总体准确率依次达到62.35%、65.91%和68.43%。这里的68.43%是奖励模型的偏好预测准确率,并非生成视频的质量分数。
研究团队进一步将VA-Judger接入LTX-2的后训练。每个提示先生成8个候选,再进行28次两两比较。每个候选与其余7个候选交手,形成一场“循环赛”,其多次比较得分被汇总为更稳定的奖励。
其中,音频质量用于更新音频分支,视频质量用于更新视频分支,提示词匹配、音画一致性和完整性则作为共享奖励,同时作用于两个分支。模型主干保持冻结,只训练LoRA参数,以降低训练成本和不稳定性。这种有针对性的奖励分流,也能避免某一项局部指标同时把音频和视频两个分支带向错误方向。
生成效果则在另一套实验中验证。在随机抽取的200条JavisBench提示上,LTX-2加VA-Judger在13项JavisBench指标中有11项排名第一,在7项补充指标中有6项排名第一。
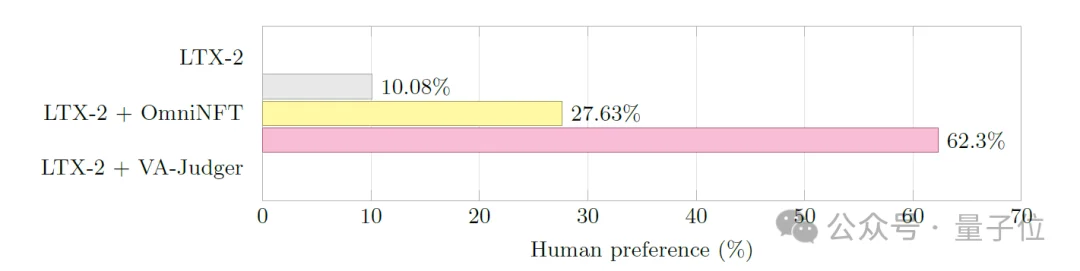
更关键的是,人类三选一实验给出了直观结果:LTX-2、LTX-2加OmniNFT和LTX-2加VA-Judger的偏好率分别为10.08%、27.63%和62.30%。也就是说,在三种结果同时呈现时,加入VA-Judger后训练的版本获得了接近三分之二的选择。这说明它带来的提升并不只存在于自动分数里,也体现在观众能够直接感知的整体视听质量上。
联合音视频生成需要的不只是更多指标,而是一个能理解完整视听事件、并与人类偏好一致的奖励信号。VA-Judger让奖励模型从“分别打分”走向“整体判断”,也为联合视频-音频生成的后训练提供了更可靠的方向。对于未来的生成系统而言,更接近人的整体感受,可能比继续堆叠彼此割裂的单项分数更重要。
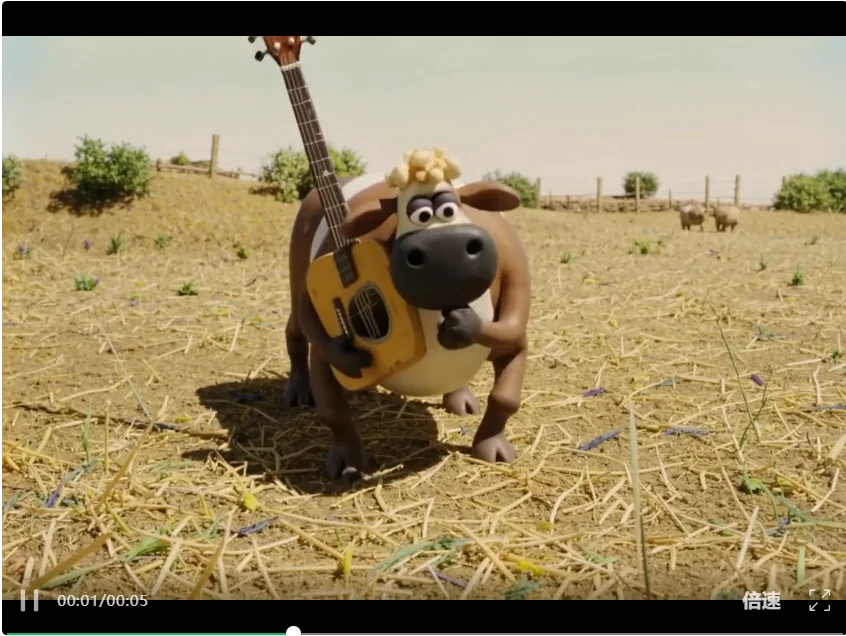
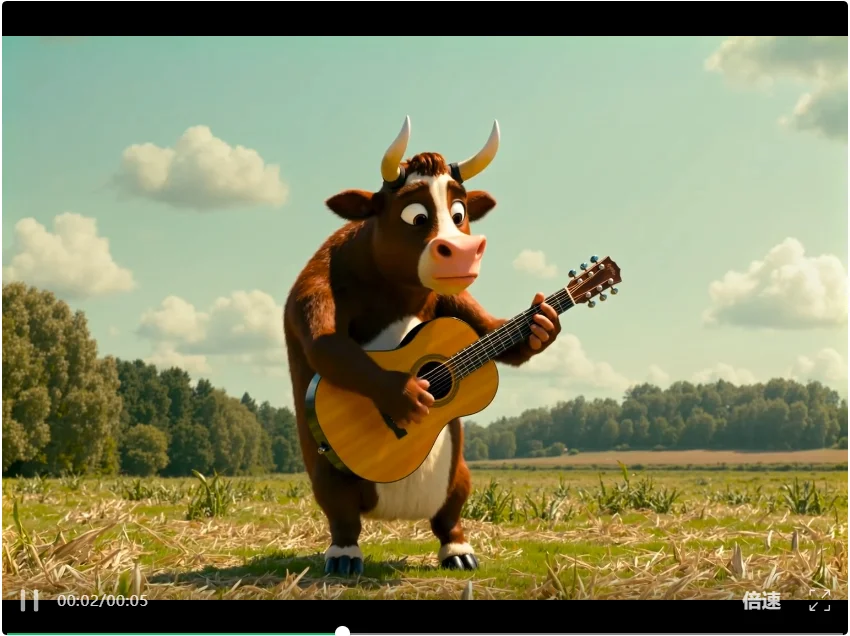
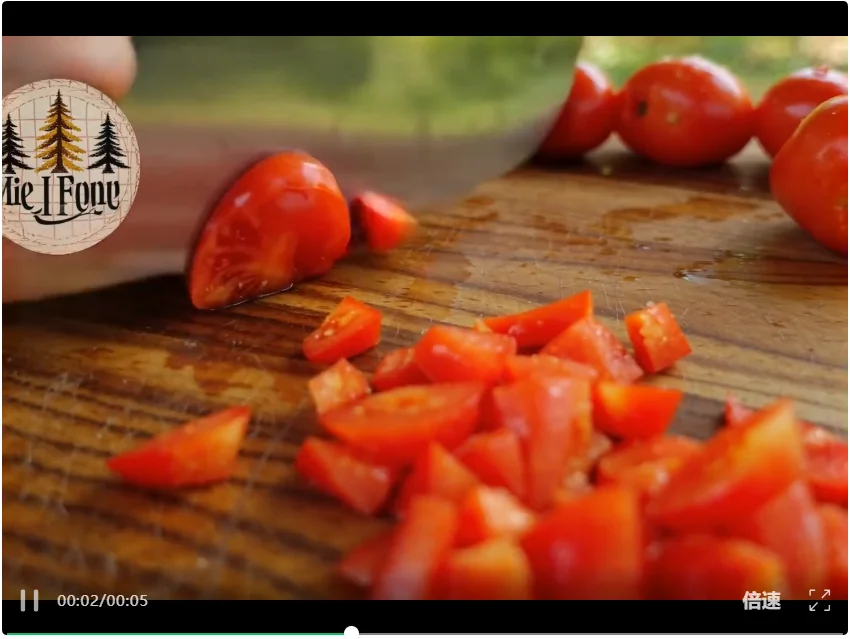
效果对比(上:ltx2;下:ours):
case1:
case2:
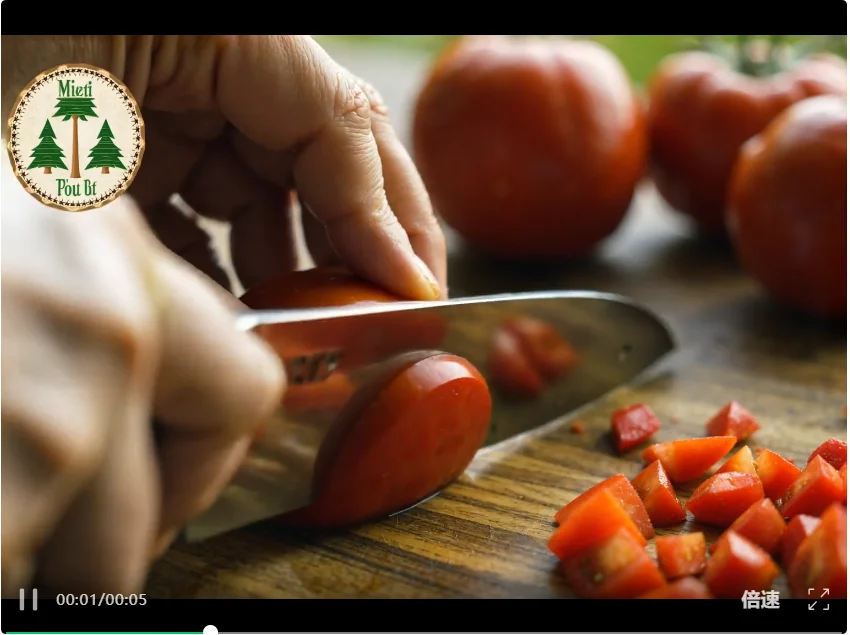
case3:
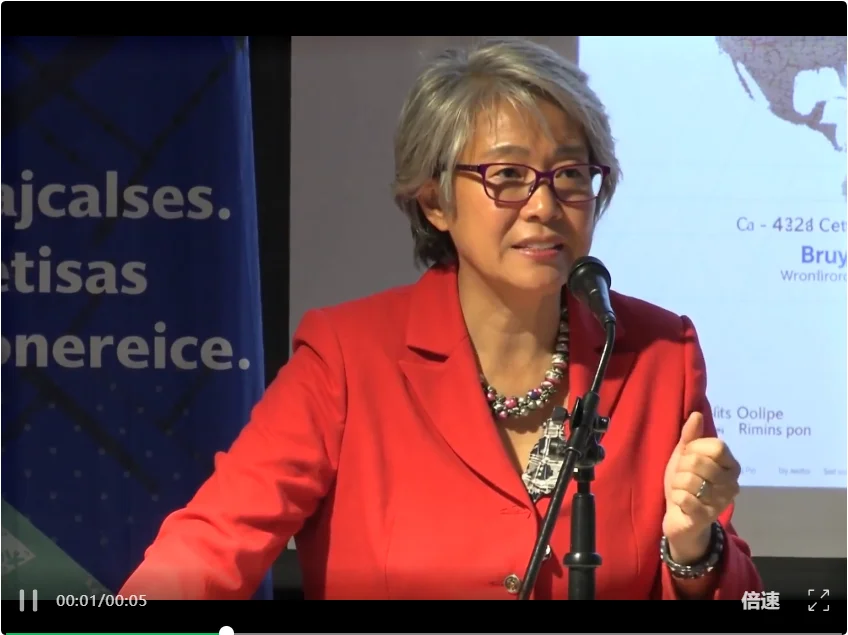
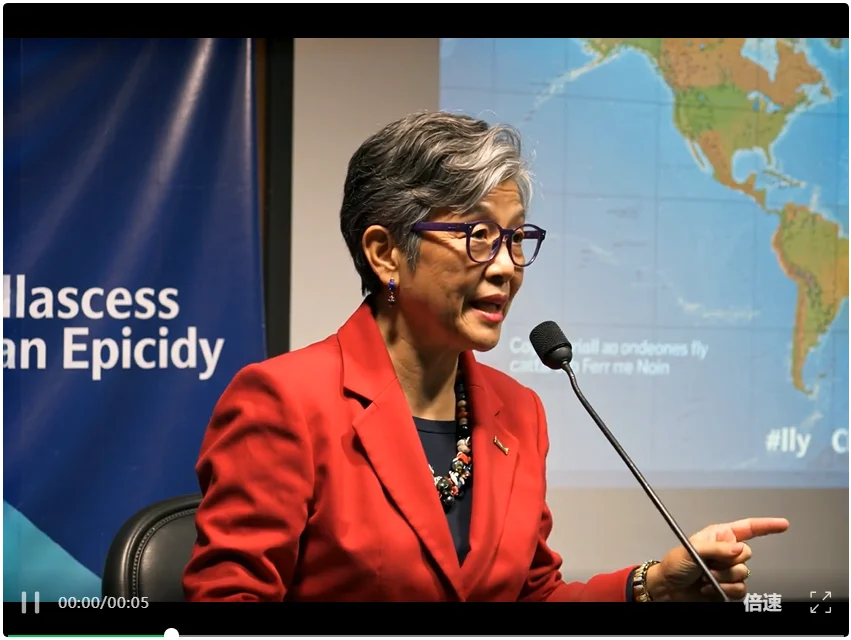
case4:
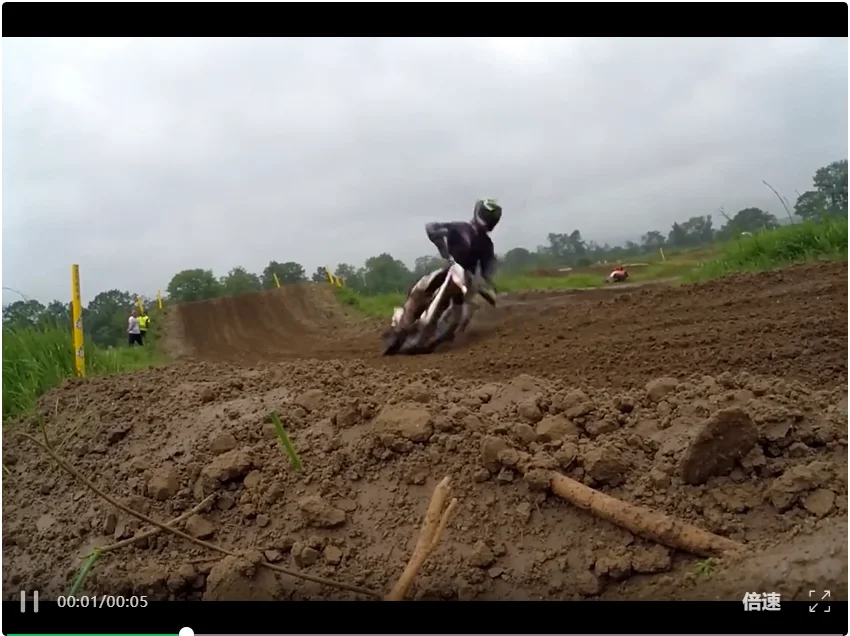
论文标题:VA-Judger: Reward Modeling from Human Preference Feedback for Joint Video-Audio Generation
论文地址:https://arxiv.org/abs/2608.18607
项目主页:https://sharelab-sii.github.io/VA-Judger/
项目代码:https://github.com/ShareLab-SII/VA-Judger
项目Demo:https://www.bilibili.com/video/BV1Sz8c68EV5/
文章来自于"量子位",作者 "VA-Judger 团队"。


【开源免费】DeepBI是一款AI原生的数据分析平台。DeepBI充分利用大语言模型的能力来探索、查询、可视化和共享来自任何数据源的数据。用户可以使用DeepBI洞察数据并做出数据驱动的决策。
项目地址:https://github.com/DeepInsight-AI/DeepBI?tab=readme-ov-file
本地安装:https://www.deepbi.com/
【开源免费】airda(Air Data Agent)是面向数据分析的AI智能体,能够理解数据开发和数据分析需求、根据用户需要让数据可视化。
项目地址:https://github.com/hitsz-ids/airda
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
