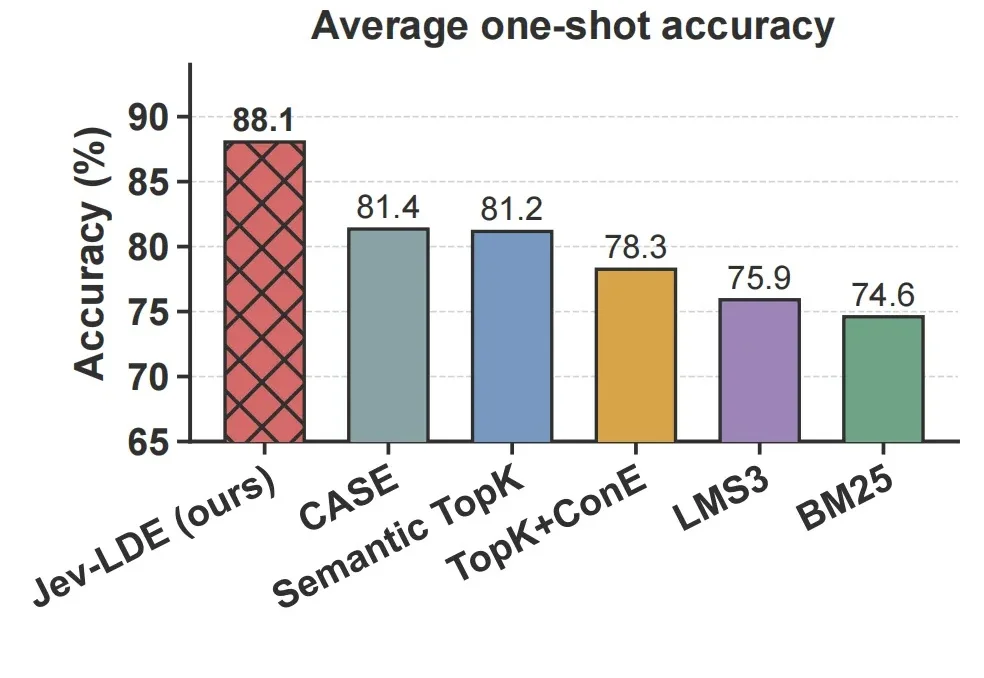
清华提出Jev-LDE:ICL示例只改一次,1-shot平均准确率就能暴涨
清华提出Jev-LDE:ICL示例只改一次,1-shot平均准确率就能暴涨大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。
来自主题: AI技术研报
7882 点击 2026-10-14 15:27

 搜索
大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。
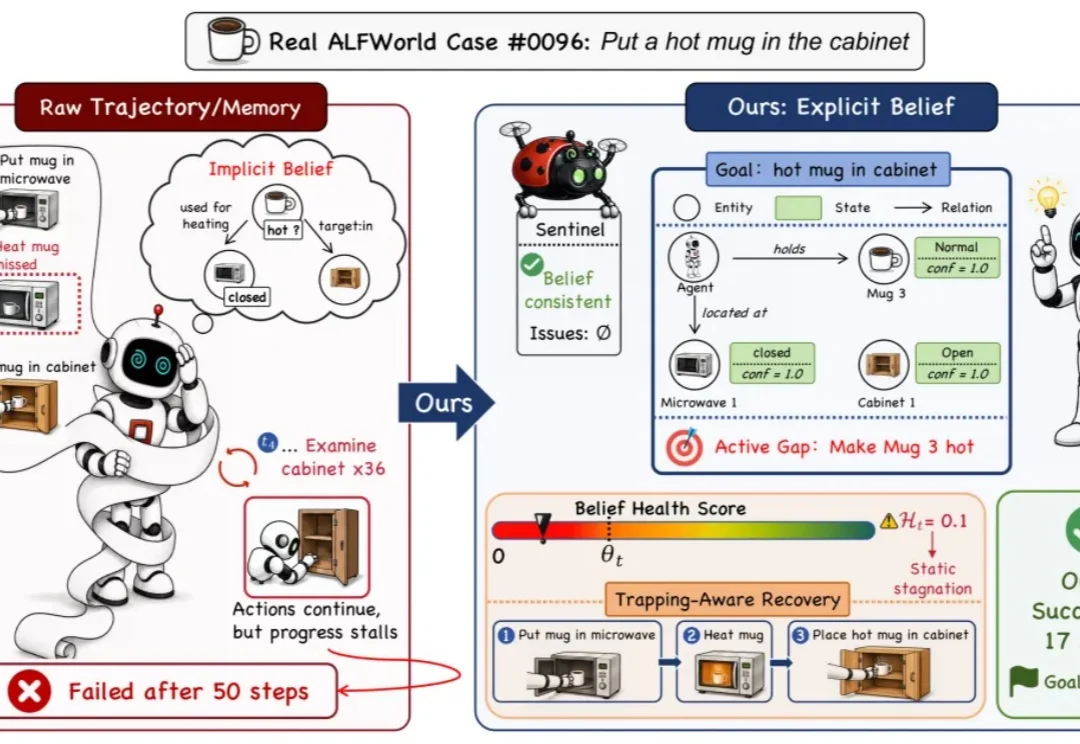
任务很简单:把一个加热后的杯子放进柜子。一个智能体先把杯子放进微波炉,再放进柜子,随后陷入反复查看柜子的循环。这个无效行为重复了 36 次,直到耗尽行动预算,任务仍然没有完成。
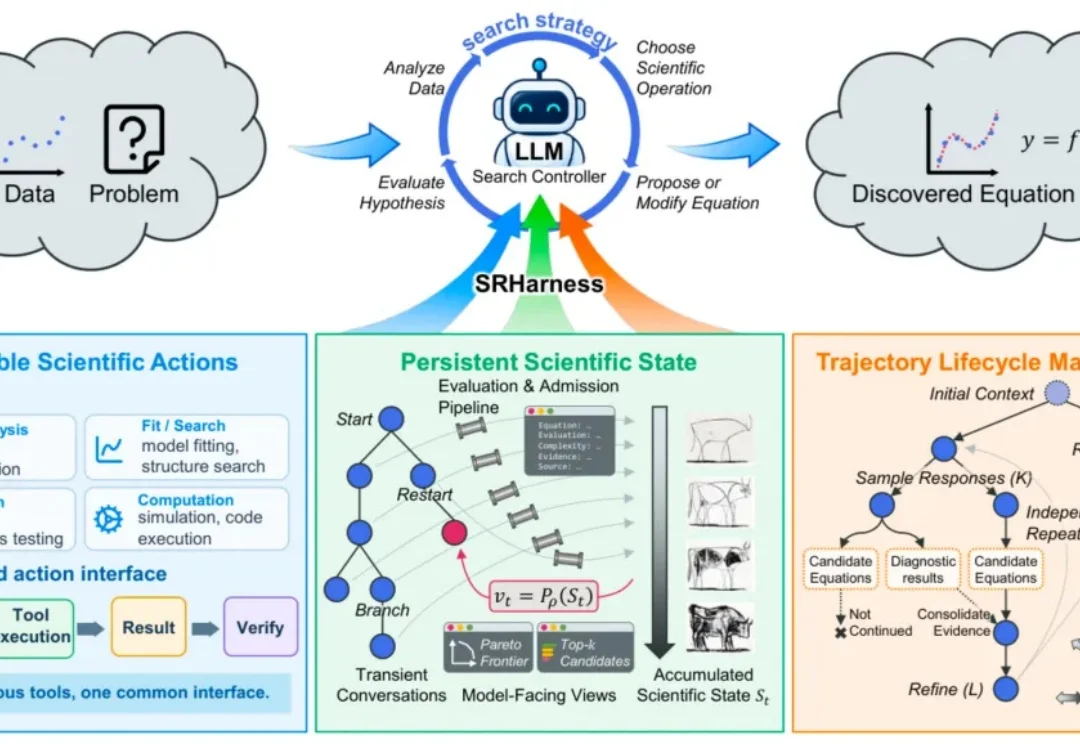
近日,清华大学电子工程系数据科学与智能实验室在 AI for Science 方向提出面向智能体符号回归(agentic symbolic regression)的运行时框架 SRHarness [1],让 AI 更可靠地从观测数据中发现公式;同时构建机制发现基准 MechBench [2],系统评测 AI 能否进一步揭示公式背后的机理。
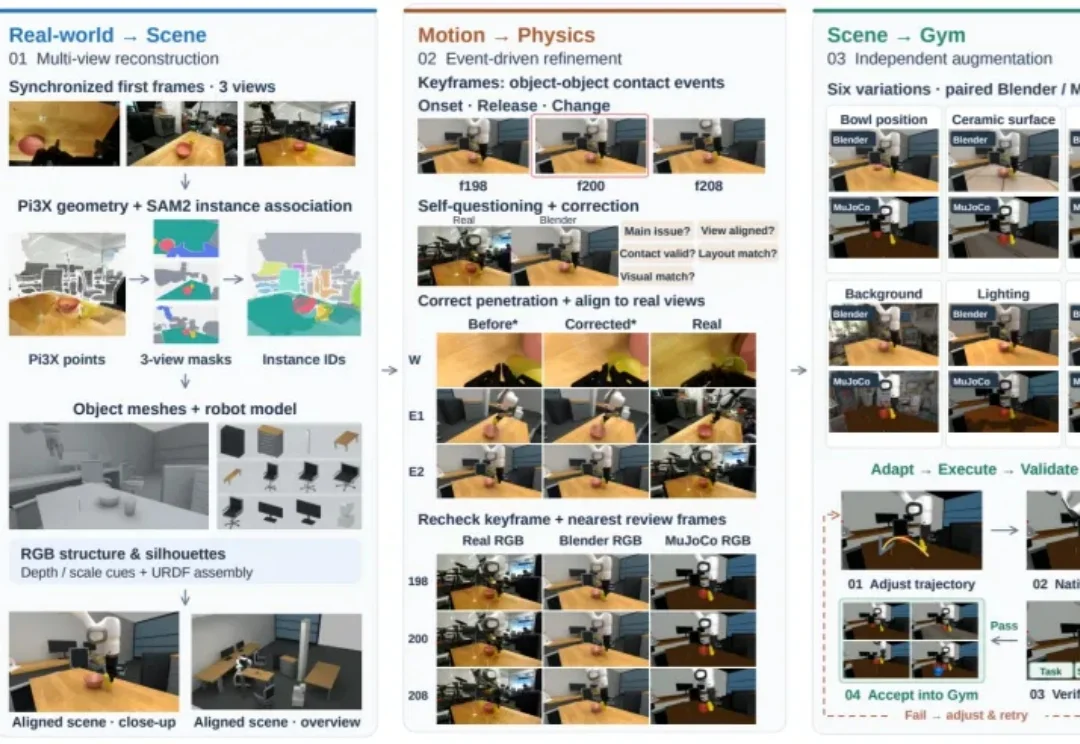
把杯子放进微波炉里,这一人类几乎不用思考的日常动作,机器人却可能在杯子放不稳、夹爪碰到门框这样的细节上频频出错。
最近,来自牛津大学&莫纳什大学&布里斯托大学的团队提出了交互式视频世界模型 Oneira,将这类模型从开放式的生成走向开放世界的交互。
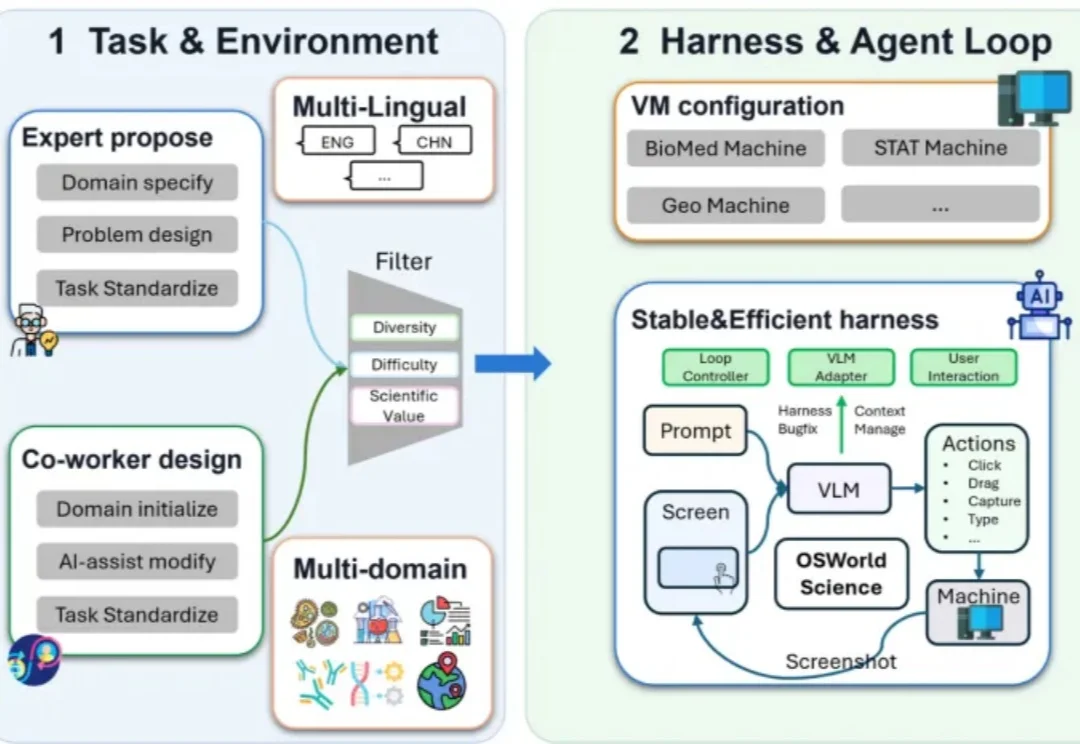
一道科学问题,AI 可以给出解释,列出步骤,甚至写出分析代码。
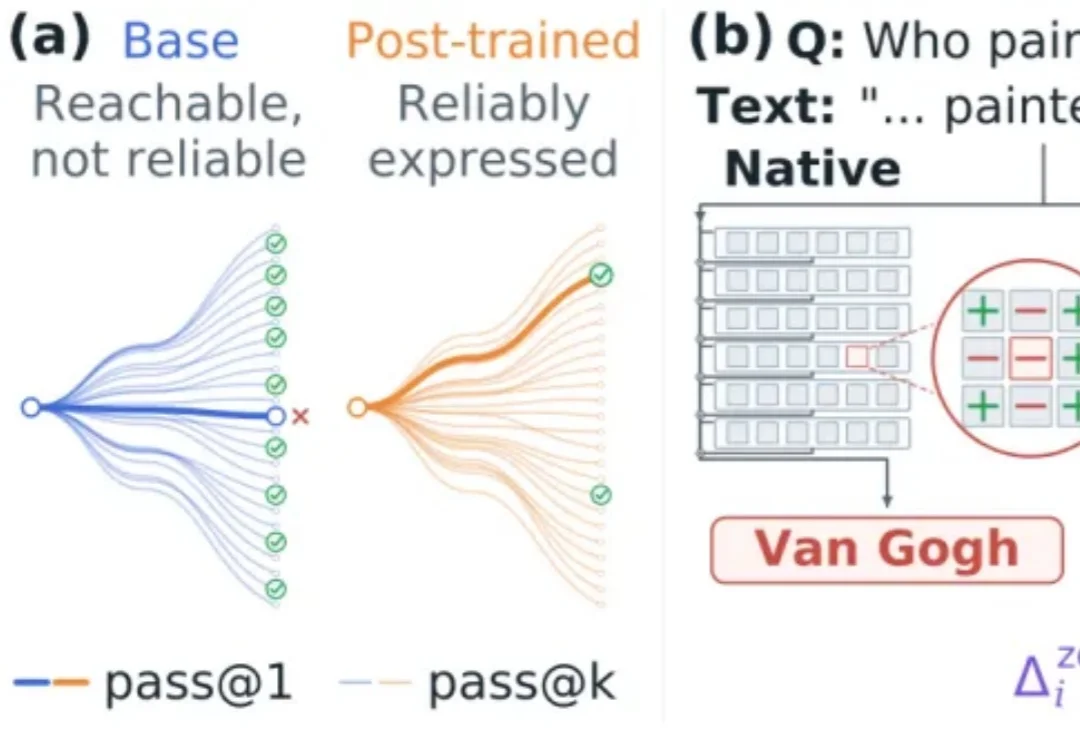
让大模型稳定地按人们的期望行动,是偏好对齐的核心目标。
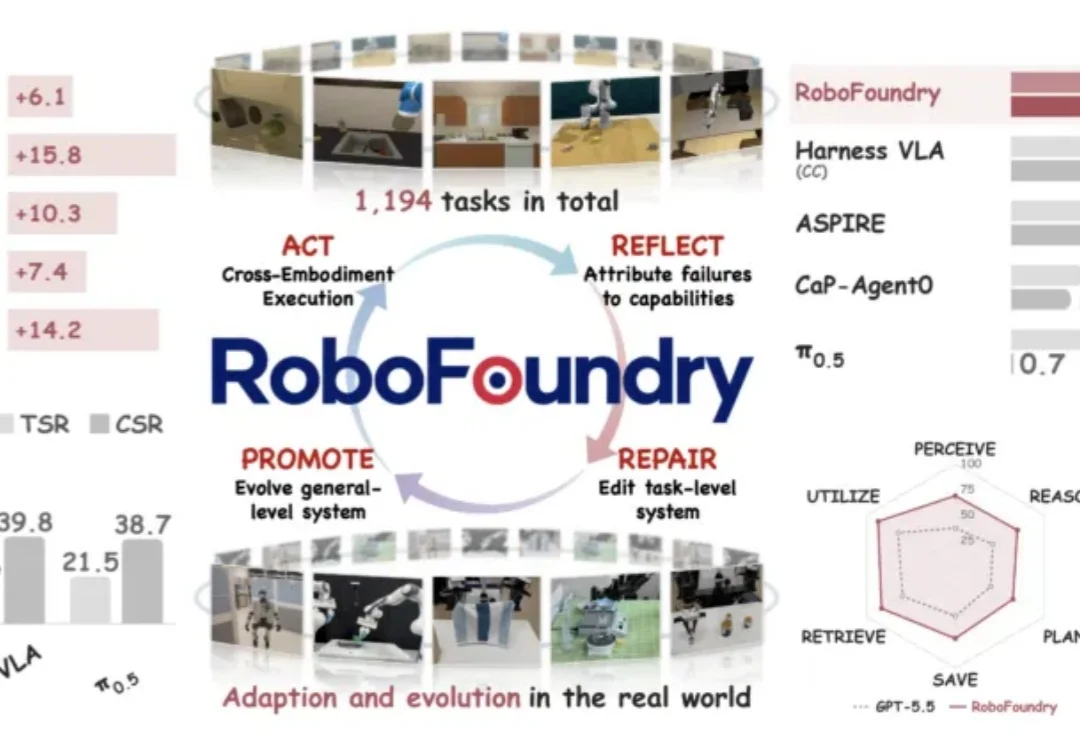
同一个 GPT-5.5,放进不同的系统里,做具身任务的表现可以相差悬殊。在 EmbodiedBench 上,直接使用 GPT-5.5 的平均成功率是 56.9%;模型参数一个不改,只让它周围的系统持续进化,这个数字变成了 72.7%。
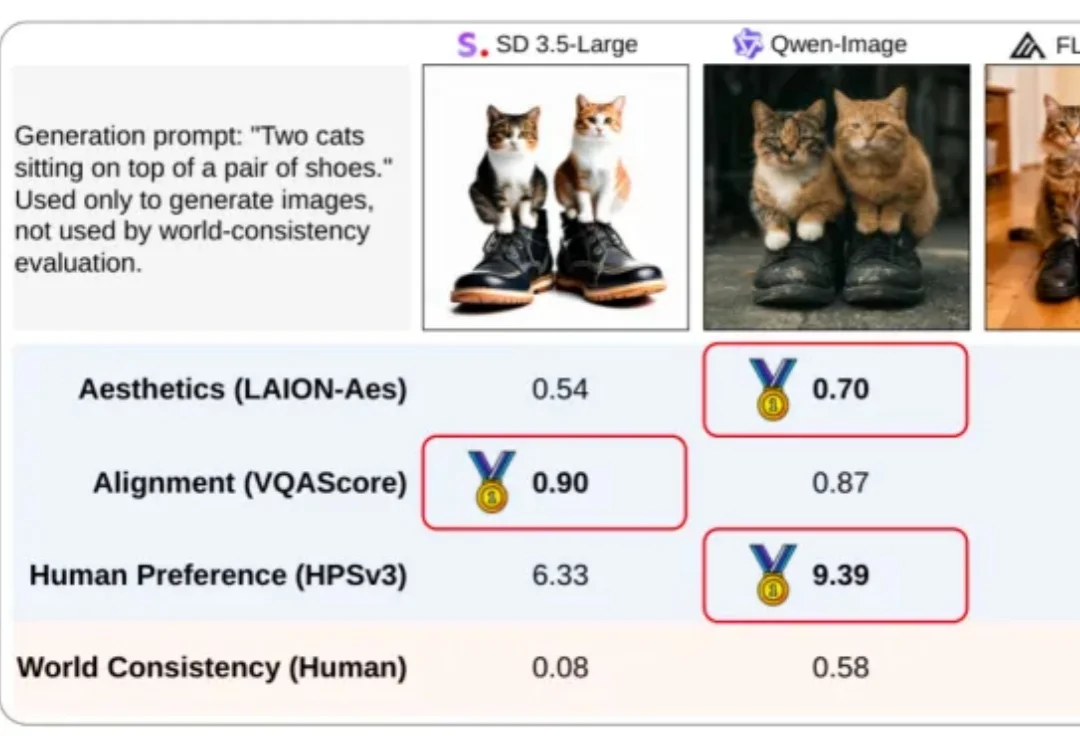
一张 AI 生成的图,可以在美学、提示词对齐和人类偏好指标上拿到高分,画面里却藏着扭曲的肢体、相互穿透的物体,或不合理的物理现象。这些错误,并不总能从现有分数中看出来。
DeepSeek 连自己官方开源的推理代码都能写错,而且错得相当有规律。