
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
鹈鹕骑自行车已经不够看了。
9 月 22 日,Anthropic 发布 Claude Opus 5.5,X 上很快被一批奇怪的「前端作品」刷屏。
有人只用一句话 Prompt ,让它给自己做了一支 15 秒 Motion Designer 求职 Showreel,引来两百多万人围观;有人让一个按钮跟着音乐一路变形成播放器、滑杆、图表和命令面板;还有人让 Opus 5.5 搭了一间 3D 相机实验室,转动对焦环,里面的镜片和焦平面真的会跟着动。
最近全球 AI 公司扎堆更新大模型版本,前端成了这一代模型的「开箱仪式」。会不会写 HTML 早就不是问题,大家比的是一句 Prompt 下去,它到底有没有审美,懂不懂空间,能不能把一个模糊的想法补全成真正能看的作品。

其中有几个 Prompt 很快成了复刻对象:抽卡游戏里,十连抽到月亮猫咪 SSR;钢琴响起时,手绘线条随着音符一点点向前延伸……
六天后的 9 月 28 日,MiniMax 上线了 M3.1-Flash-Preview。这是 M 系列的最新模型,百万 token 上下文、原生多模态,在 MiniMax Code 里首发上线,目前也可以通过 API 订阅套餐调用。
于是有人把这些 Prompt 原样丢给了它,想不到结果是不仅能跑通,而且在 M3.1 Flash 上不用多次抽卡就可以复现。Opus 5.5 是一周前刚被定义的新旗舰,而现在一个 Flash 模型也能复刻它的这一部分的能力了。
这些前端 case
M3.1-Flash 都跑通了
先看看 M3.1-Flash-Preview 能够做出什么花样。
十连抽卡是游戏行业设计得最精打细算的几十秒,要有吸引人的画面光效,结局的揭晓要卡在节奏点上,SSR 定格的那一下必须让人爽到,中间还要给人不想跳过的理由。之前 Opus 5.5 生成的效果(真・一步提示词输入)可以说足以让人震惊瘫坐了:
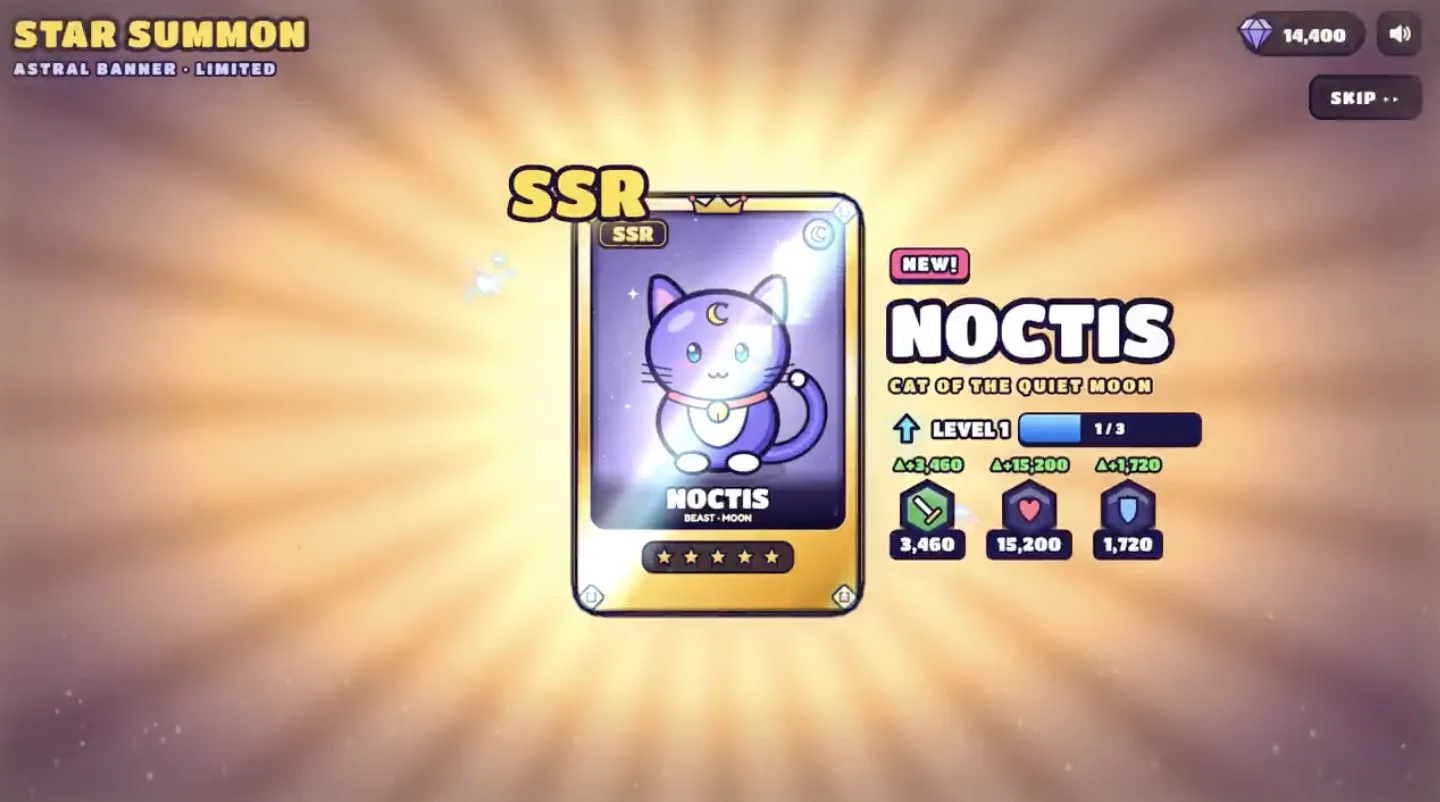
M3.1 Flash 交出的作品叫《ASTRAL SUMMON・星灵召唤》,页面是一套完整的祈愿流程:1600 钻的十连,右上角有 SKIP,十张卡依次翻开,出「SSR・NEW」时有特殊的动效,卡牌也不是一张静态图,下面接着整套角色面板,等级成长、星级突破、特性解锁一应俱全。
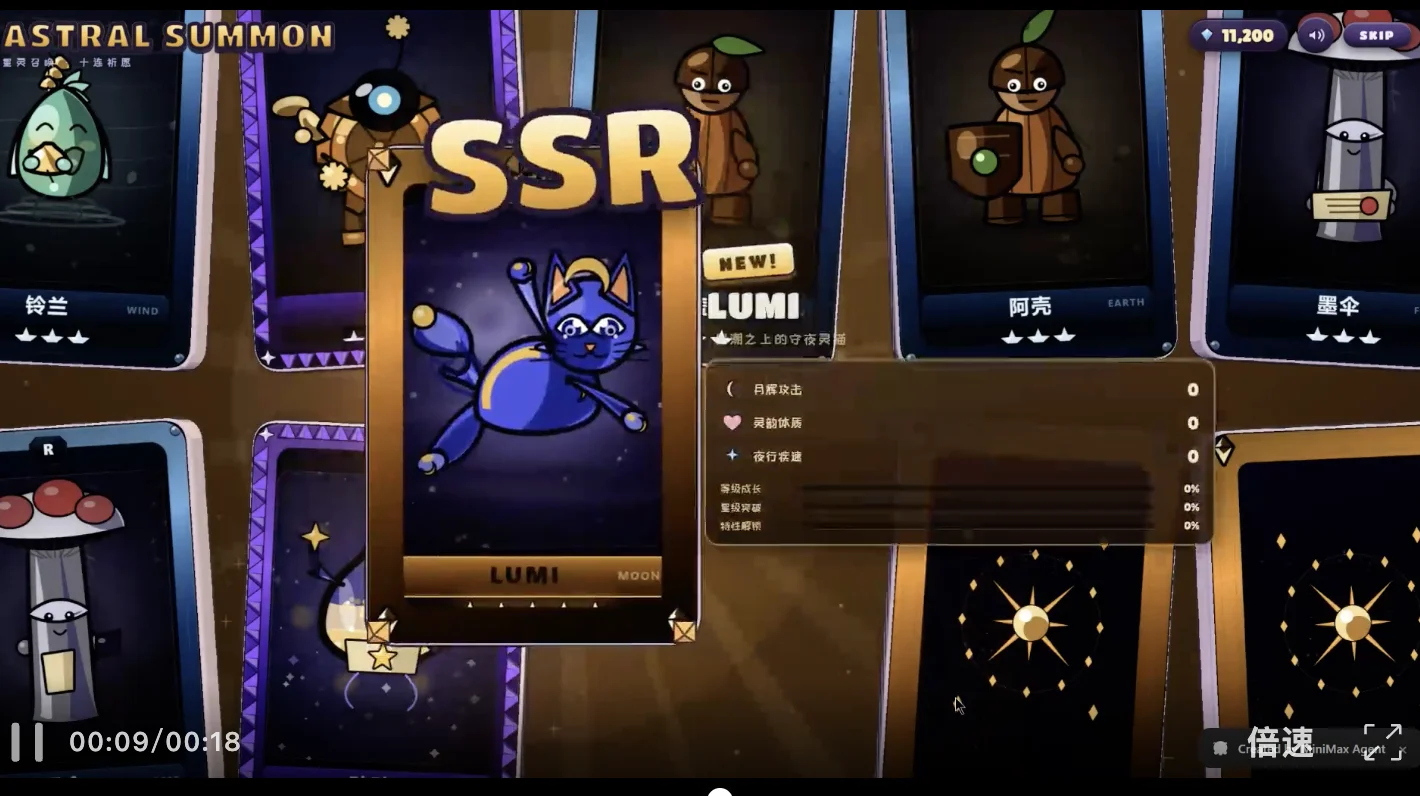
这背后同时运转着多少个系统?粒子和光效是一套,卡牌翻转的序列动画是一套,抽卡的状态机(抽没抽、抽到什么、翻到第几张)是一套,数值面板还有个实时更新的效果。任何一个环节慢半拍或者错乱了,仪式感立刻坍缩掉,而 M3.1 Flash 交付的版本里面,这些系统是咬合在一起的。
看起来 AI 已经能够把握到其中的精髓。
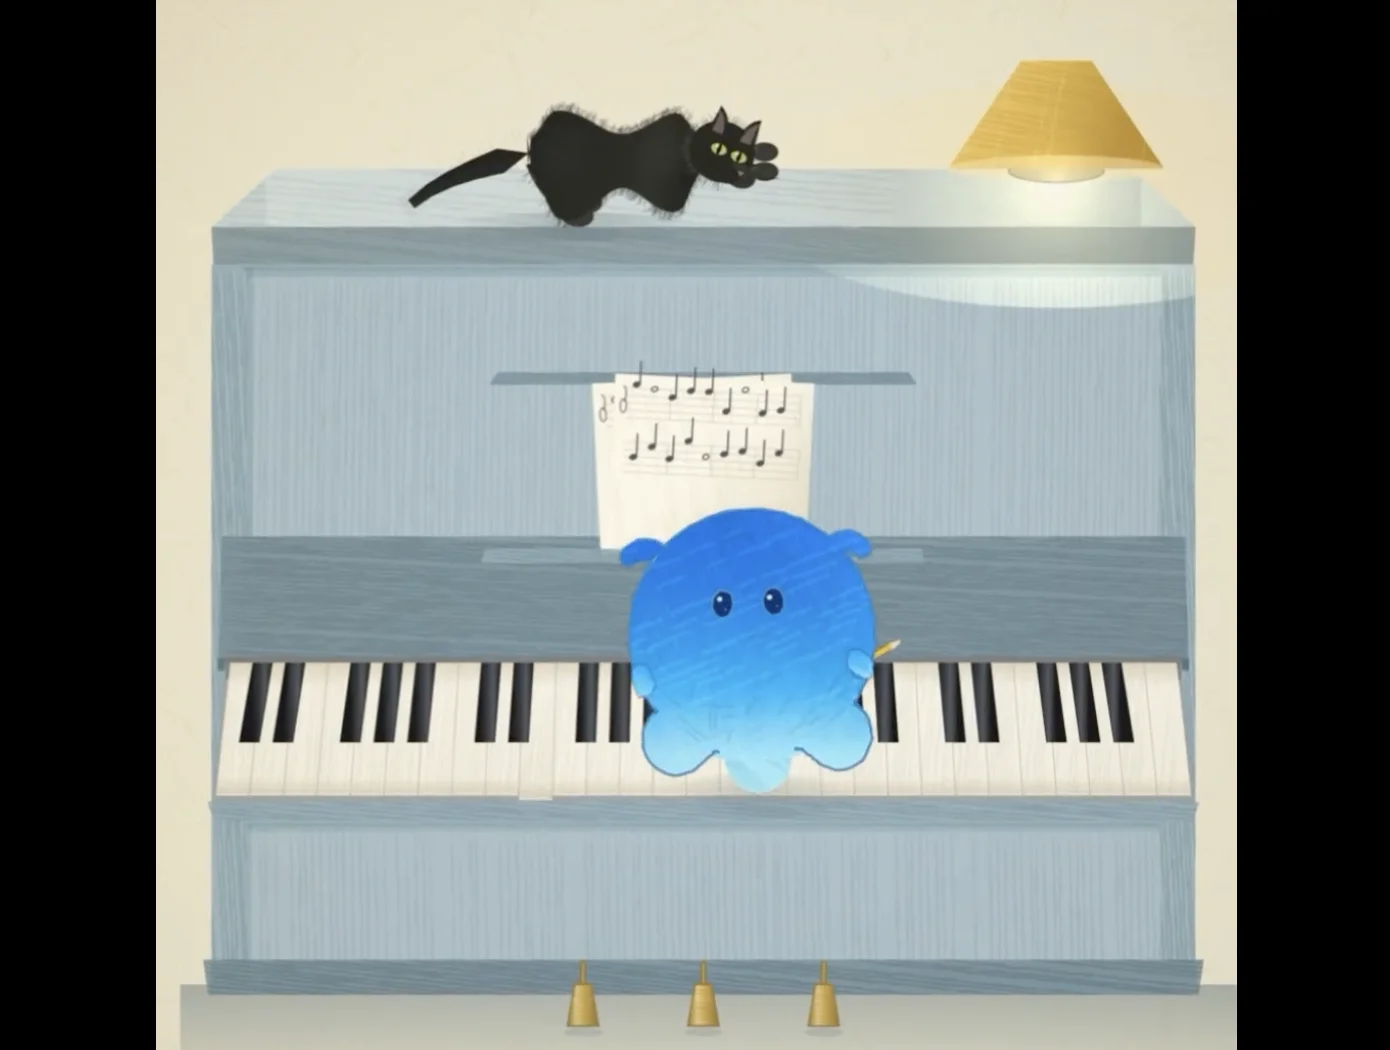
第二道题:钢琴配乐的手绘动画。原版是网友用 Opus 5.5 生成的效果,钢琴声和手绘画面同步推进:
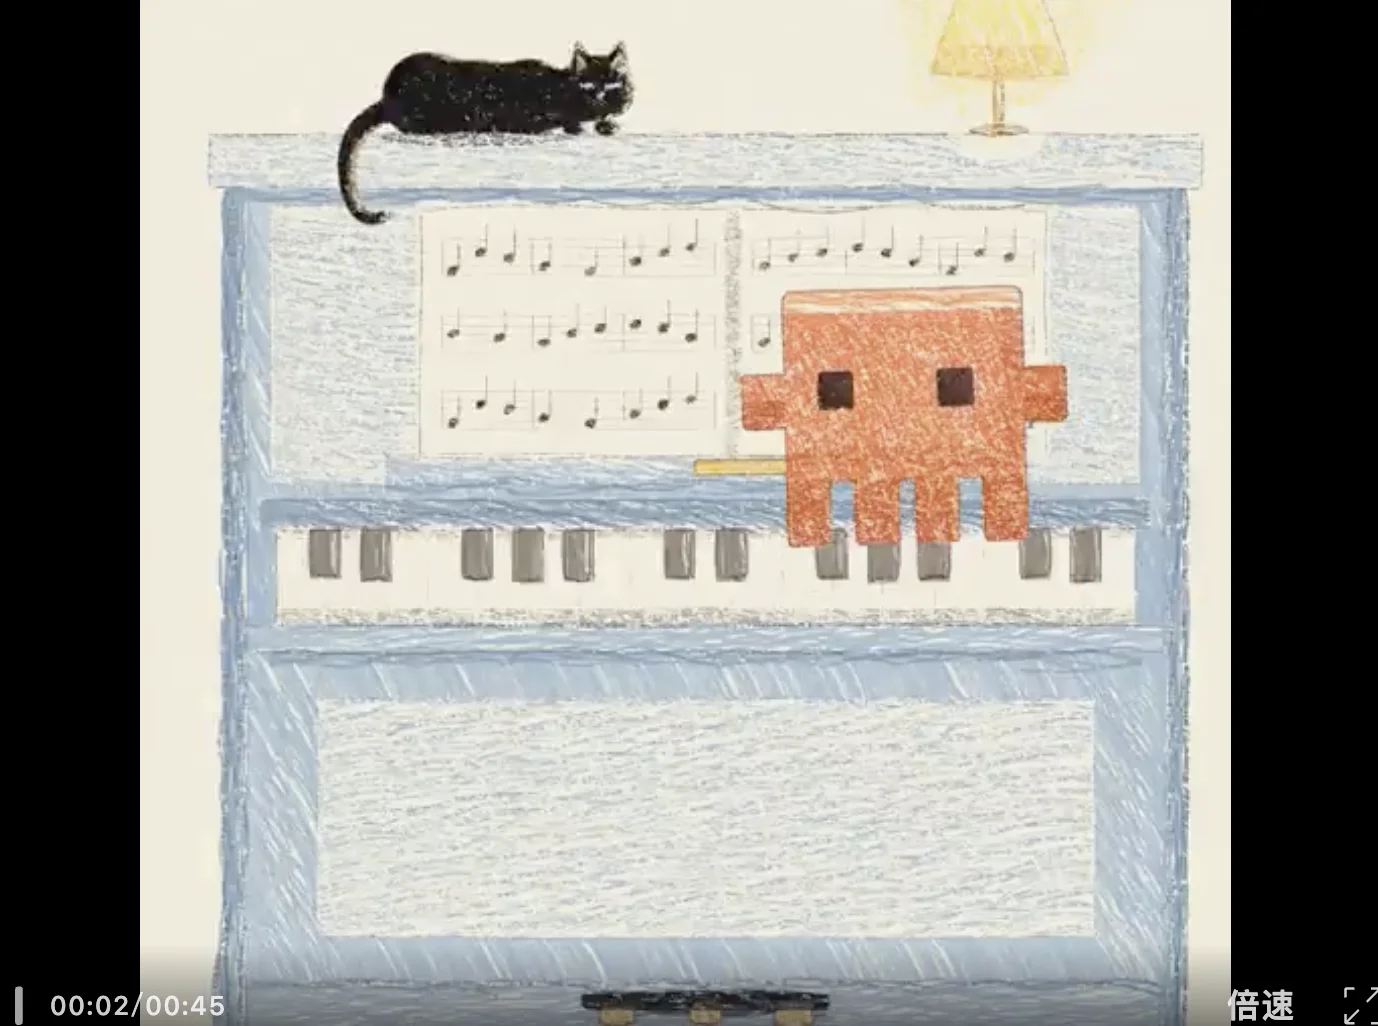
M3.1 Flash 做出来的版本叫《mcode 与黑猫的钢琴小品》。1080×1080 画幅,24fps 的帧率,配乐是一首原创钢琴小品,共 20 个小节。模型不止画了一支动画,还同时完成了作曲,画风始终统一的手绘画面,再把两者做好了对齐。
这就让我们对更大胆的测试有了信心。
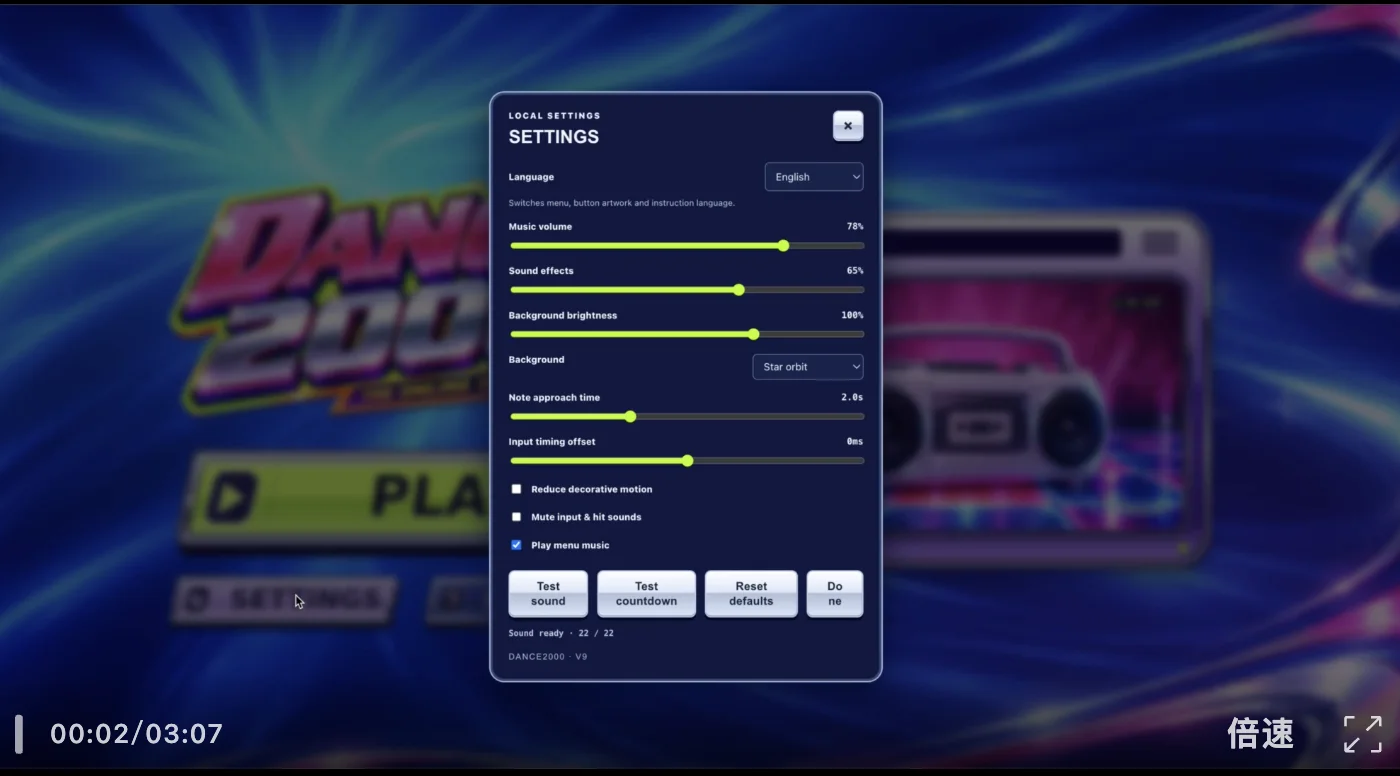
如果再想玩点更加复杂的,我们可以让 M3.1 Flash 制作一个可以在浏览器中游玩、并能上线分享的复古跳舞机游戏:
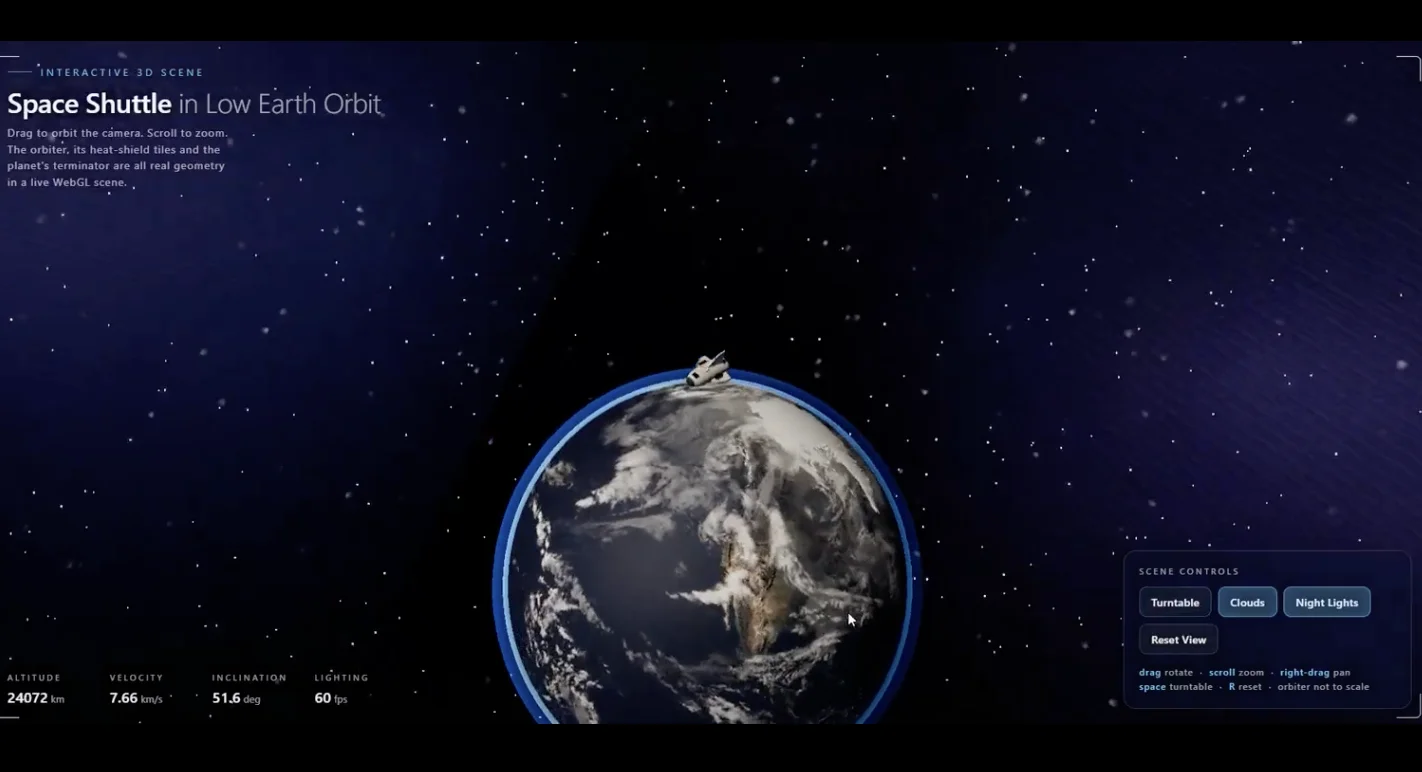
或者让它花费 45 分钟,构建一个太空飞船在地球轨道上的 3D 可交互游戏界面:
在社区里,甚至有开发者用 M3.1 Flash 做了个《黑神话:悟空》的 3D 建模。复杂 3D 场景的多部件结构、材质、光照和交互状态,看起来大模型已经能承接这种档位的工作了。

虽然还到不了直接生成 3A 游戏的程度,不过 AI 模型现在已经能把内容生产中费时的验证阶段大幅提前,快速验证概念、角色与场景。
另外在实践中我们可以观察到一个细节,M3.1 Flash Preview 在任务进行的过程中会主动截图检查自己的项目,或是回头排查之前写过的 bug,像一个交付前自己先验证几遍的人类一样,只是偶尔还不太懂得适可而止。
那么问题来了,Flash 级模型的参数规模和 token 成本摆在那里,凭什么它能实现旗舰级的前端完成度?
这就要说到,前端这件事,本质上考的还不止是「前端」技术。
为什么 M3.1-Flash 能做到?
对于 AI 来说,前端代码相对容易学会,真正难的是有「品味」。
为此首先要构建视觉的闭环,模型要能「看见」自己的作品。如果纯手搓的话,前端作品从第一行代码走到最终交付,中间要经历很多轮「生成 — 截图 — 检查 — 修改」的循环,写完一段布局看到渲染出来的页面,发现问题要再回到代码里追查。
AI 来实现的方式有两种,一种是先把语言模型训练好再外挂一个视觉模块;另一种是从训练的第一步起,就让文字和图像在同一个模型里一起学。M3.1 Flash 走的是后一条路。按照 MiniMax 的官方表述,M3 系列从 Step 0 开始进行多模态训练,为此重新构建了预训练数据管线,引入大量图文交错数据,这使得模型具备了旗舰级的视觉判断与修正能力。
光看得见还不够,更重要的是建立视觉与代码之间的反馈闭环。这一步过去主要靠思维链去推理,每多走一步都在考验模型的基本功,参数量越大越占优势。
原生的多模态模型中,视觉的判断更像是直接「看」出来的,当视觉和代码在训练中完成了语义空间的对齐,冗长的思维链已经被感知所替代。在 M3.1 Flash Preview 的官方案例中,把视觉参考转化成为可交互代码已经被 MiniMax 单独列成了一项能力。
还有一样能力最难量化:模型要听得懂设计意图,并且真正具备多模态理解能力。现在 AI 模型面临的不少任务只有个「大方向」,它要理解的是人们在 Prompt 背后那个「我想要什么」的意图。
考虑到 M3.1 Flash 来自 MiniMax,这其实不是突然出现的能力。在其产品线上,有全模态融合、具备强大上下文理解能力的 H3 视频模型;结合 Agent 工作台 MiniMax Design,人们可以通过自然语言交互的简单方式完成复杂的制作,从创意方向、Agent 执行,一路走到审核和最终交付,将 AI 底层能力转化为可控的商业产品。
意图理解、视觉风格本来就是 MiniMax 在多模态生成一侧长期训练和产品化的能力。现在,这种能力也被引入了 M 系列大模型。
旗舰能力开始下沉
人与 AI 的分工规则也变了
大模型兴起才没几年,人与 AI 的协作方式已经经历了不小的变化。
我们最早用大模型的方式就像在填一张详细的工单:布局、颜色、每段文字写什么、按钮放在哪里都得交代清楚,AI 自我发挥的细节往往没法看。后来模型开始接得住模糊一些的描述,工单可以写得粗放一点。而现在,以这些前端作品为标志,协作的方式已开始接近「任务委托」,你给出意图和方向,把设计决策也一并交出去,等对方交回成品就完事了。
这是一种分工的变化。当交付不再是瓶颈,创意工作里人的价值就集中在了定义问题,与审美判断能力上。而 AI 的任务,现在是尽可能地降低实现出来的门槛。
前端可以说是目前最能体现大模型综合的地方。不同于 Benchmark 摸不着的分数或是模型架构的细节,大模型生成的网页与游戏日趋成熟,已经快成了通向 AGI 的里程表。它让 AI 的综合能力一目了然,最容易被看懂,其背后检验的不仅有代码生成能力,还有指令遵循、长程任务和审美判断。
更重要的在于它潜在的实用性。对于开发者之外的用户而言,前端的生成效果很容易判断,在内容场景上也有大量的落地空间。最先用起来的可能是那些原本已经需要大量视觉内容的人:品牌、设计师、电商与游戏团队。过去需要多人协作的工作,现在相当一部分正在被压缩成一次 Agent 任务。
而且一旦 AI 生成的产物进入真实工作流,快速的方案验证就会改变工作方式。几个月后喊 token plan 不够用的,可能就不是程序员了。
最后肉眼可见的是,目前旗舰模型能力的保质期正在变短。
Opus 5.5 在 9 月 22 日定义的标杆能力,到了 6 天以后就由 Flash 级的模型交付出来了,甚至速度更快、成本更低。这个追上前沿模型的速度过去以季度计,如今以天计。前端只是最新的例子,过去一年里,长上下文、工具调用、代码能力都经历过同样的下沉。
对于模型公司来说,真正构成壁垒的不再只是算力和数据,训练路线的选择和模型的世界观正越来越重要。
结语
M3.1 Flash 目前还只是 Preview 版,但其在前端上的表现,已经可以承担起更多、更复杂的任务了。
在 AI 领域里,风向已经有了变化,正如 9 月 30 日,OpenAI 推出的 GPT 6.1 Sol 让我们看到,AI 一哥也开始玩起了性价比。大模型发展到这个阶段,已经承载了太多真实工作需求,效率和性价比正显得愈发重要:现在是旗舰模型负责把智力的天花板往上顶,干活模型负责处理日常真实工作。而且照着目前这个速度,获取智力的门槛还要再降,而且降得越来越快。
六天一个回合,下个回合已经开始了。
文章来自于微信公众号 “机器之心”,作者 “机器之心”


【免费】cursor-auto-free是一个能够让你无限免费使用cursor的项目。该项目通过cloudflare进行托管实现,请参考教程进行配置。
视频教程:https://www.bilibili.com/video/BV1WTKge6E7u/
项目地址:https://github.com/chengazhen/cursor-auto-free?tab=readme-ov-file
【开源免费】字节工作流产品扣子两大核心业务:Coze Studio(扣子开发平台)和 Coze Loop(扣子罗盘)全面开源,而且采用的是 Apache 2.0 许可证,支持商用!
项目地址:https://github.com/coze-dev/coze-studio
【开源免费】n8n是一个可以自定义工作流的AI项目,它提供了200个工作节点来帮助用户实现工作流的编排。
项目地址:https://github.com/n8n-io/n8n
在线使用:https://n8n.io/(付费)
【开源免费】DB-GPT是一个AI原生数据应用开发框架,它提供开发多模型管理(SMMF)、Text2SQL效果优化、RAG框架以及优化、Multi-Agents框架协作、AWEL(智能体工作流编排)等多种技术能力,让围绕数据库构建大模型应用更简单、更方便。
项目地址:https://github.com/eosphoros-ai/DB-GPT?tab=readme-ov-file
【开源免费】VectorVein是一个不需要任何编程基础,任何人都能用的AI工作流编辑工具。你可以将复杂的工作分解成多个步骤,并通过VectorVein固定并让AI依次完成。VectorVein是字节coze的平替产品。
项目地址:https://github.com/AndersonBY/vector-vein?tab=readme-ov-file
在线使用:https://vectorvein.ai/(付费)
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
