
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
家人们,上次我写摄像头体感交互应用,评论区有位家人问:“测试视频怎么是个男的?”
让我们编辑部男同事郁闷了半天,“下次别让他出镜,再不济也要P成你。”
满足你!
让同事继续负责表演,画面里换成本瑶出镜。
我要撒娇,他也得撒娇;我要飞吻,他也得飞吻。
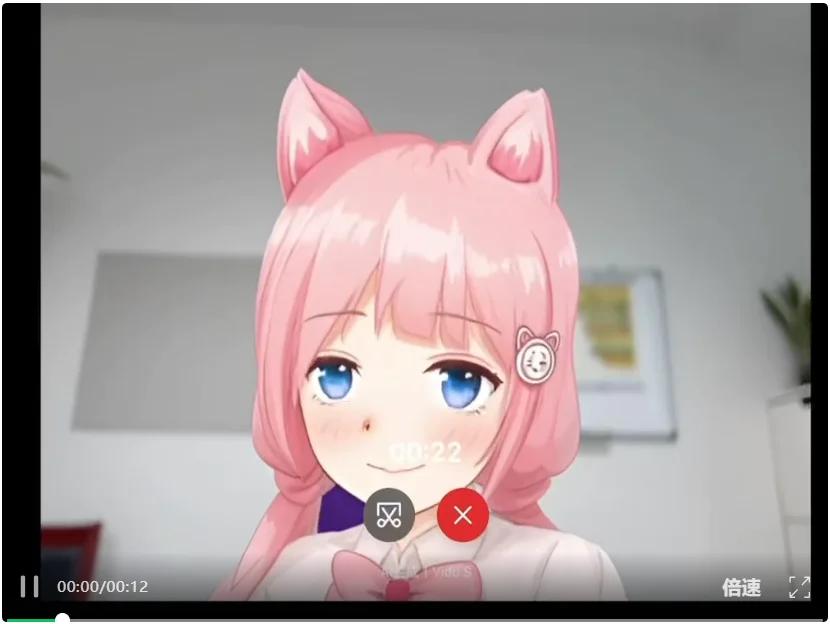
(Ps:同事负责演,我负责出镜,嘿嘿,编辑部的分工又细了一点。)
怎么样,是不是有点东西!
这件事放在普通的视频生成上,问题其实不大。出来一段视频,好不好看一眼就知道。但实时视频不一样。
它是一条一直往前走的流。你第 10 秒让它换件衣服,第 40 秒又想换回来,第 90 秒说算了还是第一件好看。每插一次话,模型都得同时搞明白三件事:
那问题就来了:这玩意儿到底怎么测?
总不能截一帧好看的图,就说模型懂我了吧。
然后我发现,这事还真有人认真做了。
10 月 20 日,arXiv 上挂出了一篇论文,叫 StreamEval: Evaluating Interactive Streaming Video Generation Models。
论文链接:
https://arxiv.org/abs/2610.28402
看署名,阵容挺硬的:清华、英伟达、CMU、UC Berkeley、普林斯顿、新加坡国立大学,还有 Reactor。
StreamEval,是全球首个⾯向实时交互视频的benchmark。
目前,这个benchmark已经开源,做了一件事:把“实时交互好不好”这件只能靠感觉判断的事,变成公开考卷。
科研机构、企业模型团队、个人开发者能参与:接入模型、复现结果,或者研究案例,把发现的问题+想补的考题直接反馈给维护团队。
代码、案例和评分规则都公开,大家也能反过来讨论:题目出得合理吗,分数判得准吗?这样,模型的进步有据可查,评测本身也能在共同参与中不断完善。
这套基准一共 300 道题,规模不算大,分成五类,每类 60 道:
基本把实时视频现在最火的三个方向都包进去了:数字人、虚拟世界、正在播的视频里的实时修改。
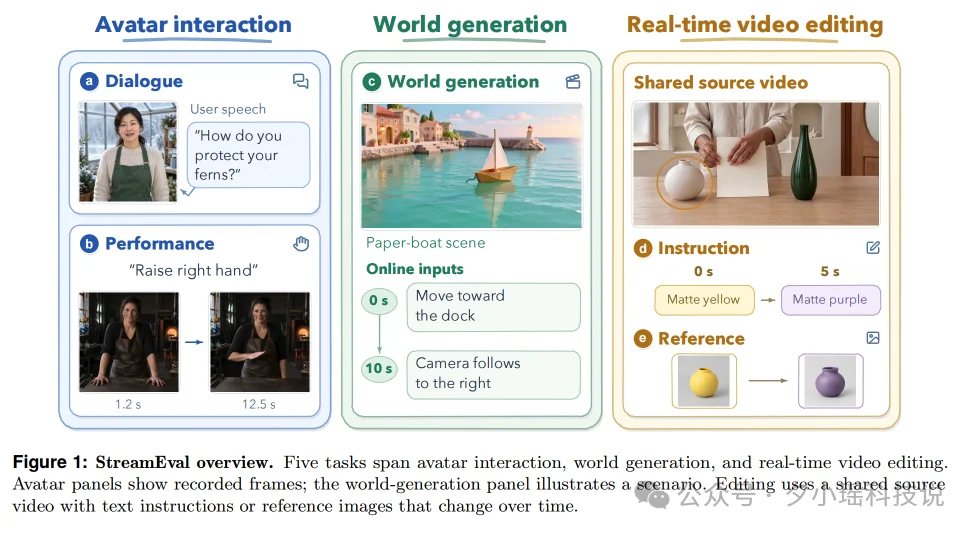
论文一口气测了 37 个模型、47 组组合,前面我玩的那些,换人、换造型,对应的是参考图编辑,“小瑶版”数字人接话、做动作,对应的是数字人对话和表演。
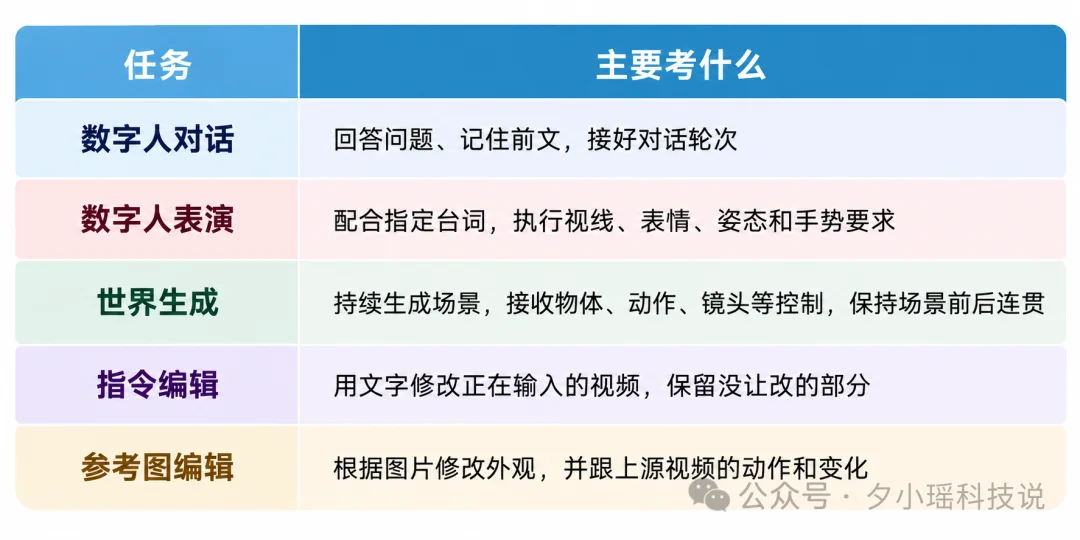
比较有意思的地方,是它的出题方式。
每一道题包括三个元素:
起始素材:人物图、源视频、语音或者参考图。
输入时间线:第几秒,发出哪条新要求。
判卷依据:论文里叫 oracle,写清楚每条要求送达之后,哪里该变,哪里必须保留。
论文中展示了一个非常典型的“披风实时编辑”案例:
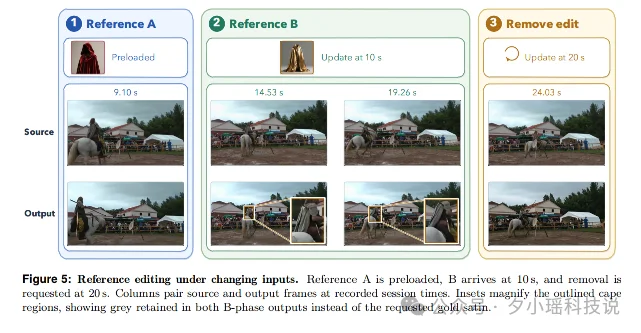
这段人物视频的时间线设置是0 秒开始使用“红色丝绒披风”参考图,10 秒切换为“金色缎面披风”参考图,20 秒:取消修改,恢复当前源画面。
这里有一个测试陷阱:
在 20 秒取消修改时,画面恢复的应当是当时时点的源画面,人物与动作绝不能“滚回”到最初起点。
结果,在测试中金色参考图生效阶段抽样的两张输出里,披风依然是原来的灰色——背景和场景虽然保住了,但新外观要求却没有真正换上去。
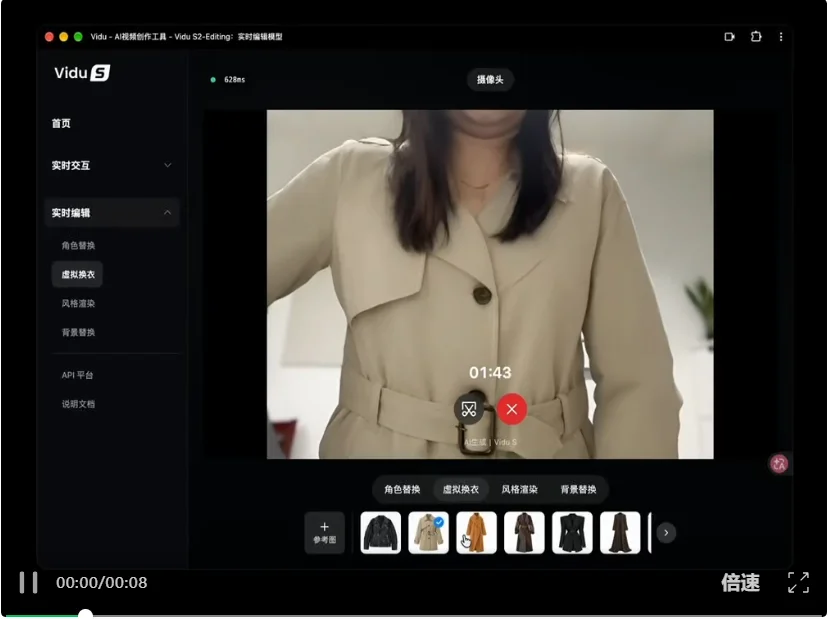
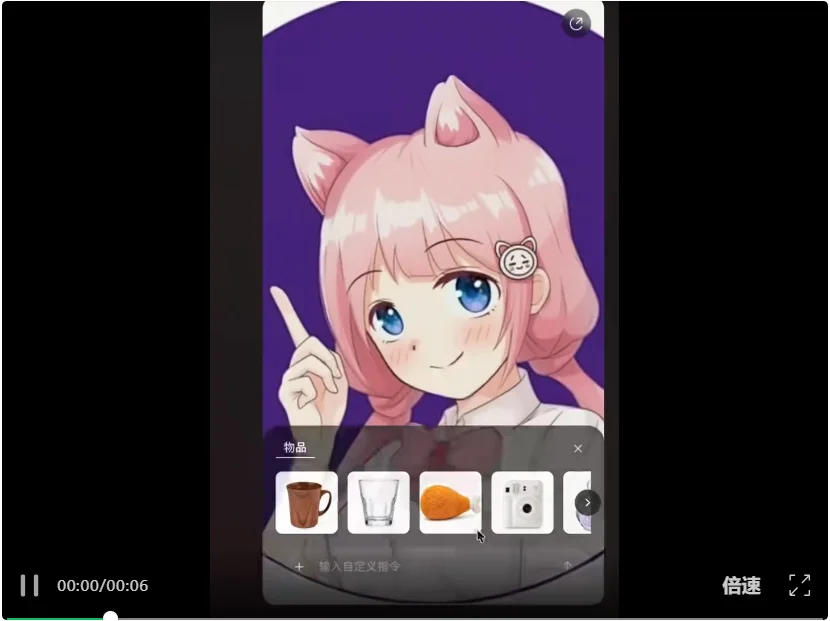
我也用 Vidu S2 试了试“连续换衣服”:视频里我一直在不停切换第一套、第二套、第三套参考图,而视频流持续往前走。
除了任务类型,题目还按时长分了五档:15 秒、30 秒、60 秒、120 秒、300 秒。
短的看反应快不快、执行到不到位。长的看能不能扛住:要求叠了好几轮之后,它还记不记得前面答应过什么。
StreamEval 把能力拆成了 4 个维度、10 项指标,每项 0 到 100 分,规则含盖非常全面:
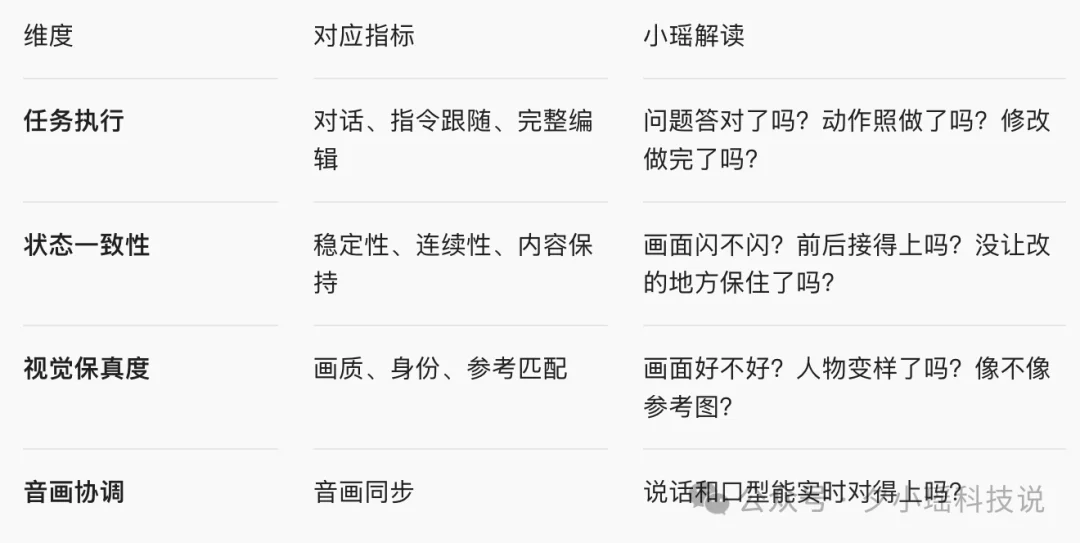
不同任务只用跟自己相关的指标。
拿参考图编辑来说,它要同时盯三件事:参考图上的样子有没有用上,不该改的地方和原来的动作有没有保住,以及这次编辑到底算不算完整成功。
Ps:所以,在上面换衣服的Case中,即使衣服换对了,但把人物手里原本拿着的杯子给改没了,在 Edit Success 指标下依然算失败!
评测打分的过程分为两步:
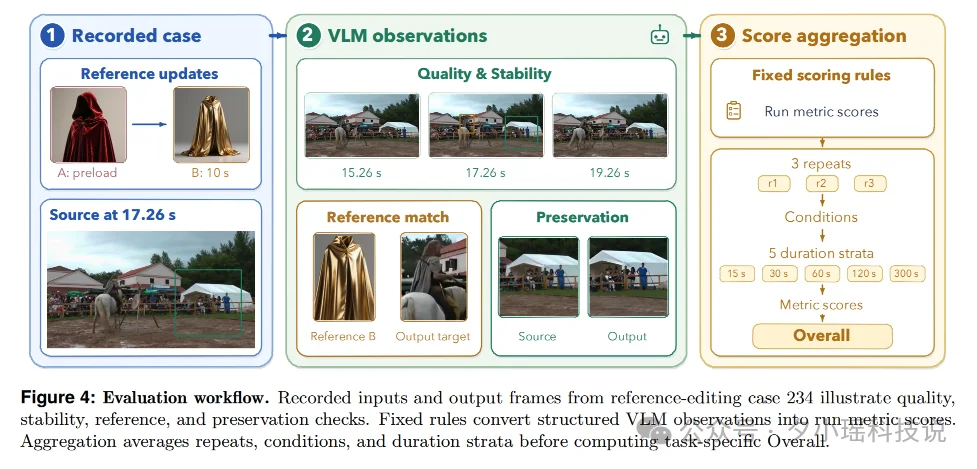
没输出、不支持某项必要操作,直接记零分。
还有一点我一开始没想通,后来觉得特别对:
五类任务各排各的,不合并成一个总榜。
数字人聊天和生成一个虚拟世界,根本不是一回事。硬加在一起啥也说明不了,分开测更有参考意义。
论文公布了各模型的测试成绩:
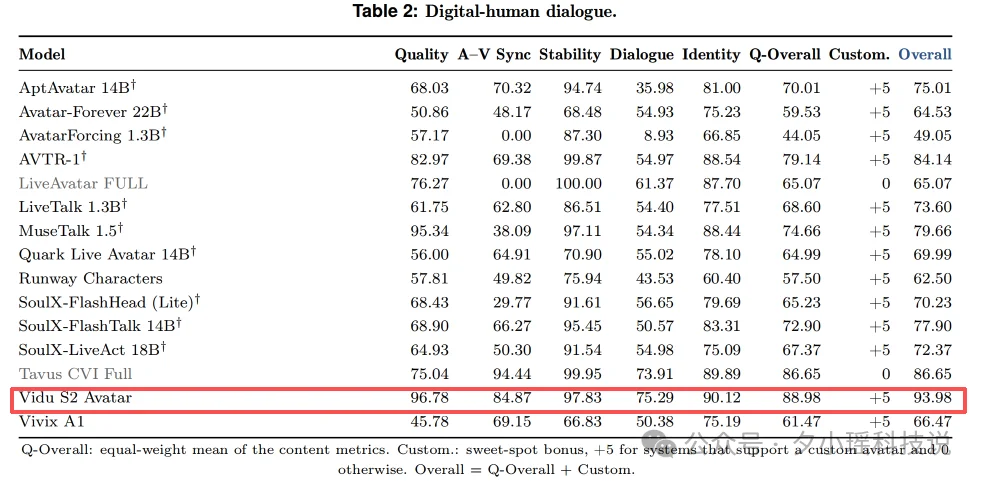
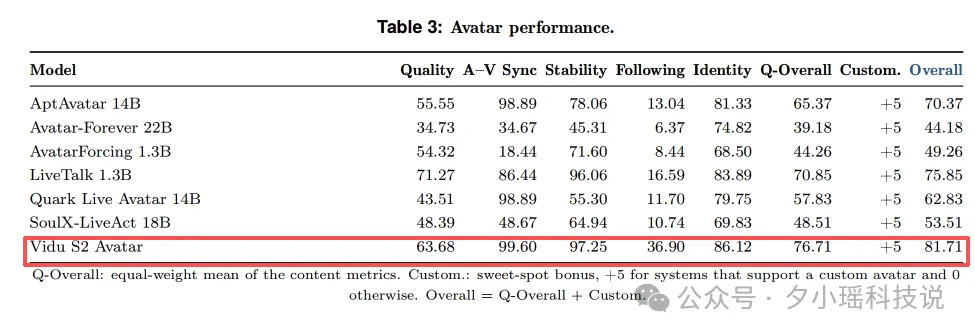
五类任务中,生数科技的 Vidu S2-Avatar 拿到了数字人对话、表演两项的综合分第一:
S2-Editing 在两类视频编辑中领先:
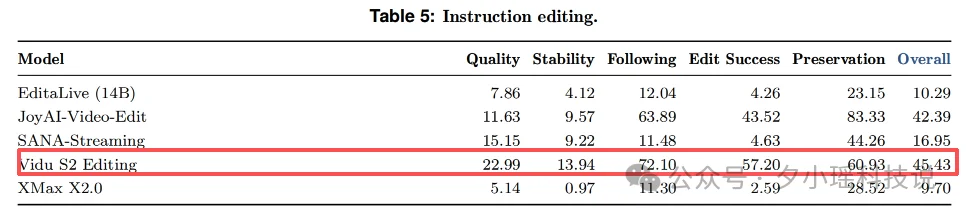
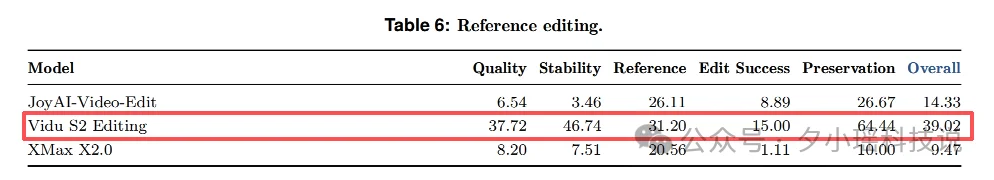
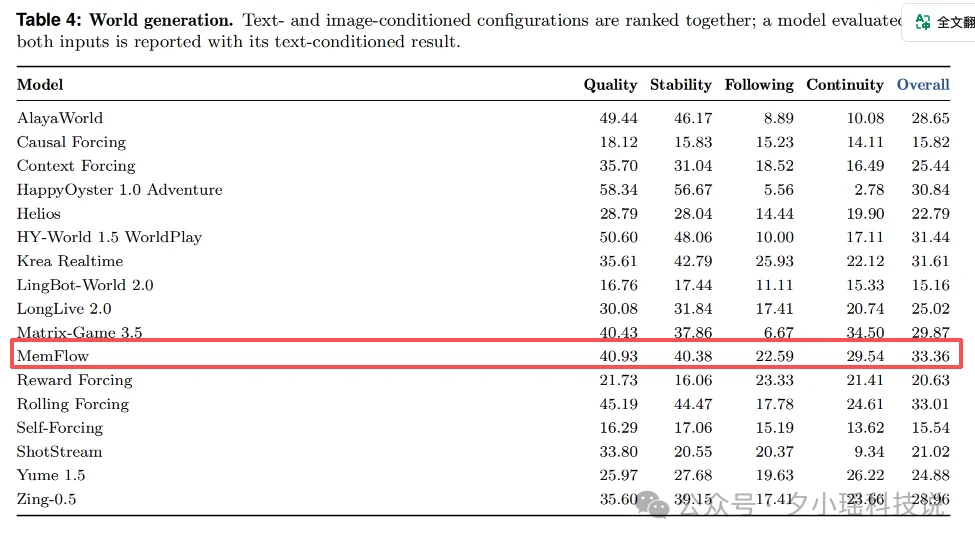
港大、快手可灵等团队提出的MemFlow,¬则在世界生成中排名第一:
如果我们仔细拆解具体分项,会发现实时视频生成行业目前面临的真实困境:
比如,Vidu S2-Avatar 的表演稳定性是97.25,动作跟随是36.90。
而36.90,已经是这项任务里七个模型的最高分了。。。。
(这其实在我把玩 Vidu S2-Avatar的时候就有感觉到:虽然数字人可以保持得很稳,画面也挺顺,但让它抬手、转头、做指定动作,有很大的改进空间。)
严格编辑(Edit Success)难如登天。。。。
在参考图编辑任务中,考查最严苛的“完整编辑”指标,全场最高得分仅为 15.00 分!
其他没拿到榜首的模型分开看其实也是各有“错位优势”:
借助StreamEval 基准评估到的这些错位优势数据,具有极高的选型价值:实时试衣最怕哪种失误,聊天角色最依赖哪项能力,都能够回到对应指标和输出记录里看。
我认为,StreamEval 对整个行业最大的价值,在于把实时视频生成的“可控性”,从一个抽象的概念变成了一组公开、可复查、可量化的标准。
何时修改、保留什么、如何恢复、怎样计分,从此都有规可循。
氮素,这套基准也确实需要继续验证。
比如自动评分还需与人工判断对照,5分钟的案例之外,还要补充更长会话、复杂场景,以及实际部署中的帧率、时延和成本测试等等。
目前,StreamEval 已公开发布了评测代码、案例时间线、数据集与评分规则,放上链接:
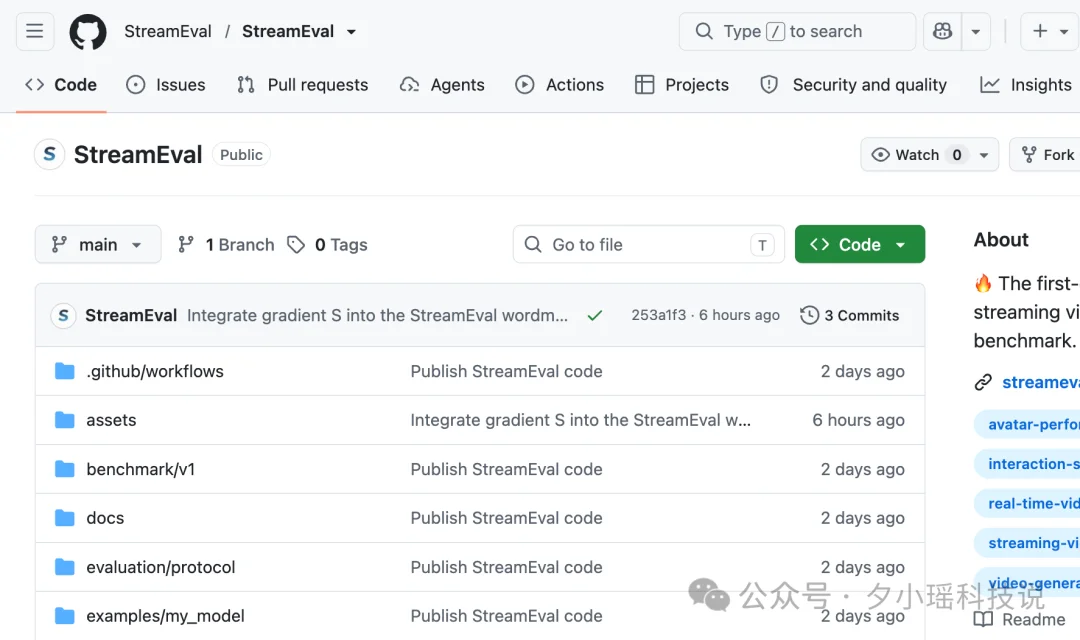
GitHub:
https://github.com/StreamEval/Stream-Eval-Open
Leaderboard:https://streameval.ai
论文:https://arxiv.org/pdf/2610.28402
有模型或 API 开发能力的家人们,可以直接参照 GitHub 仓库的接入文档自己配一下,跑跑看自己的模型能拿多少分。
StreamEval 将长期维护,每月都会评测新增模型和更新后的模型,并在榜单上公布最新测试结果。
企业、科研机构和个人开发者,都可以通过官网“Evaluate your model”入口提交模型信息,也可附上自测结果。结果经审核验证后,将被纳入后续榜单。
随着更多模型和版本加入,今天没接住的一个动作、一次切换,到了下一版,就能再拿出来测。
行业积累下来的,也会是一份份可以接着研究、继续改进的记录。
至于评论区那位家人,作业我先交到这里啦~
下次想看我做什么动作,先问问编辑部那位最帅男同事愿不愿意演hh。
文章来自于"夕小瑶科技说",作者 "夕小瑶编辑部"。

【开源免费】Fay开源数字人框架是一个AI数字人项目,该项目可以帮你实现“线上线下的数字人销售员”,
“一个人机交互的数字人助理”或者是一个一个可以自主决策、主动联系管理员的智能体数字人。
项目地址:https://github.com/xszyou/Fay
【开源免费】VideoChat是一个开源数字人实时对话,该项目支持支持语音输入和实时对话,数字人形象可自定义等功能,首次对话延迟低至3s。
项目地址:https://github.com/Henry-23/VideoChat
在线体验:https://www.modelscope.cn/studios/AI-ModelScope/video_chat
【开源免费】Streamer-Sales 销冠是一个AI直播卖货大模型。该模型具备AI生成直播文案,生成数字人形象进行直播,并通过RAG技术对现有数据进行寻找后实时回答用户问题等AI直播卖货的所有功能。
项目地址:https://github.com/PeterH0323/Streamer-Sales
