
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
大模型强化学习后训练、机器人控制与Meta-RL中,存在一个越来越实际的问题:
逐个评估任务太昂贵,用历史数据预测风险,又可能跟不上模型更新。
如何用有限的rollout预算,找到真正值得训练的Prompt?
来自国防科技大学和清华大学的研究团队据此提出ICRPM(In-Context Risk Predictive Model),利用近期任务与风险记录,直接预测下一步的风险。
该方法无需为风险预测额外生成rollout或增加环境交互,在基本维持原有训练开销的情况下,改善了大模型RLVR、Meta-RL及鲁棒控制等场景中的任务风险预测与选择效果。
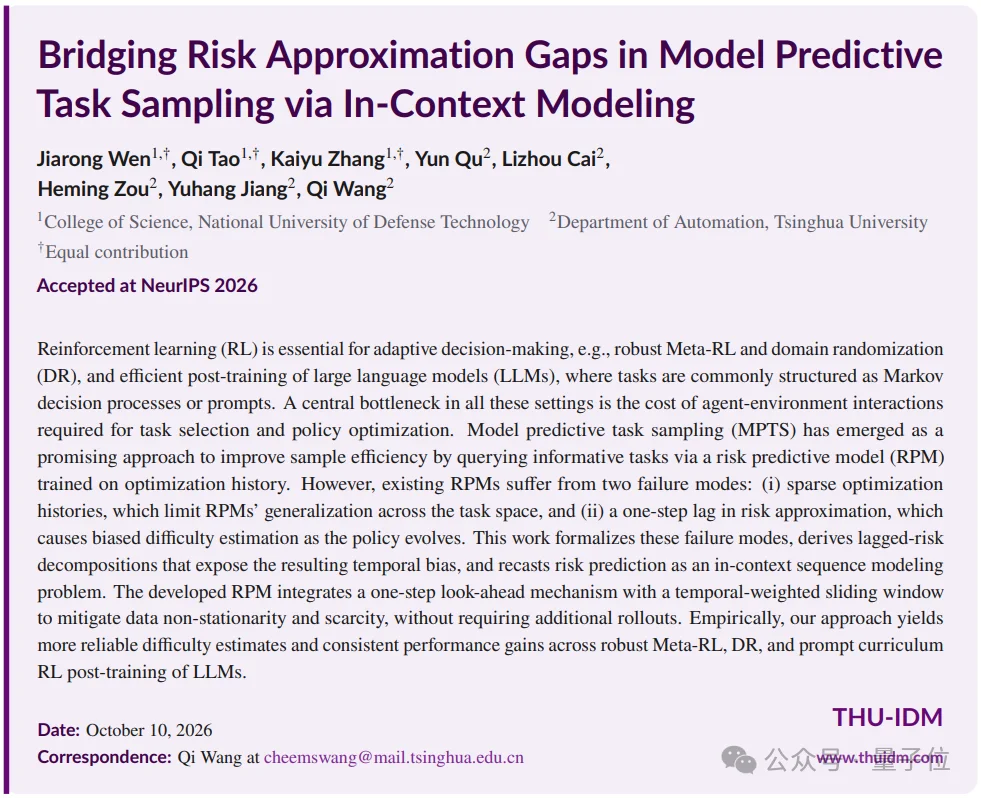
传统任务采样需要先测量候选任务的难度或风险。在大模型RLVR中,这意味着为Prompt生成多条回答,再根据可验证奖励估计解题成功率;在Meta-RL和鲁棒控制中,则往往意味着昂贵的环境交互。
Model Predictive Task Sampling(MPTS)通过风险预测模型(RPM)减少这类评估:只对少量任务进行真实测量,再预测更大候选集合的风险并据此采样。但任务风险不是静态标签。策略更新后,原本困难的任务可能变容易,任务之间的排序甚至可能反转。一个擅长预测“当前风险”的RPM,未必能准确判断“下一轮该选谁”。
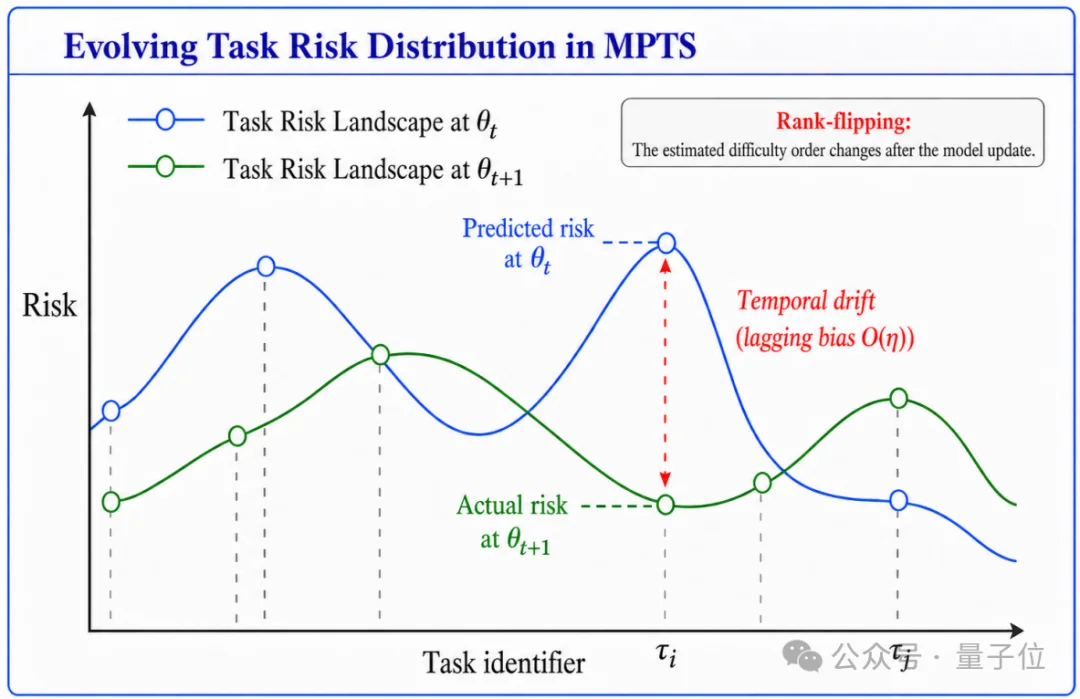
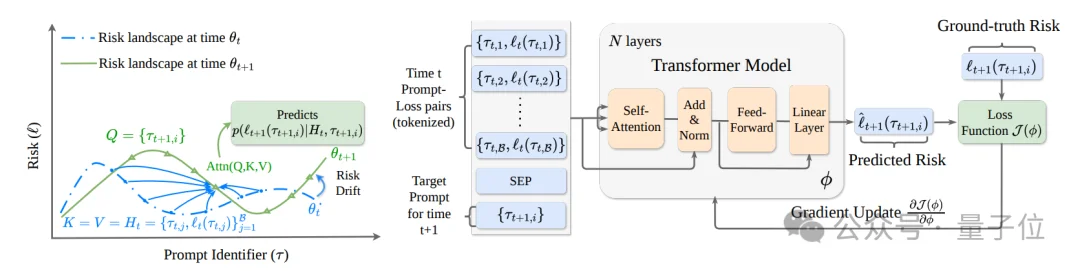
ICRPM保留MPTS的基本任务采样框架,重点替换其中的风险预测方式。传统RPM主要拟合当前策略下的风险;ICRPM则把最近一步的“任务—风险”观测当作上下文,结合待评估任务,预测策略完成下一次更新后的风险。
这样,历史记录不再只是普通的训练样本,还成为反映策略所处状态的线索。模型需要学习的不仅是不同任务的难度差异,还有难度如何随训练进度改变。
论文的误差分析解释了这一设计的必要性。传统RPM预测当前风险再用于下一步,存在与学习率相关的一阶时间滞后误差。若上下文预测器能够捕捉局部风险变化,ICRPM可将对应的平滑性残差控制在二阶量级。不过,这不意味着预测误差自动归零:模型自身的上下文近似误差依然存在。
每轮真实评估的任务数量有限,单靠最近一个批次容易造成数据不足;但长期堆积旧数据,又会混入已经过时的策略状态。
ICRPM采用带时间衰减的滑动窗口,复用最近3个历史批次形成的上下文与预测目标,并将时间衰减系数设为0.9。越新的记录对当前预测影响越大,较旧的记录仍能提供监督信号,但权重逐步降低,从而在补充监督与避免过时数据干扰之间取得平衡。
实现上,ICRPM将任务和对应风险编码成输入表示,由Transformer建模历史任务间的关系,再通过交叉注意力读取与候选任务相关的信息,最终输出下一步的风险预测。
值得注意的是,实验为ICRPM与传统RPM匹配了参数量:Meta-RL中约为0.65M参数,RLVR中约为42.8M参数。因此,性能差异不能简单解释成预测模型变大了。训练目标仍来自既有优化过程,不需要为风险模型新增环境交互或rollout。
研究在LunarLander上比较了不同模型结构、任务选择规则以及历史窗口设置。把Transformer换成参数量匹配的MLP,ICRPM依然优于传统MPTS;给MPTS加入相同的历史窗口和时间衰减,却不预测下一步,也仍追不上ICRPM。
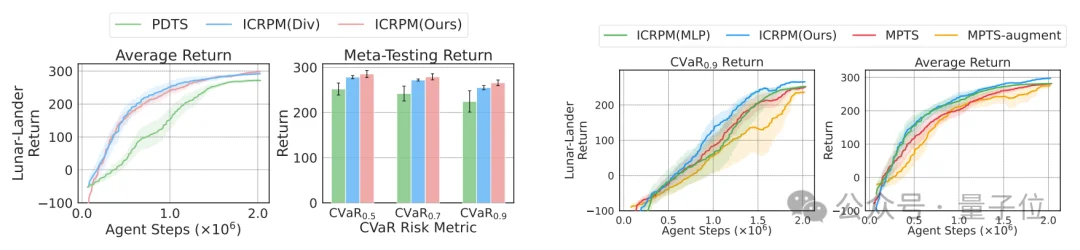
这表明真正关键的是上下文条件下的前瞻预测,而不仅仅是使用Transformer或增加历史数据。窗口敏感性实验也表明,历史并非越长越好:论文采用3步窗口与0.9的衰减系数,在补充监督和避免旧数据干扰之间取得平衡。
论文覆盖少样本正弦回归、Meta-RL、Domain Randomization(DR)和LLM RLVR四类场景。评价重点不只是平均性能,也包括任务风险排序的一致性及困难任务上的表现。
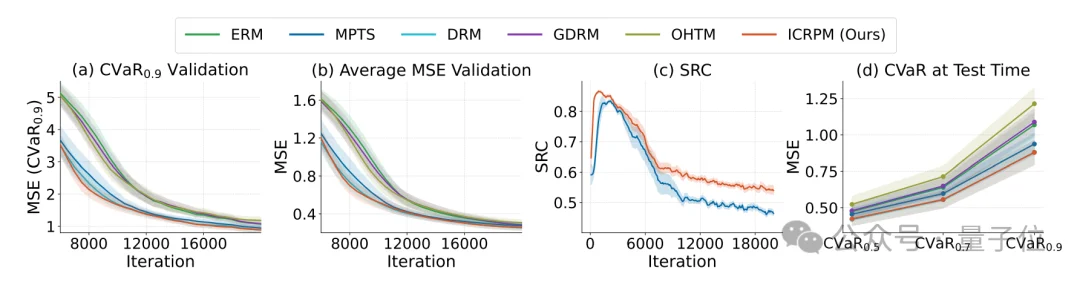
在Few-shot Sinusoid Regression实验中,ICRPM不仅降低了平均均方误差(MSE)与尾部风险误差,预测风险和真实风险之间的Spearman排序相关系数(SRC)也持续优于MPTS。在Meta-test阶段,ICRPM在CVaR₀.₅、CVaR₀.₇和CVaR₀.₉三个评价水平上均取得了各对比方法中最低的MSE,同时保持了更高的风险排序相关性,说明任务难度排序的改进能够传导到下游性能。
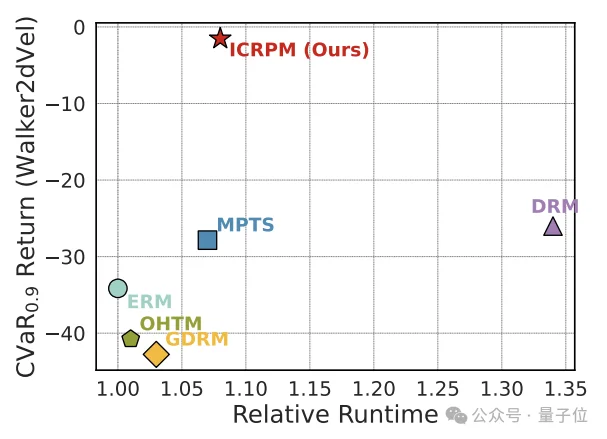
在Meta-RL与DR涉及的五个环境中,ICRPM整体表现出更强的尾部风险鲁棒性。在Walker2dVel上,MPTS的CVaR₀.₉回报为-27.9,ICRPM提升至-1.5;在LunarLander上,论文报告ICRPM收敛时的CVaR₀.₉较ERM提高超过40%。
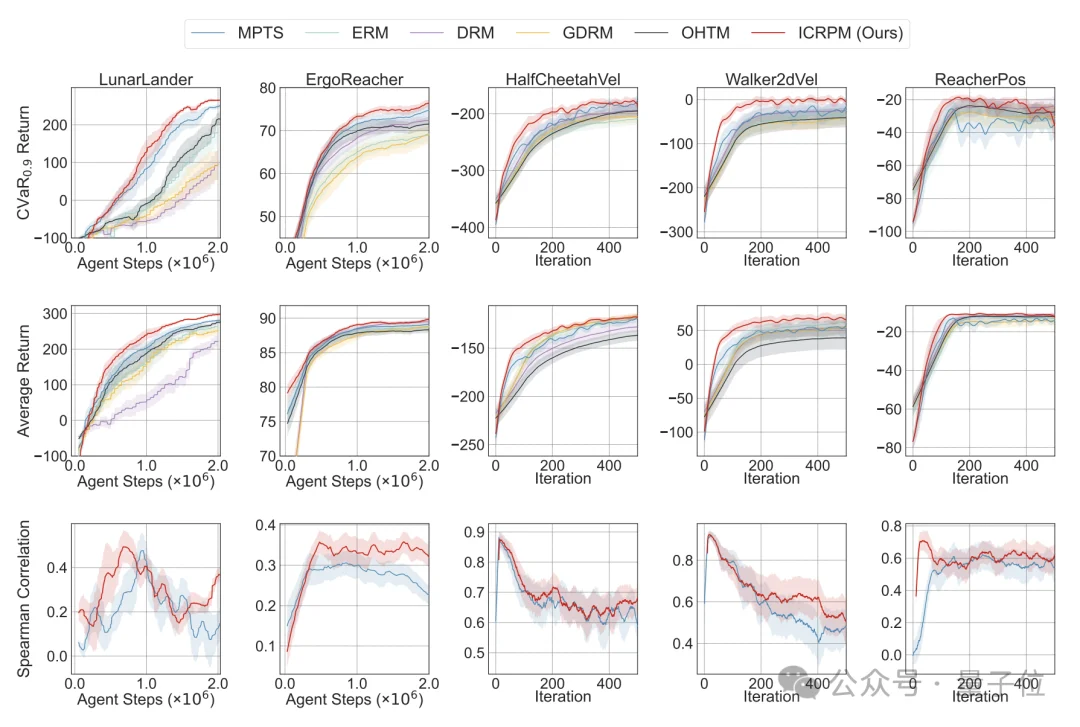
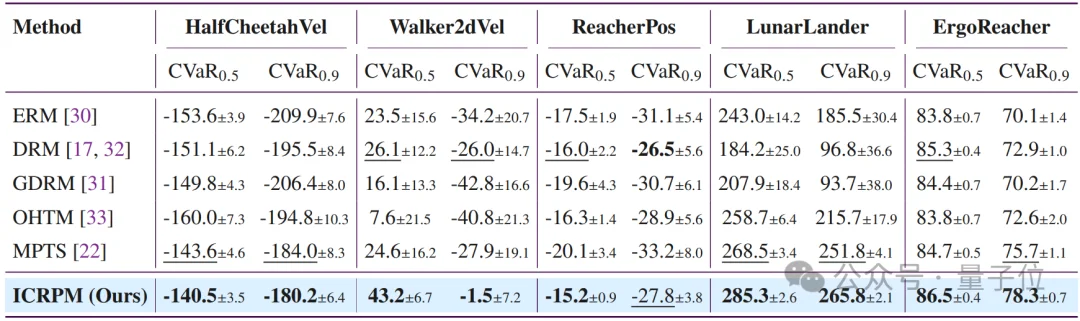
具体来看,Walker2dVel的CVaR₀.₉由MPTS的-27.9±19.1提升至ICRPM的-1.5±7.2;HalfCheetahVel由-184.0提升至-180.2,ErgoReacher由75.7提升至78.3。但并非所有单项指标都领先:ReacherPos上的ICRPM为-27.8,略低于DRM的-26.5。因此,结论应理解为整体趋势改善,而非对所有任务的绝对优势。
在基于Qwen3-4B-Base的Countdown实验中,训练集包含约2万条Countdown-34样本,每个Prompt生成8条回答。ICRPM对Prompt难度的排序相关性明显优于比较方法,并带来更好的最终准确率。
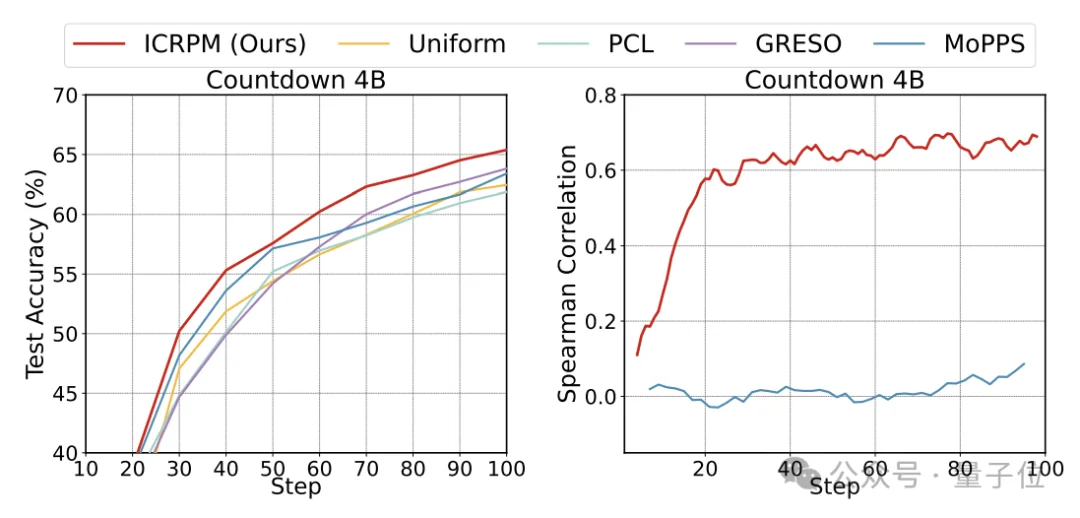
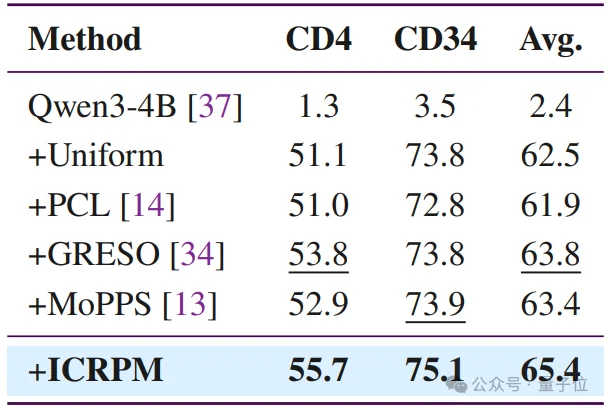
在更难的CD4测试集上,ICRPM的pass@1达到55.7%,比GRESO的53.8%高1.9个百分点,比MoPPS的52.9%高2.8个百分点;在CD34上达到75.1%,两项平均为65.4%。相比Uniform的62.5%、GRESO的63.8%和MoPPS的63.4%平均准确率,ICRPM分别高2.9、1.6和2.0个百分点。
计算成本方面,论文附录报告的一次RLVR实验中,ICRPM与Uniform、PCL、MoPPS的运行时间均约为11.1小时,GRESO约为17.8小时。在Walker2dVel上,ICRPM的相对运行时间为1.08倍ERM,与MPTS的1.07倍接近。
ICRPM提出的思路是:任务难度并非固定不变,好的任务选择器不仅要知道现在什么任务难,还要判断策略更新后什么任务值得训练。通过前瞻式风险预测和近期历史复用,研究在基本维持采样与运行开销的情况下,提高了任务风险排序的可靠性,并将效果验证到连续控制与大模型后训练中。
对于需要精打细算使用rollout预算的训练流程,这提供了一种无需更换下游优化器、从任务选择环节改善训练效率的思路。
论文标题:Bridging Risk Approximation Gaps in Model Predictive Task Sampling via In-Context Modeling
论文作者:Jiarong Wen、Qi Tao、Kaiyu Zhang、Yun Qu、Lizhou Cai、Heming Zou、Yuhang Jiang、Cheems Wang
论文链接:https://arxiv.org/pdf/2610.14913
文章来自于微信公众号 “量子位”,作者 “量子位”

【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
