
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
AI看着自己的脑子改写自己,这一天还是来了!
7630亿参数的DeepSeek-V4.1-Flash,直接读取了自己做数学题时最深7层的内部激活状态。
摸清「快要算偏」的信号规律后,它在不改半个权重的前提下,亲手写了一段Python代码塞进推理流程「读脑自救」!
只要发现思路跑偏就当场回滚重算,在AIME与HMMT 2026数学竞赛上,准确率原地暴涨7个百分点!
而这,还只是今天刷屏AI圈的DoubleAI重磅研究里的一个切面。
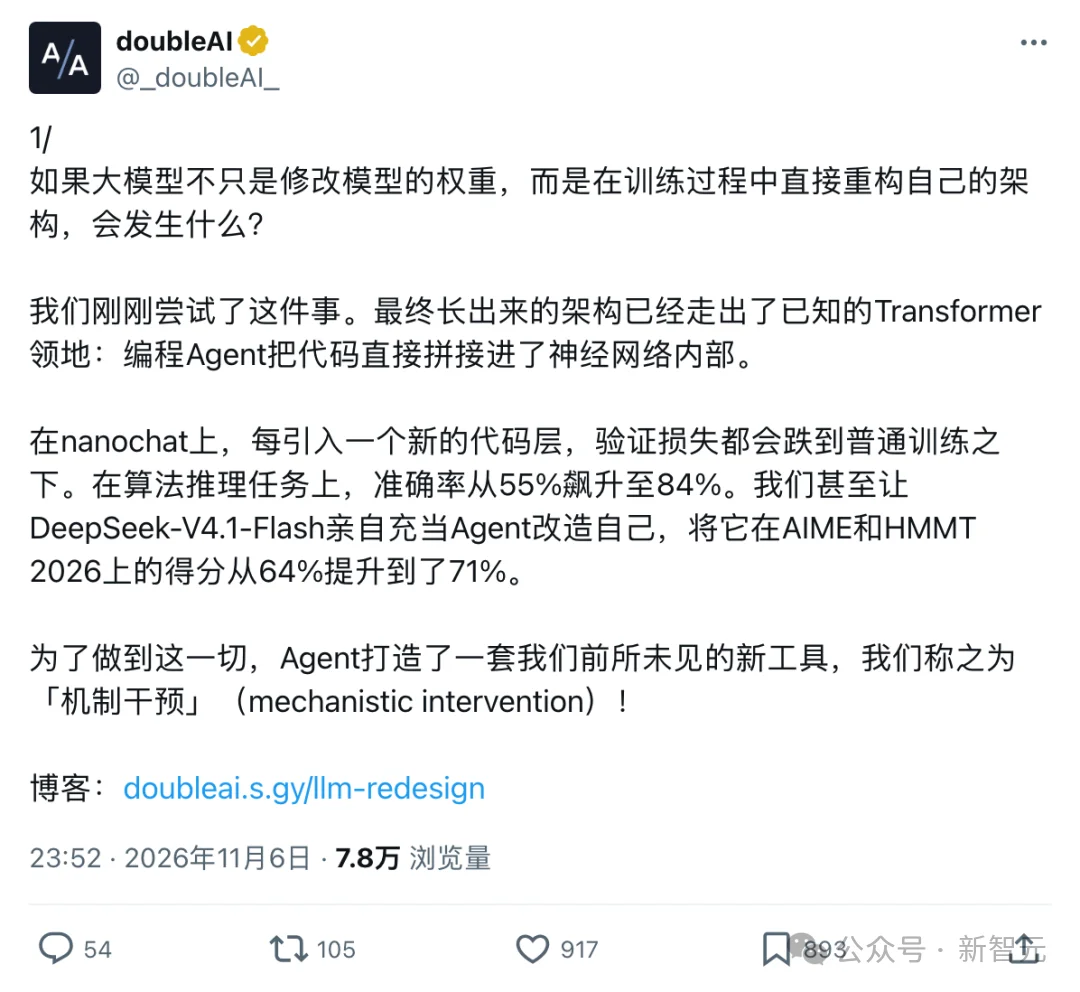
这家由Mobileye创始人Amnon Shashua创立的AI机构,首次提出了一个颠覆传统深度学习的新范式——「机制干预」。
相比以往模型只能在写死的架构里硬调权重,这套方法把编程Agent放进了训练与推理现场。
在训练中途,哪一层网络卡壳了,Agent就当场写几行Python代码塞进模型主干,实时接管计算!
靠着这手绝活,预训练模型只塞入20行代码,就在单次前向推理里跑起了梯度下降。
连塞10层代码后,30种经典算法的准确率更是从55%狂飙到84%!
研究一经发布,迅速在AI圈引发刷屏热议。
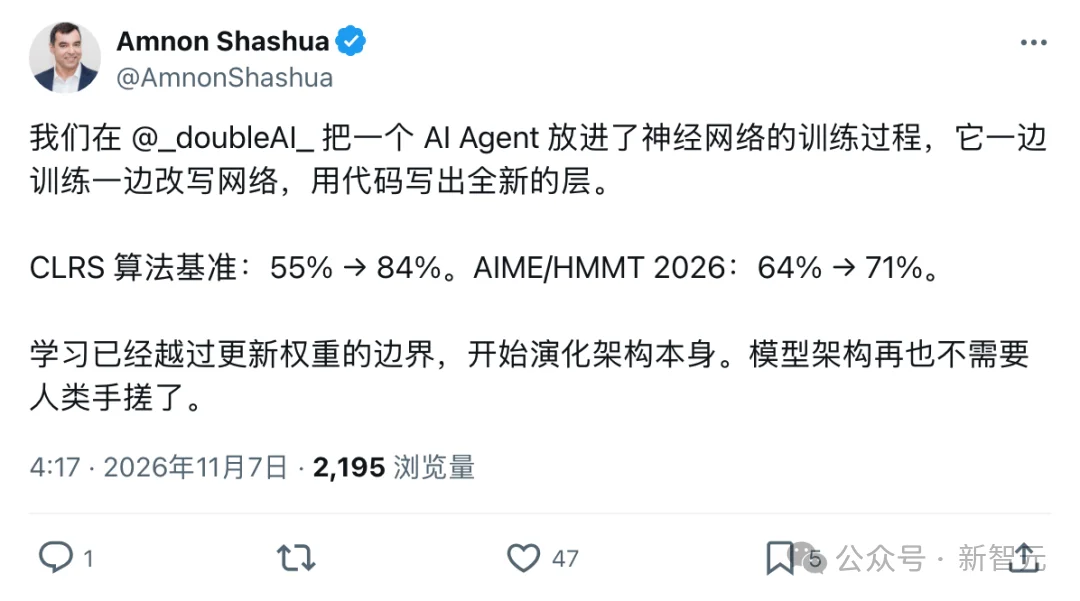
创始人Amnon Shashua放话,深度学习已经彻底跨过了「只调权重」的旧边界。
现在,连神经网络架构本身都能在训练中自主进化,人类手搓模型架构的时代翻篇了!
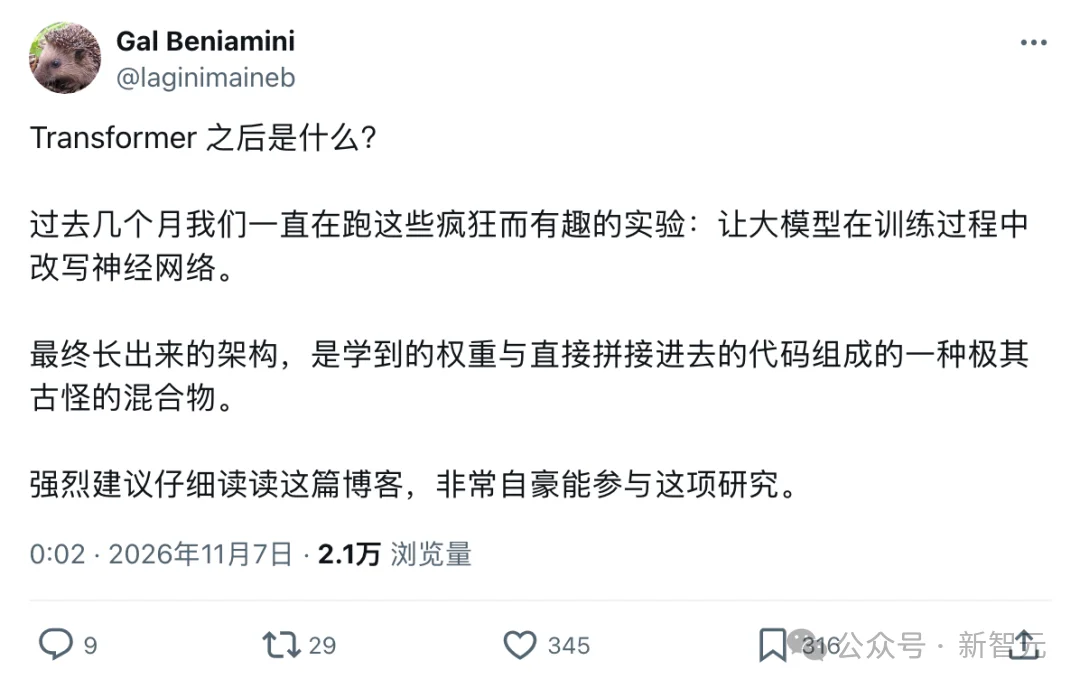
联创Gal Beniamini更是感叹,当放手让大模型边训练边改写自己,最后长出来的架构连研究员都觉得不可思议。
它不再是纯粹的神经网络,而是一半来自训练学出的权重,一半来自半路拼接的Python代码!
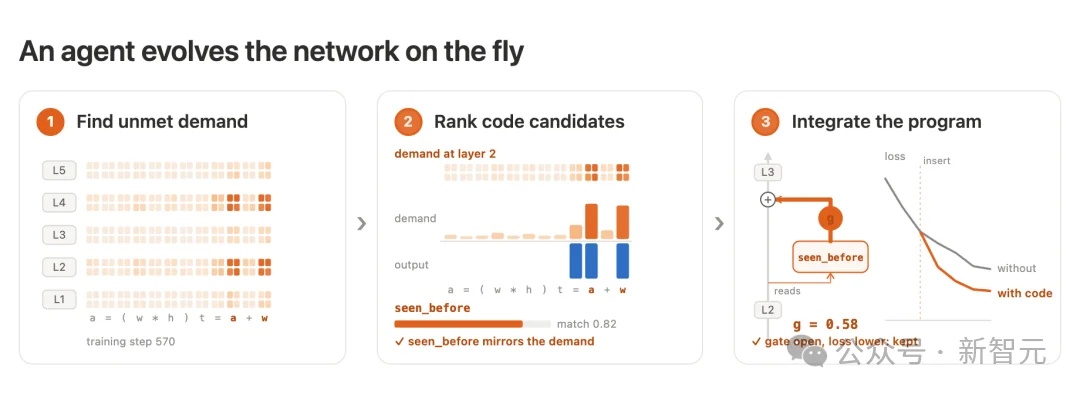
在进入实验细节之前,我们先来看看这套「机制干预」到底是怎么运作的:
第一组实验从语言模型预训练切入,验证训练中途塞入Python代码,能否帮模型更快压低预测误差。
在12层模型nanochat的1500步训练中,Agent先后三次出手塞入Python代码层。
每次代码一并入,模型预测误差(bpb)就随之连降三次!
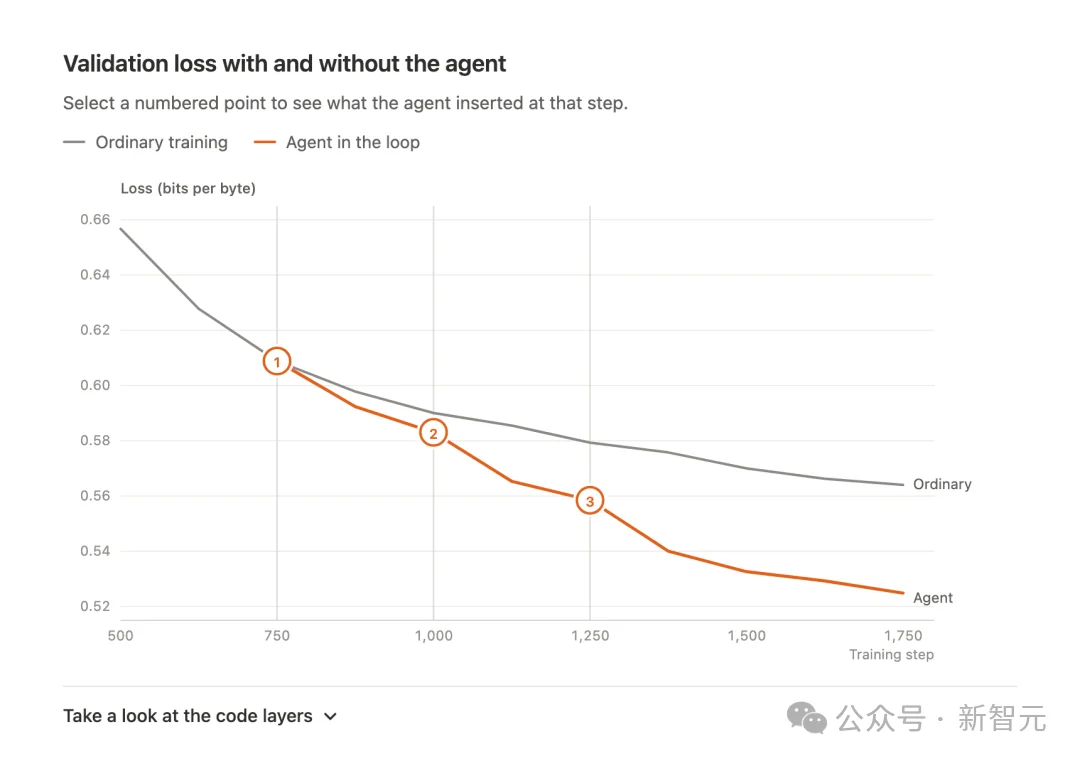
训满1500步后,加代码层的模型相当于白赚了15%的训练进度。
而打乱逻辑的「假代码对照组」与常规训练完全重合,证明提分全靠AI写出的代码逻辑。
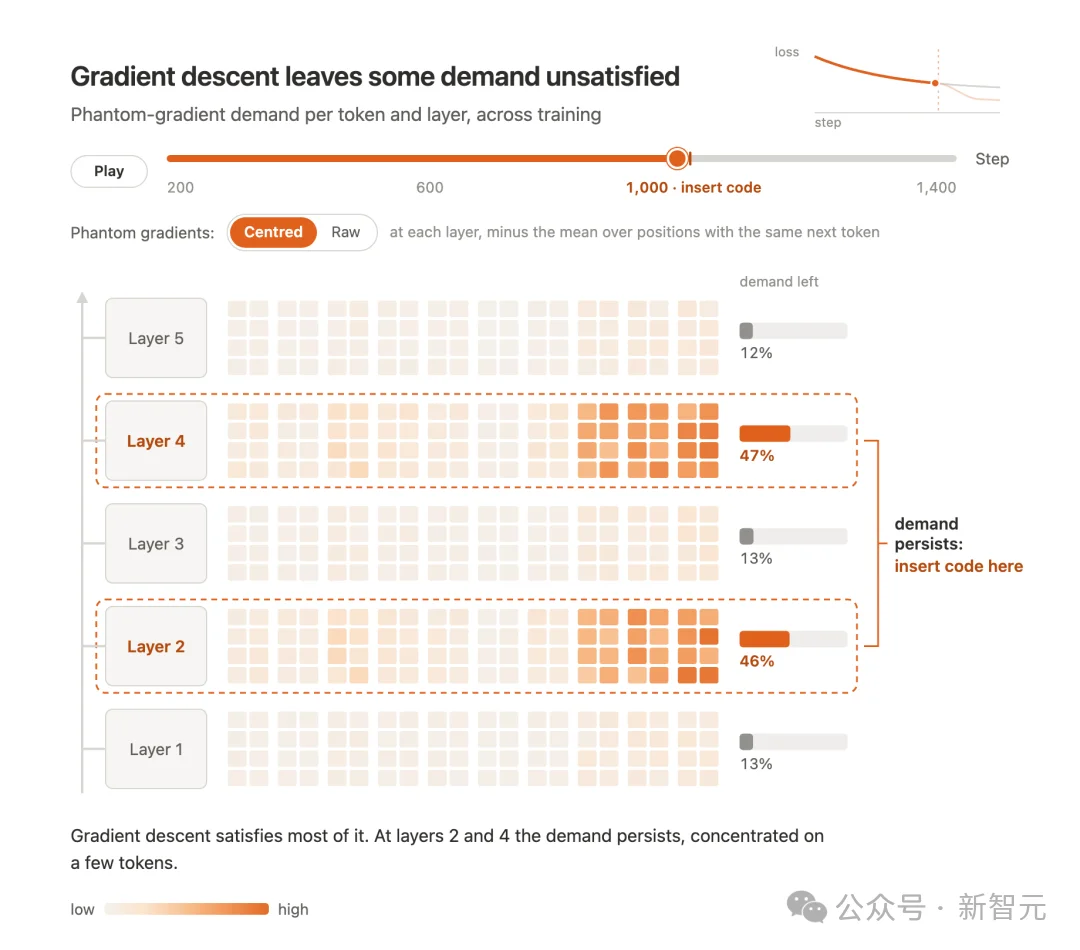
面对12层网络,Agent之所以能找准往哪一层塞代码,靠的是「幽灵梯度」。
它假想在某层后加个新模块,测算往哪个方向推能让误差下降最快。
滤掉常规噪声后,第2层和第4层的高需求热区便清晰显现出来!
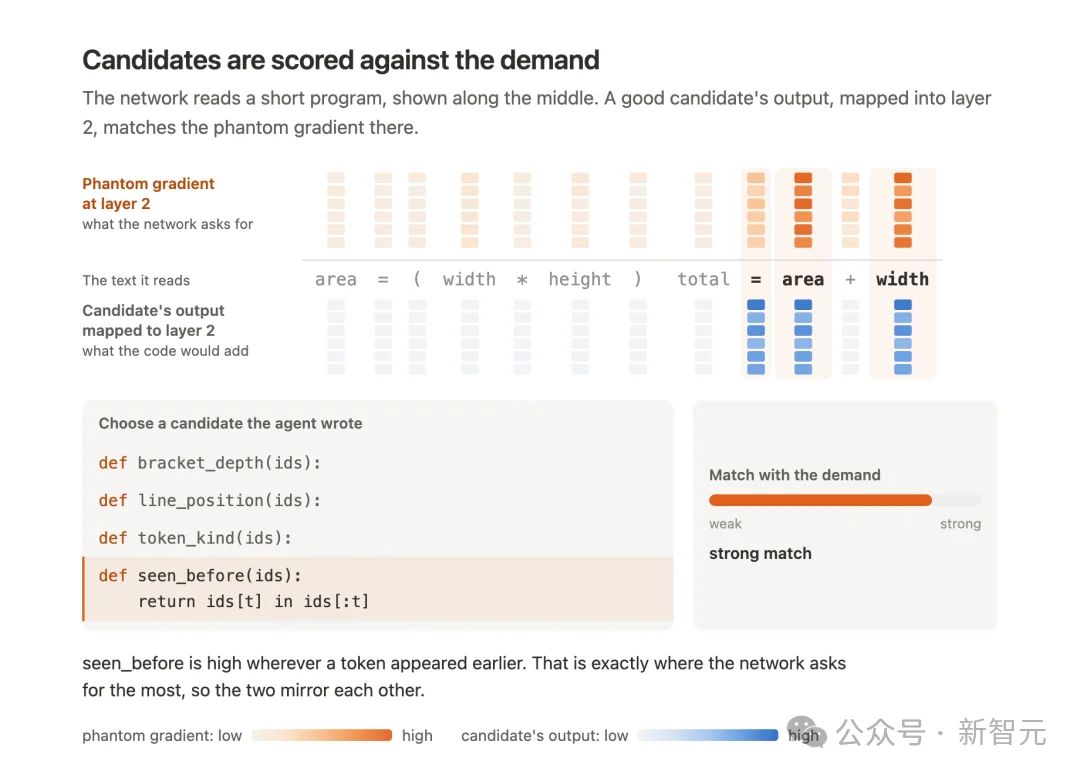
锁定瓶颈层后,Agent写出几十个候选函数,在单批数据上实测谁最契合第2层的梯度方向。
接着,最高分函数挂在初始值为0的门控g后面并入网络。
刚插入时门控输出为0,原有网络不受影响。
但短短100步内,梯度下降发现这段代码真能降误差,便自动把门控调整到了0.58!
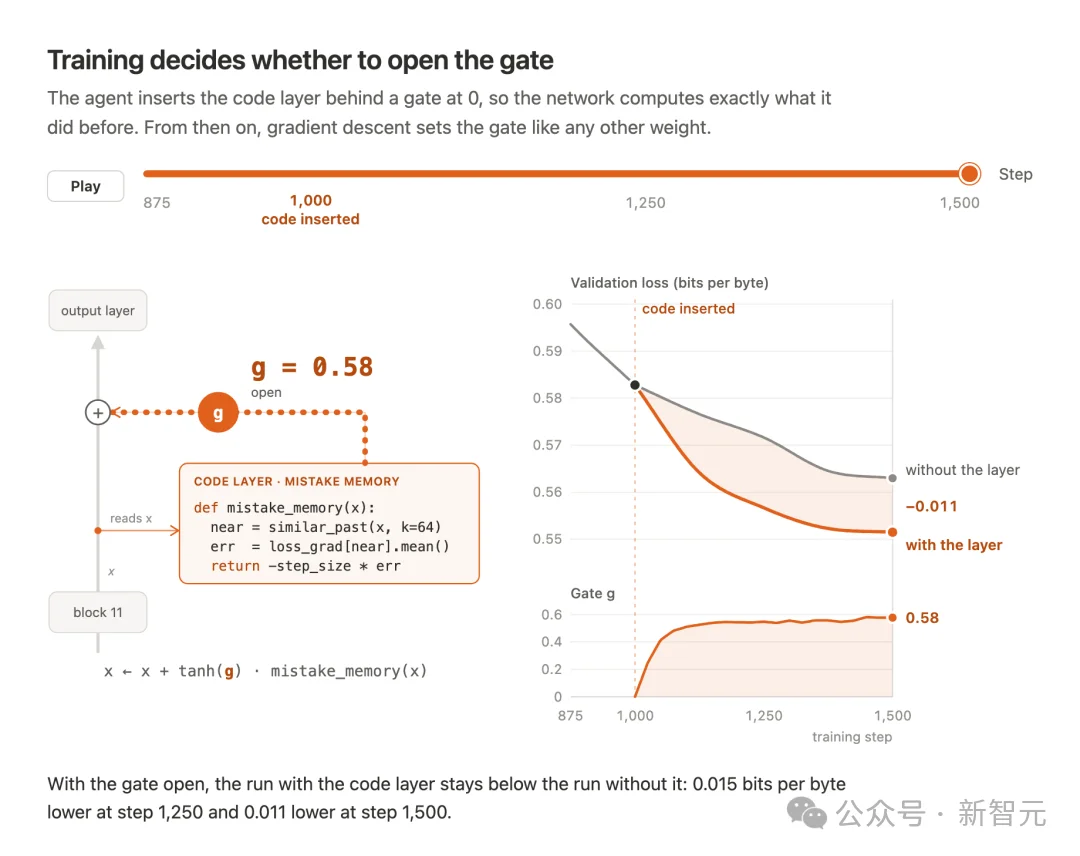
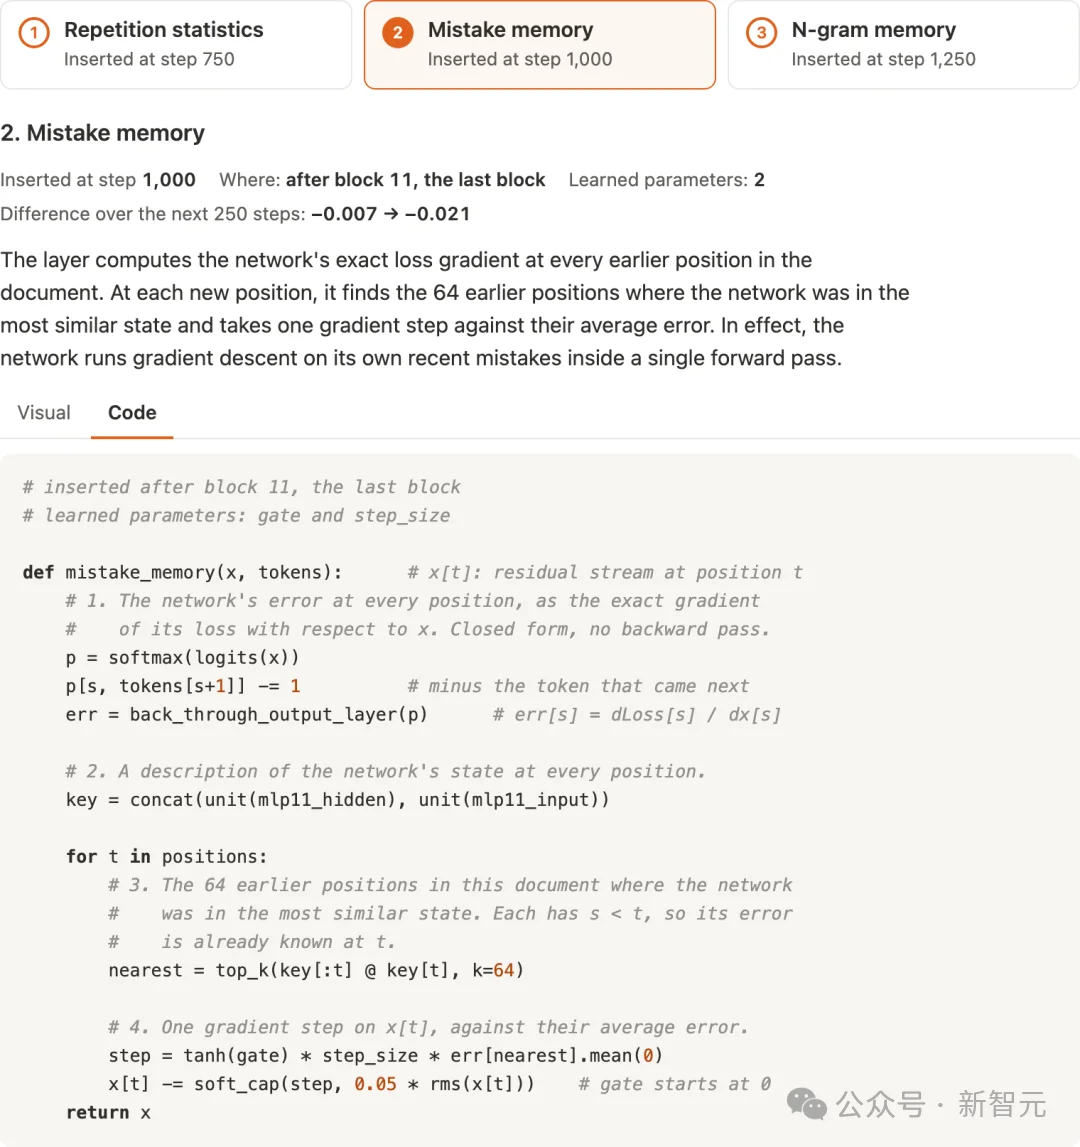
靠着这套流程,Agent在第1000步往末层塞进了一个最惊艳的「错误记忆层」。
这短短20行代码之所以震撼,是因为它打破了以往「前向只能推理、反向才能改错」的定式!
不用等反向传播,模型边往后读就能边核对前文答案,当场算出预测误差,找出64个最相似的犯错位置。
紧接着,它直接在脑子里迈出一步梯度下降,在单次前向传播内实现了边读边纠错!
既然Python代码层这么管用,那么从训练第0步就把代码层装进模型行不行呢?
然而,第二组实验却测出了一个完全反直觉的惊人反转。
团队把模型的记忆窗口锁死在500词以内,考它能不能找回几千词之前的变量赋值。
同时,Agent写了一个能跨窗口查字典的「代码缓存层」,分三种时机装入模型:
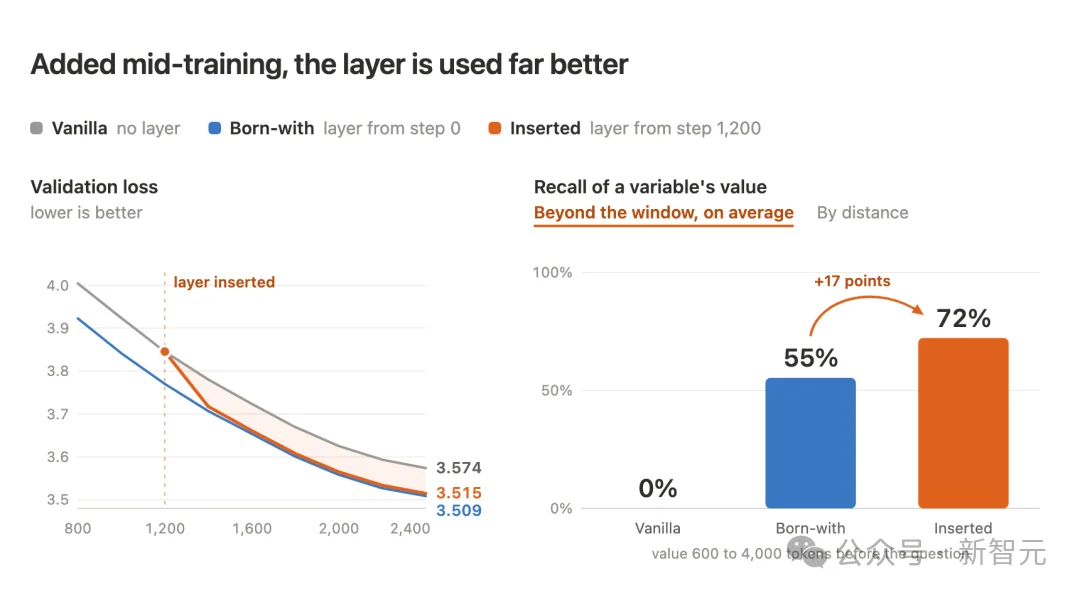
同样的Python代码层,训到半路才插进去,竟然比天生自带高出整整17个百分点!
这个反转揭开了深层原因,如果开训第一天就给现成的代码捷径,神经网络就会「偷懒」依赖外部字典,不去打磨底层表征。
相反,先强迫模型在500词限制下把基础表征练扎实,撞上天花板后再接上Python代码,神经权重与符号代码才能发挥最大合力!
验证了「半路插入」的优势后,第三组实验挑战30种经典计算机算法,检验连塞10层代码能带来什么质变。
传统Transformer学算法有个致命盲区,测试一旦遇上训练跳过的「中间长度」,准确率就会崩盘。
在下图中,常规训练(灰线)碰到未见的中间长度瞬间掉到0%,接入代码层后(橙线)则稳居高位!
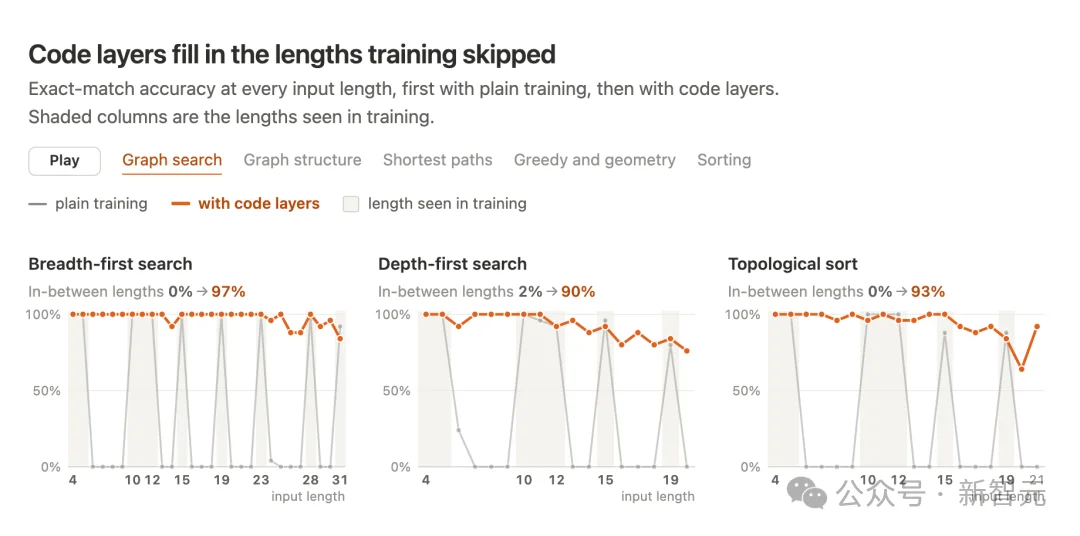
从总分看,常规模型哪怕训满20000步,30种算法总准确率也只能达到55%。
到了第10000步,Agent每隔500步出手一次,一口气连塞了10个Python代码层,帮模型记录「哪些节点访问过」以及「当前最小值」等关键状态。
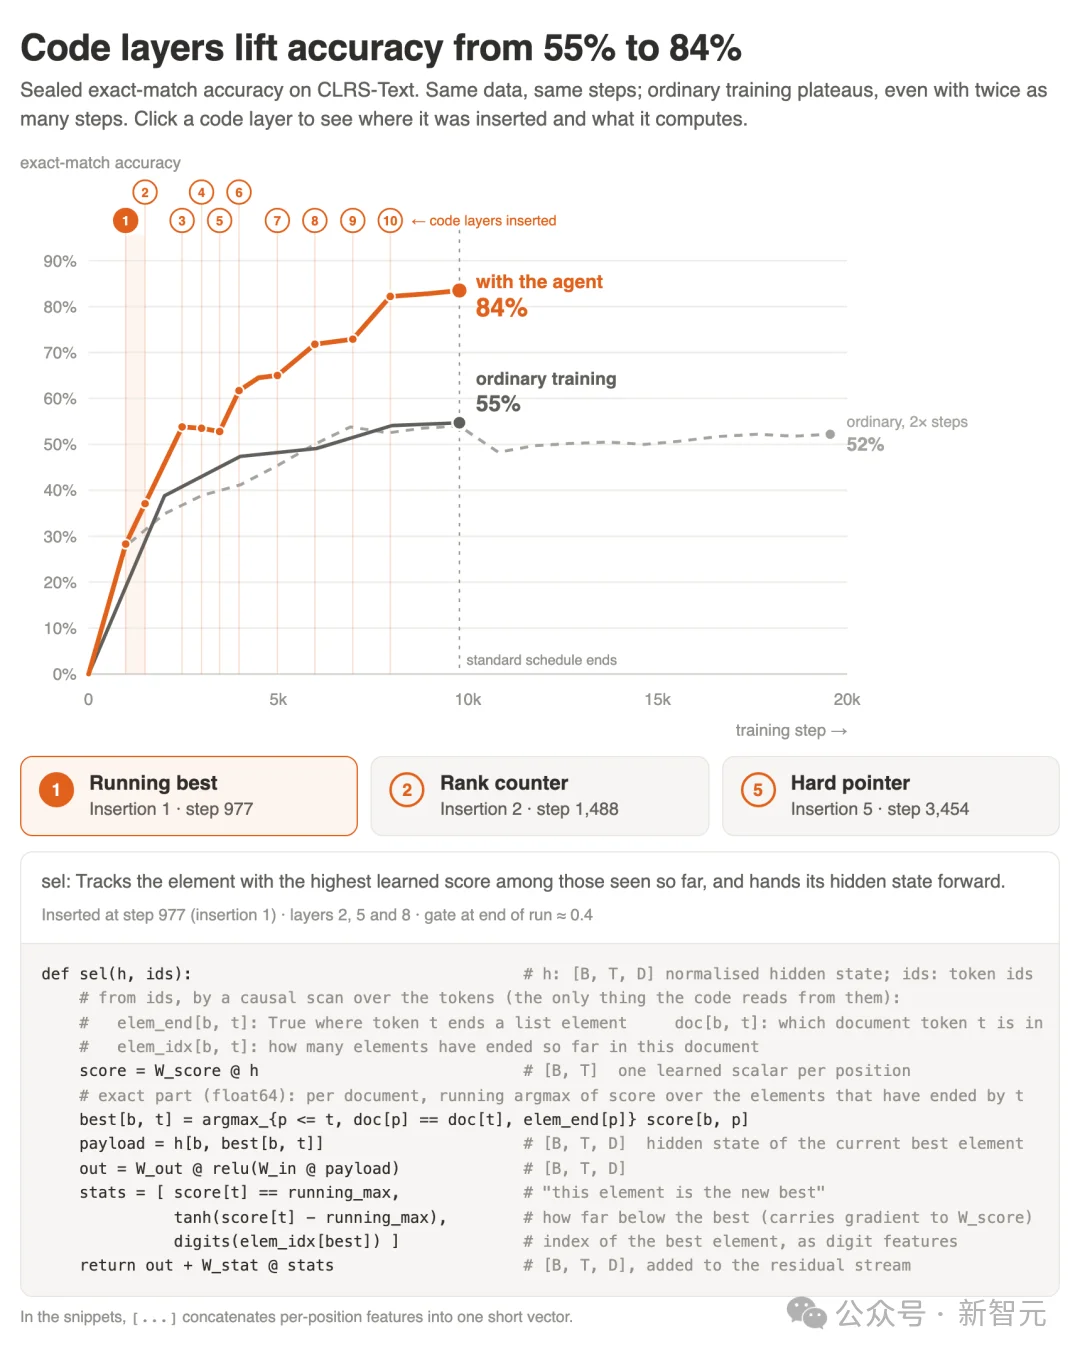
短短5000步后,原本考0分的广度优先搜索干到97%,拓扑排序冲上93%,30种算法总准确率暴涨29个百分点,拿下84%!
之所以能涨分这么猛,是因为神经网络与Python代码在内部打出了精妙配合。
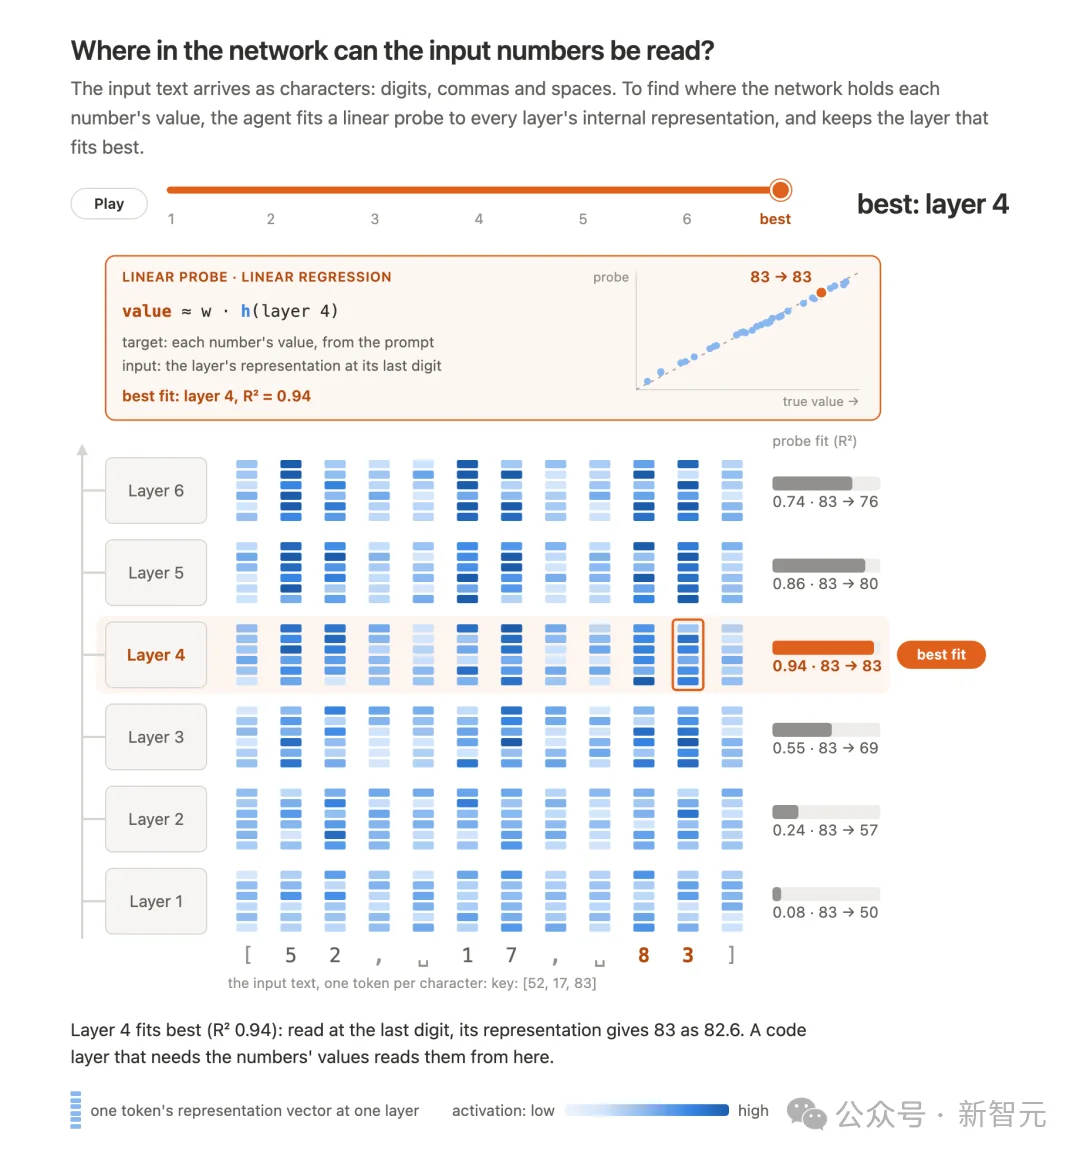
比如代码层需要比较数字大小,但原始输入只是拆散的字符「8」和「3」。
Agent用线性探针挨层检测后发现,到了第4层,神经网络已经把零散字符拼成了真正的数字!
于是,代码层用探针从第4层读出数值82.6,在Python里完成比大小和循环更新后再写回网络,将神经表征与符号计算彻底打通。
视线再回到开篇那一幕,看看已经训好的DeepSeek-V4.1-Flash与Qwen3-8B是如何靠写代码原地进化的。
团队将DeepSeek-V4.1-Flash在243道数学题上的做题轨迹,连同最深7层的内部激活状态交给它自己。
DeepSeek分析完犯错规律后,亲手写出探针重采样程序probe_and_resample,杀进AIME与HMMT 2026考场!
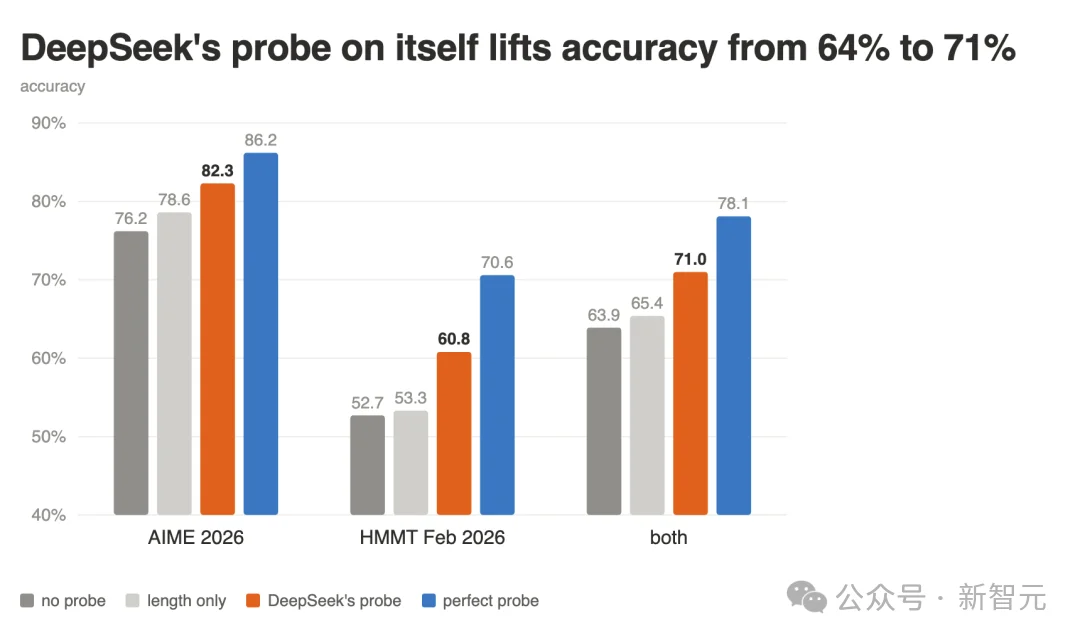
消耗相同的token预算,三组对照高下立判:
不改半个权重就能暴涨7分,全靠DeepSeek给自己写的这段监控代码。
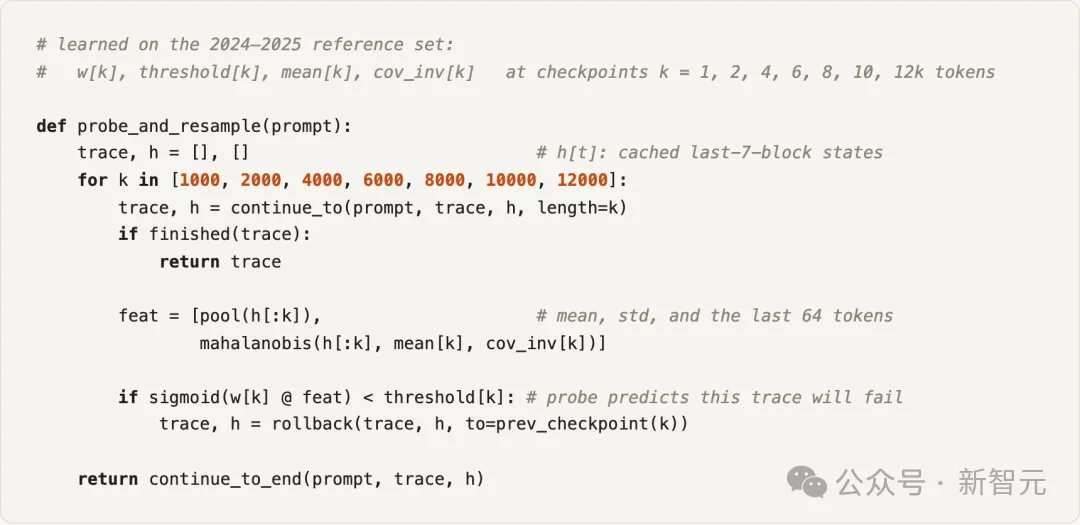
以前大模型一旦走错思路,往往要白白算完几万个token才发现全错。
现在,思维链每推进到检查点,程序就会自动提取最深7层的激活特征打分,一旦测出轨迹偏离正常分布,当场触发回滚重算rollback!
此外,Qwen3-8B也在零梯度更新下,不仅自主进化测试了15000个Python调度策略。
而且在AIME与HMMT 2026考场上,还将准确率从58.5%拉高到65.5%,同样狂涨7个百分点!
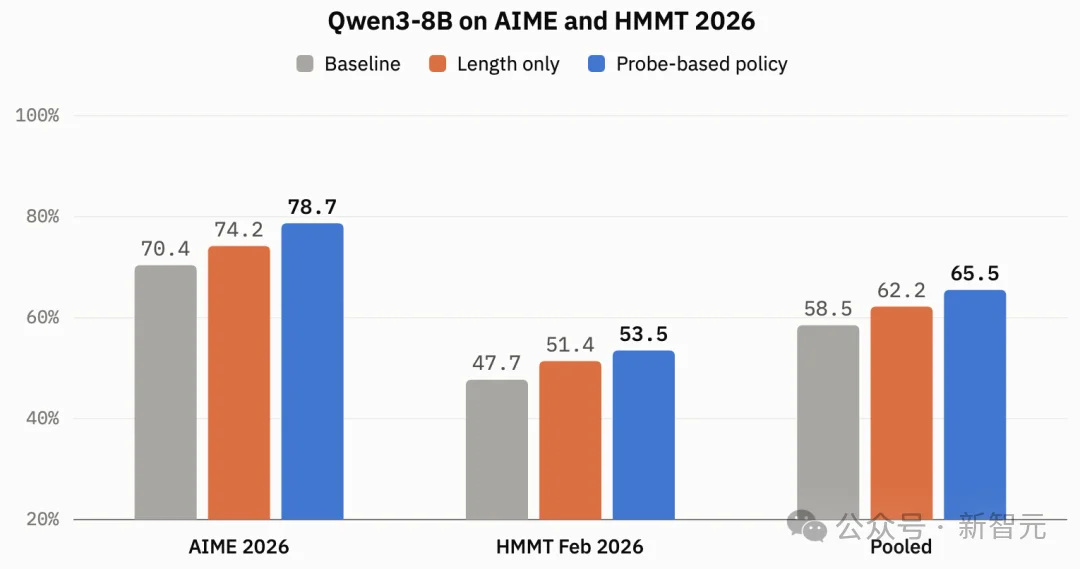
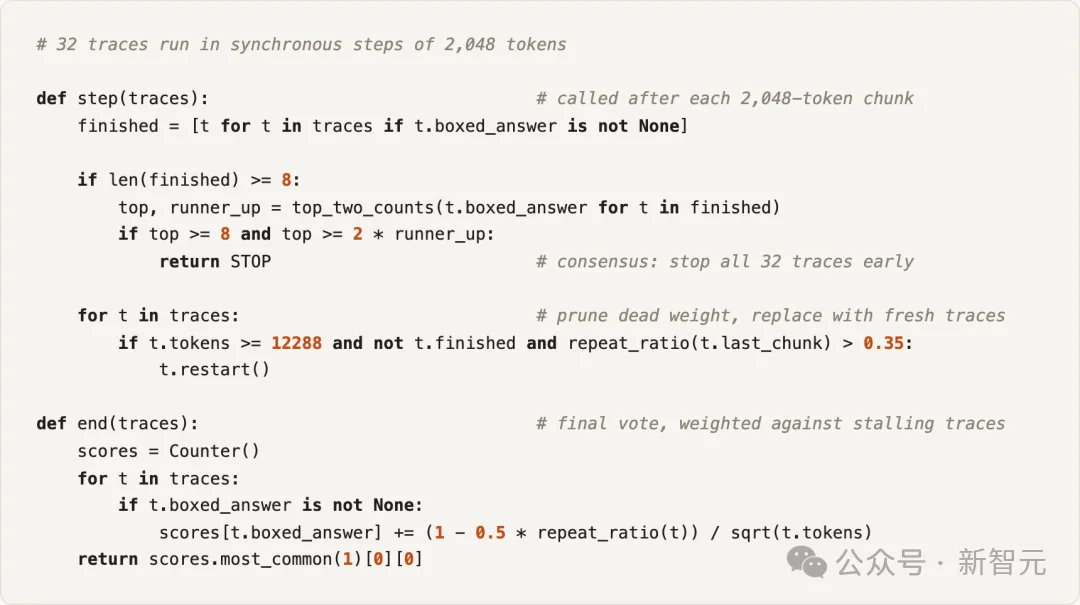
能省下算力实现逆袭,关键在于Qwen3-8B定制的这段代码。
32条并发轨迹每跑2048个token检查一次,满8条算出答案且榜首票数达第二名2倍以上,就提前终止全员省下算力。
而跑满12288个token未算完、重复率超0.35的「死循环复读」轨迹,则会被当场砍掉重启并降权投票!
以上这四组实验,清晰勾勒出了通往超级人工智能(ASI)最关键的一步——递归自我改进。
模型卡在哪个算子、崩在哪个长度,不再需要人类盯着Loss曲线一点点猜,AI读懂自己的内部状态,当场写几行Python代码就能给自己的大脑动手术。
从「人类调权重」迈向「AI写架构」,大模型已经开始亲手接管自己的神经网络,AI真正自我进化的时代,已经来了!
参考资料:
https://www.doubleai.com/research/can-llms-redesign-themselves-as-they-train
https://x.com/doubleaicom/status/2041555517853270296
https://x.com/AmnonShashua/status/2041556445947908456
文章来自于"新智元",作者 "摩西"。

【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
