
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
大语言模型生成文本,并不只有“从左往右单向蹦字”这一条路。
相比自回归模型与离散扩散,连续扩散(Continuous Diffusion)将词映射到连续嵌入空间中迭代去噪,天然具备双向上下文规划与细粒度语义演化的独特优势。
然而,一旦扩展到大模型规模,连续扩散的生成质量却长期落后于离散扩散。
针对这一问题,北京智源人工智能研究院、北京邮电大学与北京大学联合团队提出了全新框架LLaCO。
团队从Embedding空间的本征几何规律出发,在数学上揭示了连续加噪过程中词与词之间的竞争理论,并以此为基石,设计了球面加噪机制与语义时间调度策略。
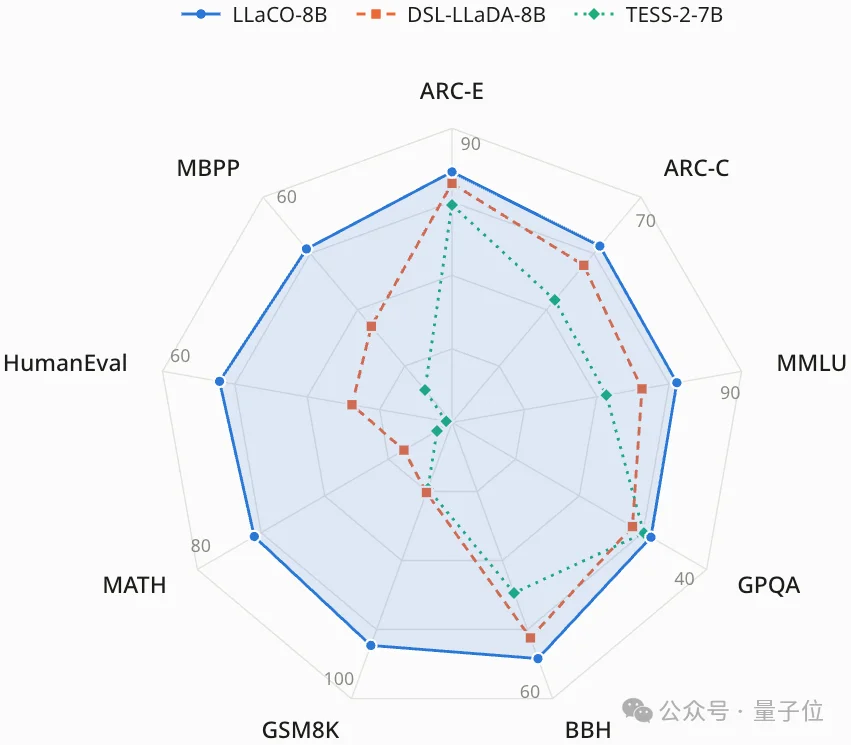
在8B规模下,LLaCO在9项核心基准测试上全面超越以往所有连续扩散模型;在数学推理基准MATH上,LLaCO更是领先离散扩散模型Dream-7B 10.92分。
目前,LLaCO的技术报告与项目主页已发布,相关代码与模型权重也已开源。
在连续扩散中,中间状态还保留着多少源Token的语义身份,直接决定了模型每一步的去噪目标。因此,要想设计出科学的加噪与采样方案,关键在于讲清Token身份是如何衰减的。
团队的技术路线分为两步:首先推导出“源Token什么时候会被竞争词反超”以及“身份衰减集中发生在哪个阶段”;随后基于这些理论,针对性改造预训练模型的加噪轨迹、时间步调度与输入方式。
判断一个中间状态还“像不像”源Token,最直接的方法是看它在全体词表中的相似度排名。但如果沿用传统的欧氏距离来排序,就会出现严重的失真:随着加噪过程中向量模长的衰减,模长偏小的词在没有噪声扰动时也会排到前面。使用这种与语义无关的“虚假反超”分析Token身份的衰减,会带来错误的结论。
因此,Token之间的竞争必须在方向空间中进行度量。只有当噪声的有效投影强度超过了候选词与源词之间的语义间隙,真正的反超才会发生——团队将这一规律描述为竞争阈值理论。进一步结合真实语言模型的几何先验,高维空间中的Token几乎两两正交,彼此在方向上相距甚远。这意味着反超需要异常极端的噪声:在4096维的表征空间中,即便噪声达到信号的11倍,也只有约10%的源Token会丢掉第一名。换句话说,在高维空间中,除非被逼入接近纯噪声的极深区域,一个Token很难被真正“认错”。
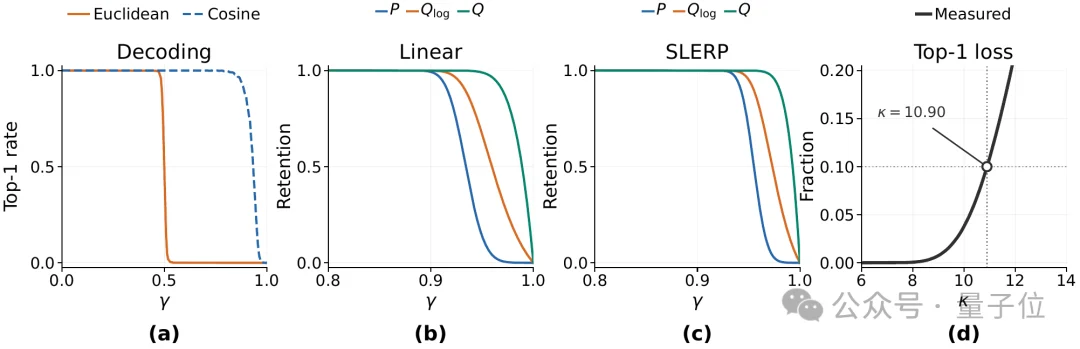
这种极高的反超门槛,直接导致了严重的“时间压缩”现象:在标准加噪轨迹中,源Token的身份衰减被压缩在接近纯噪声终点的狭窄窗口内。这导致传统加噪方案把90%以上的训练预算白白浪费在源词身份几乎不变的前期,而在真正发生剧烈竞争的质变阶段,模型反而处于严重欠拟合状态。
好在理论同时证明,反超阈值独立于时间步调度。这就意味着,完全可以按照Token身份真实的衰减进度重新分配时间步,把计算预算分配到身份真正发生变化的关键区间。
为了度量这一进度,团队审视了现有的评估指标。只看第一名的Top-1保持率在源词首次被反超后直接归零,丢失了后续所有动态;而按比例统计所有反超的线性保持率,又会被庞大词表的长尾严重稀释,对最关键的前排排名变化不够敏感。为此,团队提出了对数排名保持率(Qlog),在对数尺度上衡量排名下滑,放大前排排名的变化。在真实预训练嵌入上,无需任何参数拟合,该理论预测曲线与实测数据高度重合,关键位置的误差在2%以内。
以“language”为例,标准线性加噪下,它的排名下滑几乎全部挤在最后约9%的步数里;按对数排名保持率重新分配步数后,下滑过程被摊开到约90%的加噪进程中。
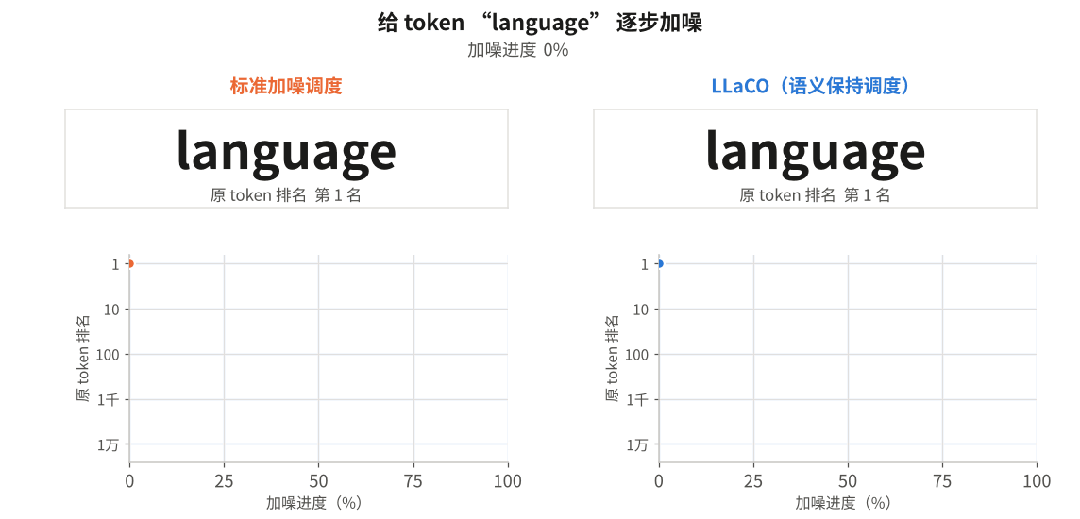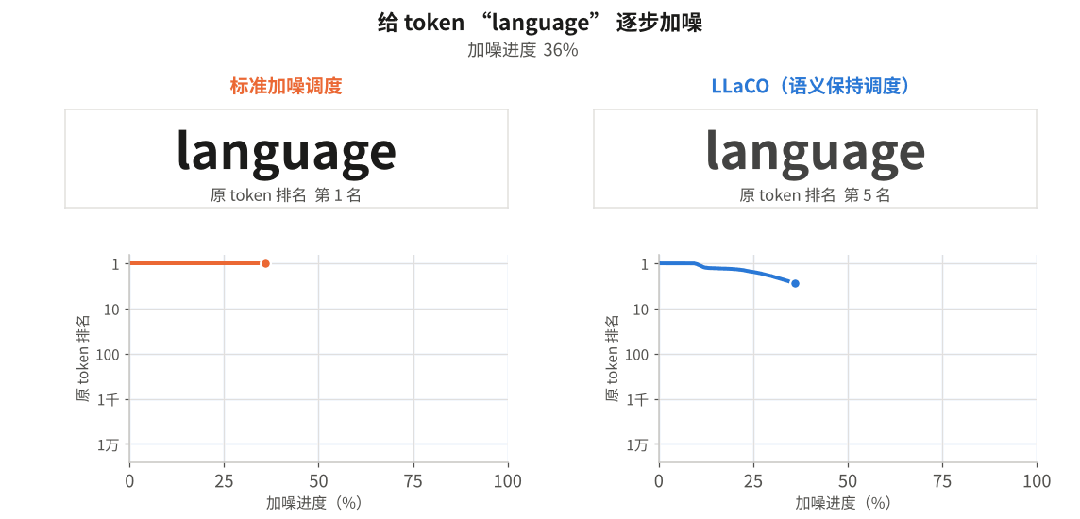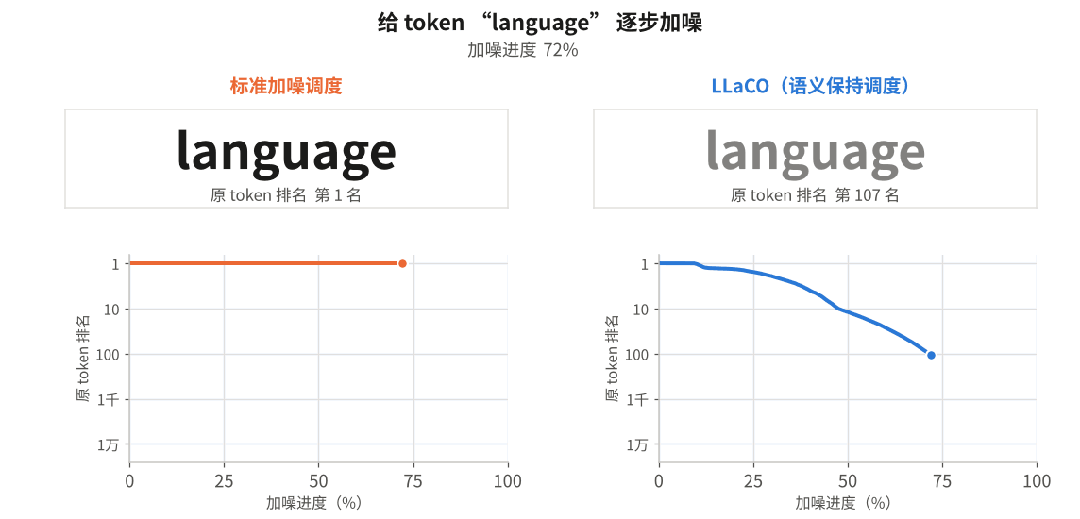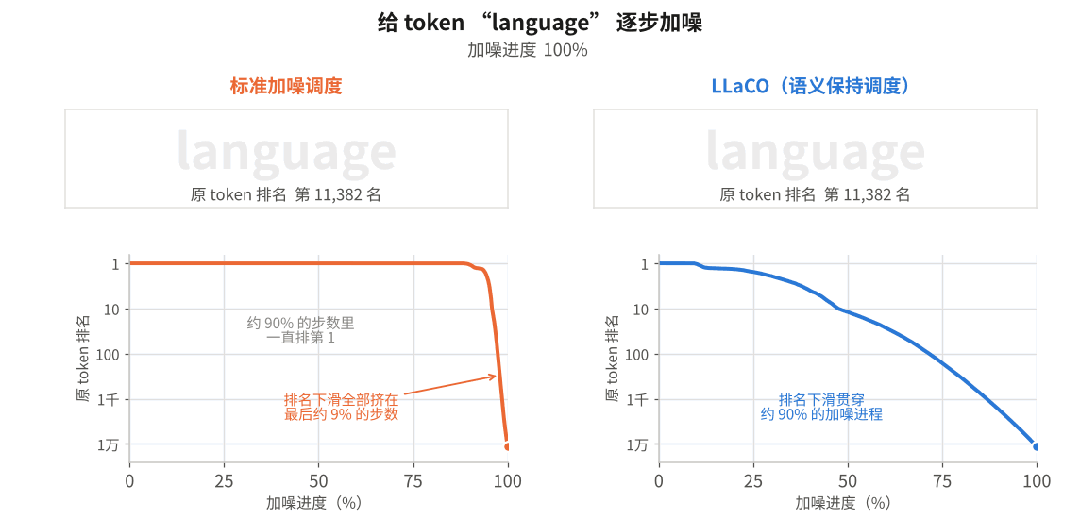
理论讲清之后,下一步是把这些结论真正落到模型上。
LLaCO没有从零训练连续扩散模型,而是在离散扩散模型的基础上进行改造。要让改造真正有效,需要解决三个问题:加噪时如何避开虚假反超,训练和采样步数该怎么分配,模型如何读懂连续状态。对应到结构上,主要包含以下三项设计。
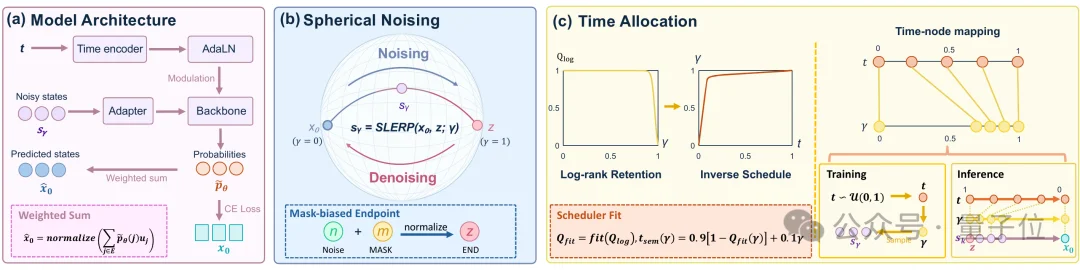
LLaCO将加噪过程约束在单位超球面上,保持状态范数恒定,让词与词之间的竞争完全由语义方向决定,规避范数衰减带来的虚假反超现象。同时,加噪终点还融入了离散扩散中[MASK]语义锚点,让模型继承离散扩散模型强大的上下文先验。
高维语义空间存在严重的“时间压缩”现象:在加噪的大部分时间里,源词一直稳居榜首,真正的排名转变仅发生在极窄的窗口内。LLaCO据此提出了基于对数排名衰减的语义时间调度机制。通过语义时间调度,可以识别出源词身份正在快速丧失的“剧变期”,并将训练与推理预算集中于此,提升训练与采样效率。
离散扩散模型天然习惯处理确切的离散词向量,难以理解扩散过程中的连续状态。为此,LLaCO设计了轻量级的方向适配器,将球面上的连续状态对齐到离散词表空间;同时搭配“时间步自适应层”注入动态去噪步长,赋予模型连续去噪感知能力,实现了高质量的平滑生成。
团队在8B规模上,将LLaCO与同规模的连续扩散模型TESS-2、DSL-LLaDA,以及离散扩散模型LLaDA-8B、LLaDA-1.5-8B、Dream-7B进行了对比。
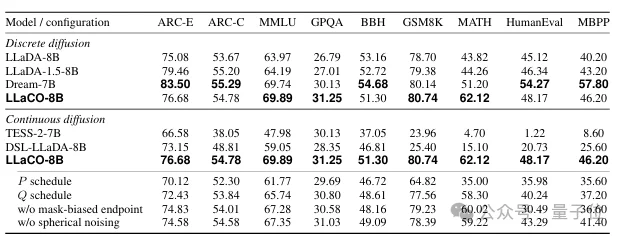
LLaCO-8B在全部9项基准上都超过TESS-2和DSL-LLaDA,其中数学和代码上的优势最大。相比最强的连续扩散模型,它在GSM8K上提升55.34分,在MATH上提升47.02分,在HumanEval上提升27.44分。
与LLaDA-8B、LLaDA-1.5-8B和Dream-7B相比,LLaCO-8B在MMLU、GPQA和GSM8K上取得领先;MATH更是以62.12分位列所有对比模型第一。
论文标题:LLaCO: Continuous Diffusion for Large Language Models with Competition-Aware Semantic Scheduling
作者:Zijian Jia*、Peixuan Zhang*、Genying Li、Di Wu、Yujie Fu、Si Li、Boxin Shi、Shuchen Weng(*为共同第一作者)
作者单位:北京智源人工智能研究院、北京邮电大学、北京大学
项目主页:https://escapistmost.github.io/LLaCO/
技术报告:https://arxiv.org/html/2610.32604v1
代码链接:https://github.com/WhenGIX/LLaCO
模型权重:https://huggingface.co/escapist413/LLaCO-8B
文章来自于"量子位",作者 "LLaCO团队"。

【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
