多Agent也会帮倒忙!80B给9B支招,准确率反降23.6个百分点 | NeurIPS'26
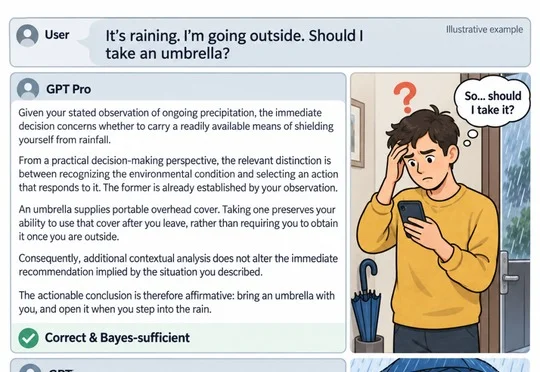
多Agent也会帮倒忙!80B给9B支招,准确率反降23.6个百分点 | NeurIPS'26Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。
搜索
Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。
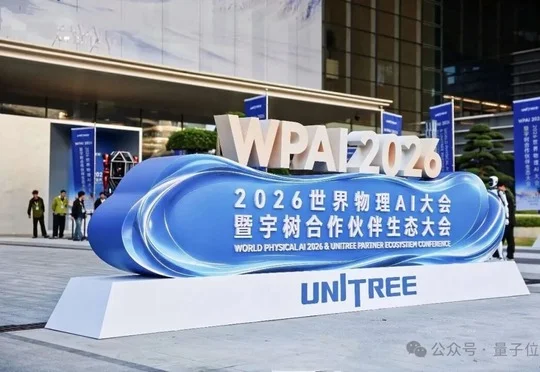
在2026宇树科技合作伙伴生态大会上,宸境科技(DeepMirror)展示钢铁行业物理AI全栈方案,以宇树四足机器狗结合Insight系列空间智能相机、NavCore空间智能大脑和任务管理平台实现自主巡检,方案已落地湘潭钢铁、晋南钢铁等钢企。
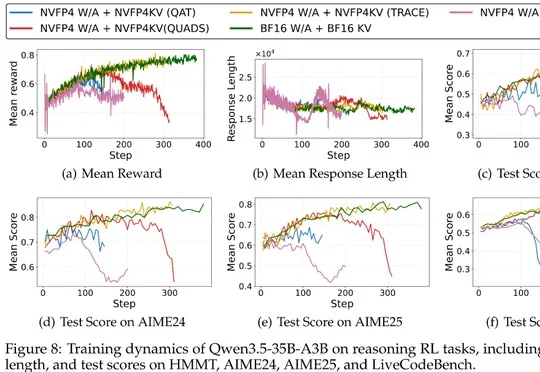
阿里千问联合俄亥俄州立大学提出TRACE,以Rollout侧FP4量化结果引导训练侧舍入,在四个Qwen MoE模型上保持接近BF16的性能,并使128K输出解码吞吐最高提升5.4倍。
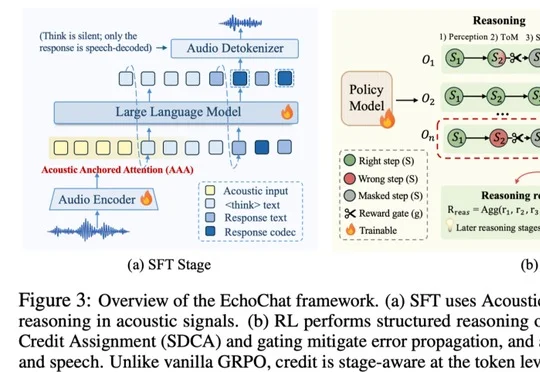
EchoChat将共情语音对话拆分为感知、心智理论推理和回复生成,并通过Acoustic-Anchored Attention与Step-Decomposed Credit Assignment统一优化,在三项评测中取得领先表现。
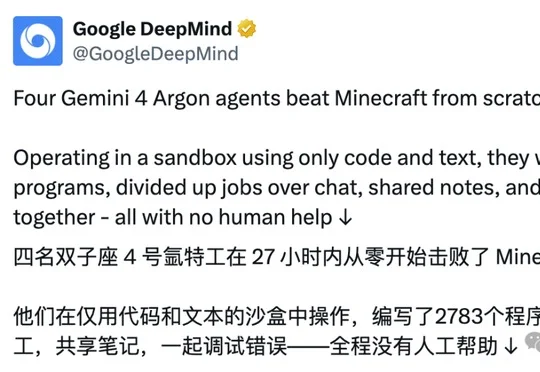
Google Deepmind让4个Gemini 4 Argon Agent在随机《我的世界》地图中自主协作27小时,累计阵亡605次、耗费约520美元后击败末影龙,展示其长程任务中的分工、纠错与恢复能力。
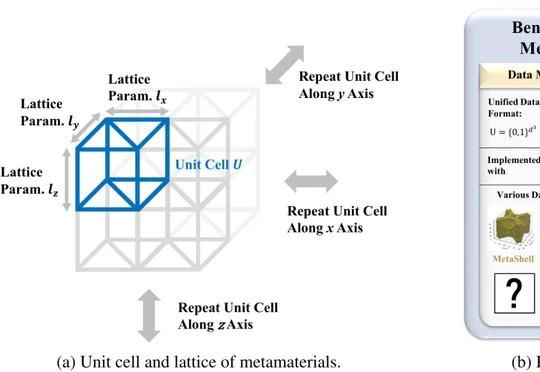
弗吉尼亚理工大学与Meta团队提出ReGDiff,通过RAS整理潜空间并用SRR短程排斥引导扩散采样,在MetaTruss和MetaShell上较最强基线平均提升几何合理性8.9%、新颖性46.4%和多样性128.6%。
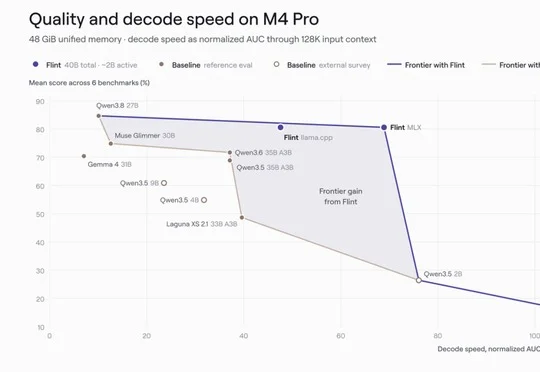
田渊栋参与创立的Recursive_SI发布首个模型Flint-40B-A2B,该模型由Eureka Machine全程参与、不到4个月从零打造,专注本地硬件智能体编程,并以400亿总参数、每Token激活25亿参数实现高速运行。
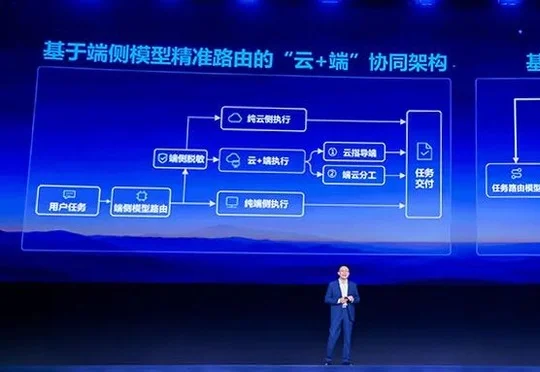
科大讯飞发布端云一体基座模型讯飞星火X2.6和语音基座模型SparkAudio 1.0,星火X2.6基于全国产算力训练,云端293-A30B支持百万token上下文,输入缓存未命中及输出价格低于DeepSeek-V4.1-Flash-1017,端侧X2.6-4B已开源。
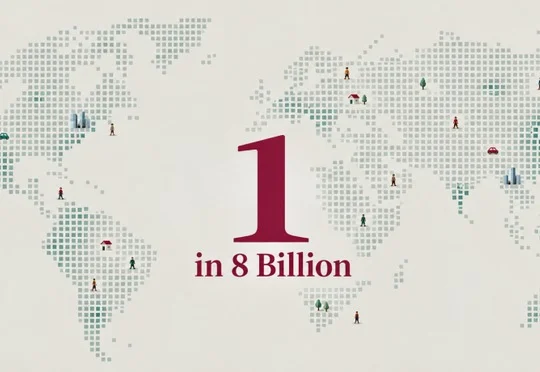
独立开发者借助Claude约4小时做出网页游戏1 in 8 Billion,支持按172个国家和地区的统计数据随机投胎并模拟一生,随后在韩国和日本社交平台传播。
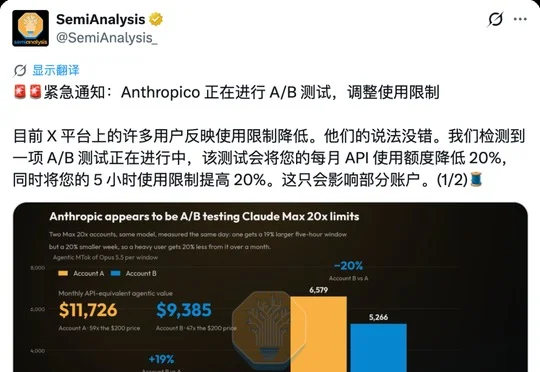
SemiAnalysis 测试发现,Anthropic 正对 Claude Max 20x 的 Opus 5.5 订阅额度进行 A/B 灰测,测试账号周额度被下调 20%,Claude Code 团队称正紧急排查且否认调整额度。