国产芯片大杀器!全栈开源,断网狂飙千亿模型
国产芯片大杀器!全栈开源,断网狂飙千亿模型一张96GB显存的专业卡卖13.8万元,一套128GB的DDR5内存逼近2.5万元。
来自主题: AI资讯
9315 点击 2026-10-15 14:15

 搜索
一张96GB显存的专业卡卖13.8万元,一套128GB的DDR5内存逼近2.5万元。
亚马逊正洽购AI公司Decart,潜在估值约70亿美元;Anthropic曾在约60亿美元交易谈判后放弃推进,Decart的DOS可适配多厂商芯片并提升AI训练与推理效率。
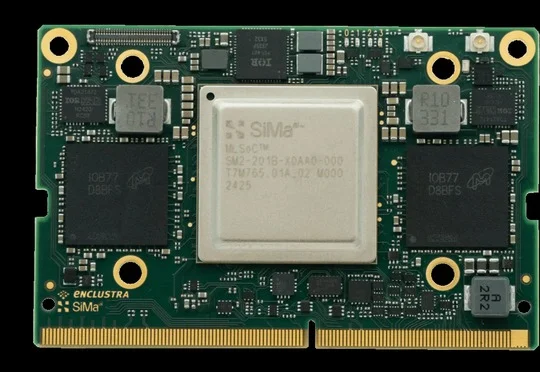
图片来源:SiMa.ai SiMa.ai是一家开发芯片和软件的初创公司,能让机器人、无人机、摄像头等设备直接在设备端运行AI。该公司近日完成1.5亿美元C轮融资,估值达14.5亿美元。本轮融资由Fid
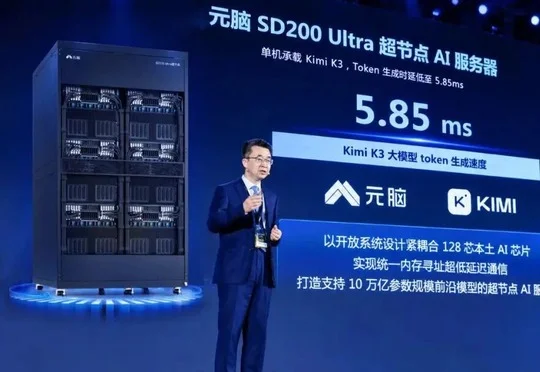
浪潮信息在AICC 2026发布搭载128芯本土AI芯片的元脑SD200 Ultra超节点AI服务器,通过超级算子融合技术将2.8万亿参数Kimi K3的Token生成时延降至5.85毫秒,与海外Inferact以"巨内核"路线共同打响万亿参数模型推理效率战。
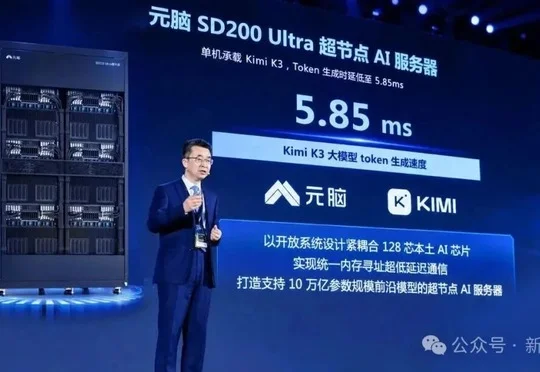
Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
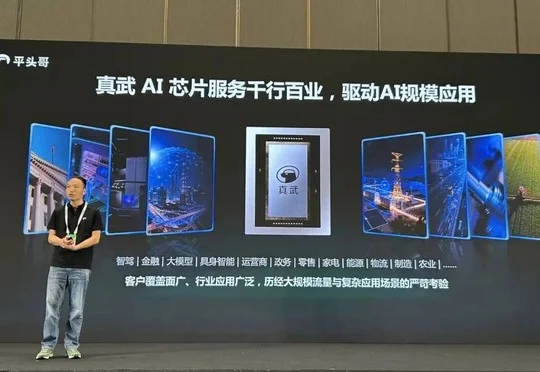
henry 发自 凹非寺 量子位 | 公众号 QbitAI “这是目前中国算力性能最强的AI芯片,性能达到M890的3倍。” 9月22日的云栖大会上,阿里巴巴集团CEO吴泳铭这样介绍新一代真武V900
本期节目对比了Groq、Cerebras与OpenAI在推理芯片上的三条技术路径,指出业界正围绕SRAM提升带宽性价比进行系统级异构收敛,并分享了英伟达首席科学家Bill Dally关于局部性与追求全局最优的芯片设计哲学。
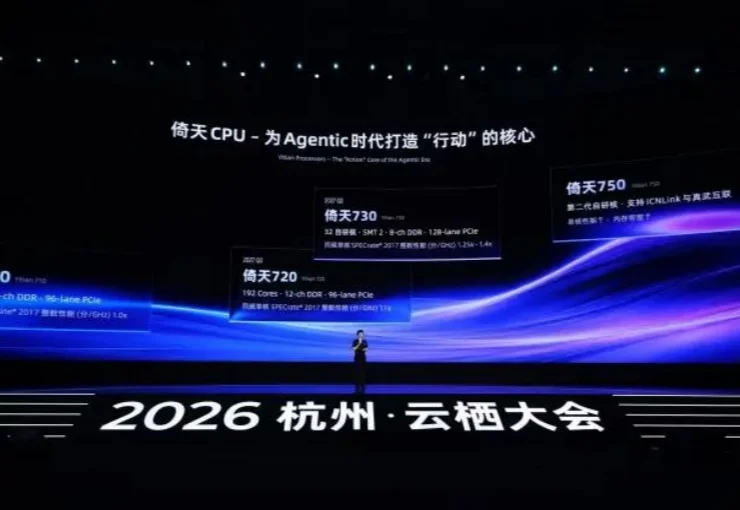
从真武 V900 到新一代磐久超节点服务器,平头哥八年来陆续布局的 AI 芯片、CPU、scale up 互联、scale out 网络和存储芯片,开始被装进同一套算力系统。
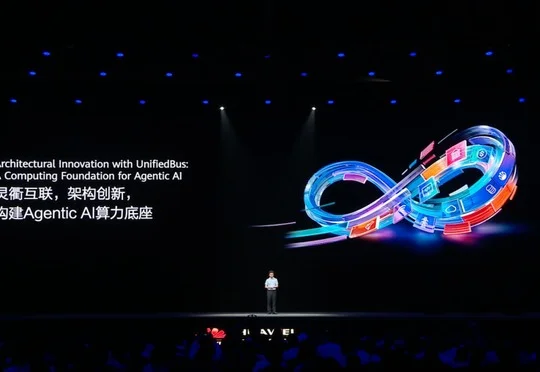
在华为2026年全联接大会上,华为发布"灵衢"统一互联总线协议及昇腾960超节点、OceanStor M900 AI记忆存储等AI基础设施新品,使10万卡集群模型浮点算力利用率从20%提升至35%,并支持单集群100万颗AI处理器。
高通提前剧透下一代骁龙旗舰移动平台的核心升级:Oryon CPU首次实现5GHz主频并引入动态缓存架构FlexCache,Hexagon NPU推出Element Accelerator与更大共享内存,Adreno GPU首次加入Matrix Cores并集成AI图形渲染技术Adreno Neural Fusion,全面强化端侧智能体AI性能与体验。