

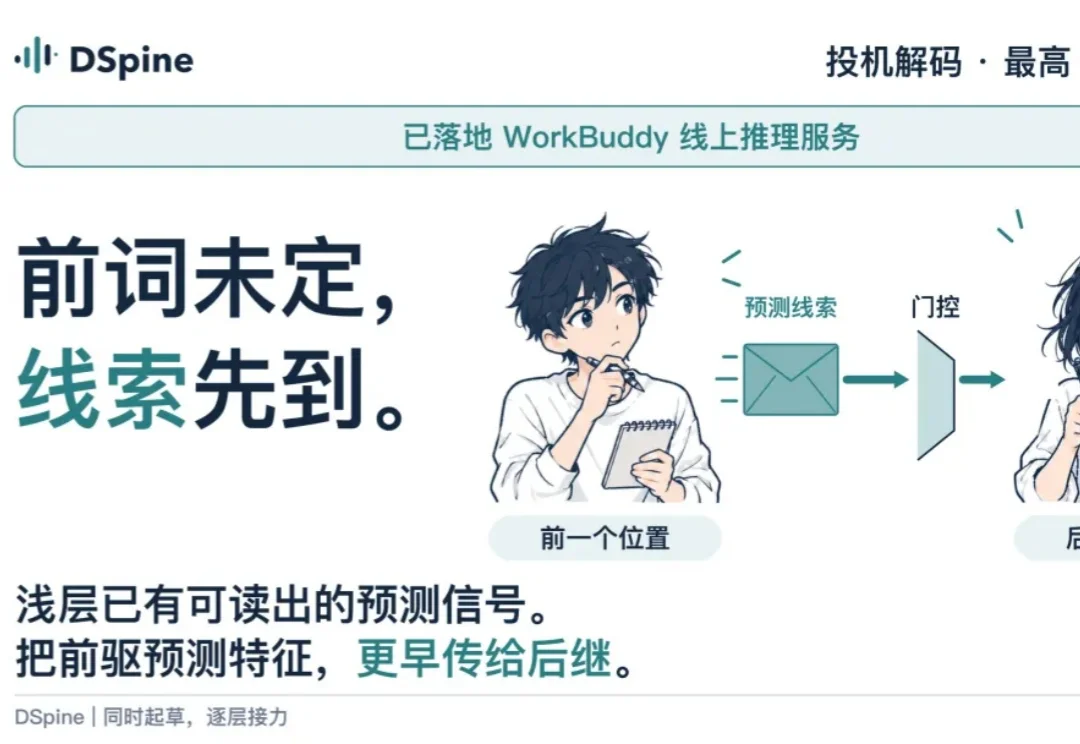
并行推测解码SOTA!因果依赖刻进草稿网络深度,SGLang吞吐最高达4倍,已开源
并行推测解码SOTA!因果依赖刻进草稿网络深度,SGLang吞吐最高达4倍,已开源在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 token,大幅压缩了起草耗时。
来自主题: AI技术研报
6308 点击 2026-11-10 09:23