AI资讯新闻榜单内容搜索-LSA

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: LSA
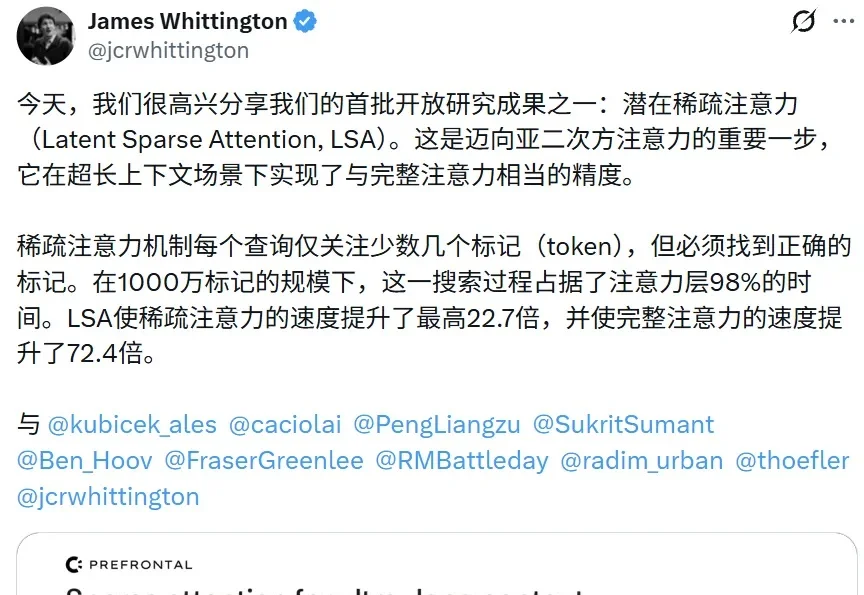
千万token下,比DeepSeek式稀疏注意力再快22倍

千万token下,比DeepSeek式稀疏注意力再快22倍

千万token下,比DeepSeek式稀疏注意力再快22倍

如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。

来自主题: AI技术研报
9118 点击    2026-11-17 16:25
多Agent也会帮倒忙!80B给9B支招,准确率反降23.6个百分点 | NeurIPS'26

多Agent也会帮倒忙!80B给9B支招,准确率反降23.6个百分点 | NeurIPS'26

多Agent也会帮倒忙!80B给9B支招,准确率反降23.6个百分点 | NeurIPS'26

Bo Liu课题组在NeurIPS 2026论文中发现,多Agent通信并非信息越充分越好,Qwen3-Next-80B-A3B向Qwen3.5-9B发送消息使ContextBench准确率提高14.2个百分点,却令ToolSandbox下降23.6个百分点,并提出无需重训模型的按需通信策略。

来自主题: AI技术研报
8200 点击    2026-10-24 13:42
生成式人工智能浪潮下,国外AI初创公司都在做什么?

生成式人工智能浪潮下,国外AI初创公司都在做什么?

生成式人工智能浪潮下,国外AI初创公司都在做什么?

预计到 2032 年将达到 882 亿美元,人工智能教育市场释放巨大潜力

来自主题: AI资讯
6583 点击    2024-05-16 10:38