梁文锋狙击战:深扒那些梁文锋署名的论文有多牛
梁文锋狙击战:深扒那些梁文锋署名的论文有多牛过去三年,梁文锋极少以第一作者或通讯作者身份,出现在 V3.2、V4、V4.1-Flash 这些动辄上百人署名的旗舰模型整体报告中;却始终把名字签在 MLA 注意力、MoE 路由机制、mHC 拓扑流形、DSpark 推理算子、DSec 智能体沙盒这些最底层的原子技术论文上。
来自主题: AI技术研报
8438 点击 2026-09-25 10:13

 搜索
过去三年,梁文锋极少以第一作者或通讯作者身份,出现在 V3.2、V4、V4.1-Flash 这些动辄上百人署名的旗舰模型整体报告中;却始终把名字签在 MLA 注意力、MoE 路由机制、mHC 拓扑流形、DSpark 推理算子、DSec 智能体沙盒这些最底层的原子技术论文上。
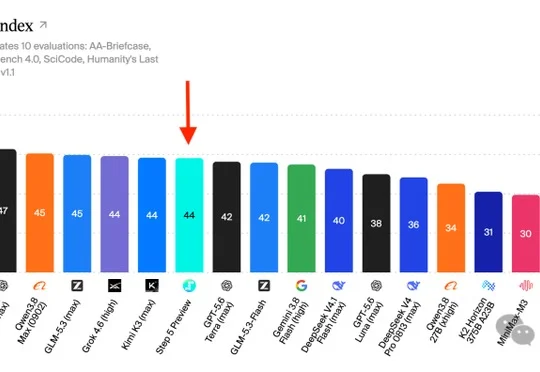
阶跃星辰发布新一代旗舰基座模型Step 5 Preview,以44分的AA智能指数成绩跻身全球开源模型前三,采用600B总参数/27B激活的稀疏MoE架构并原生支持1M上下文,在代码生成、长程Agent、深度研究与金融尽调等场景表现突出。
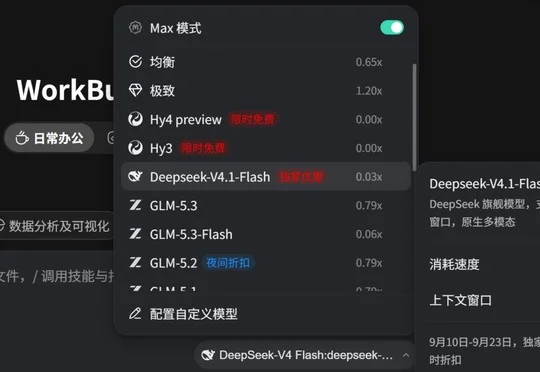
DeepSeek V4.1 Flash 正式在网页、App 和 API 端全面上线,采用 552B 参数的 MoE 架构与 Causal-Encoder-Decoder 设计,性能全面超越 V4 Pro 并原生支持多模态,DeepSeek Harness v0.1.5 也同步适配。
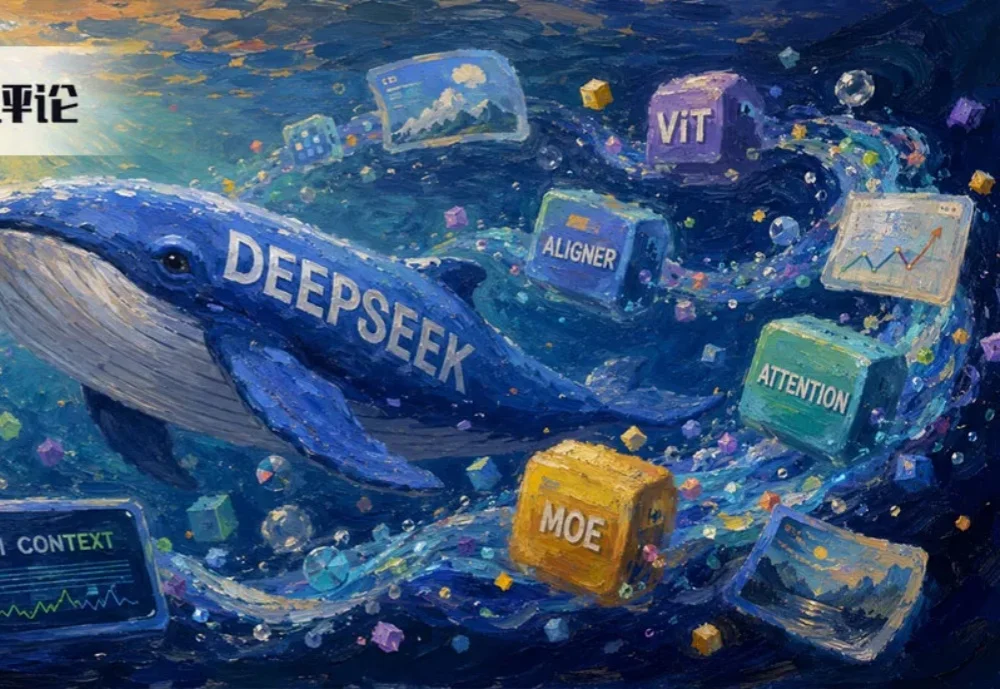
图片不只被编码,还直接参与 Attention、MoE 与 Agent 推理。
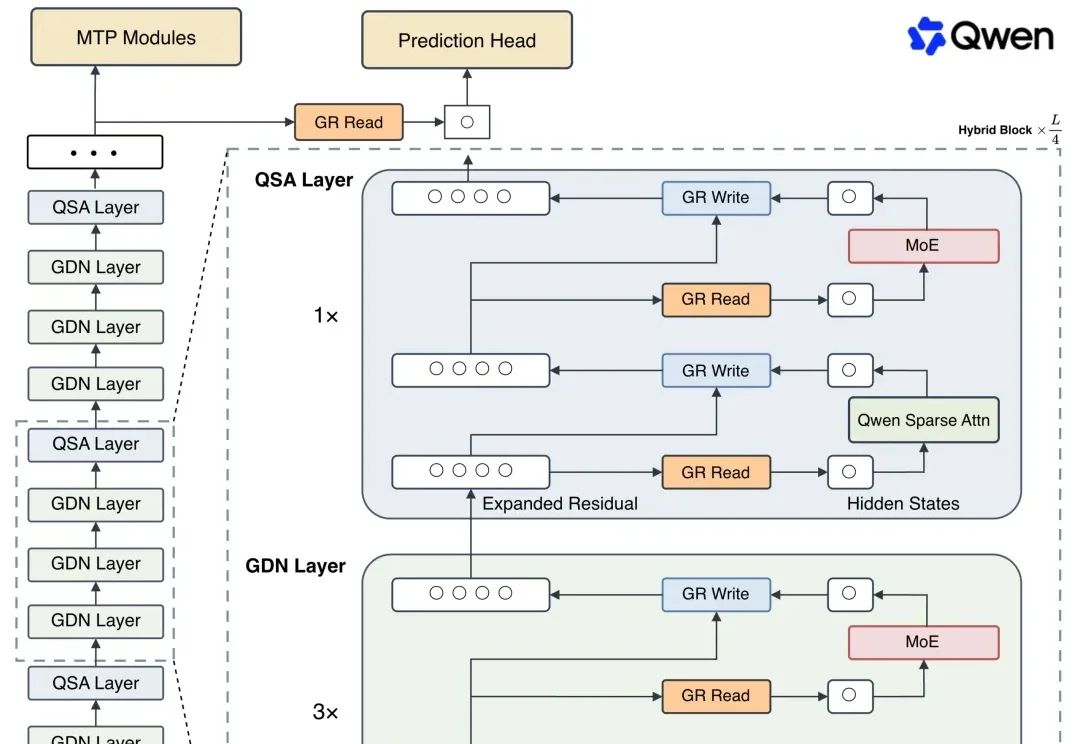
Qwen4还没出,架构先开源了。
今日,蚂蚁百灵大模型开源了一款轻量级混合推理MoE模型——Ling-3.0-tiny。该模型总参数量为7.9B,推理时激活参数量为1.3B,主要面向高效本地部署而设计。其同步提供BF16、FP8和INT4三个版本,已在DGX Spark、MacBook、Mac mini等设备上完成验证,兼顾性能、效率与可部署性。

在“灵晟”国产超算登顶最新一期全球超级计算机TOP500榜单后,清程极智与“灵晟”联合完成纯CPU MoE模型分布式推理方案:16节点即可流畅运行DeepSeek-V3/R1-671B模型,在batch_size=2048时,输出吞吐量与80张主流GPU集群相当。

再牛的大模型,也要放到行业面前公开露个面,才算真交卷。
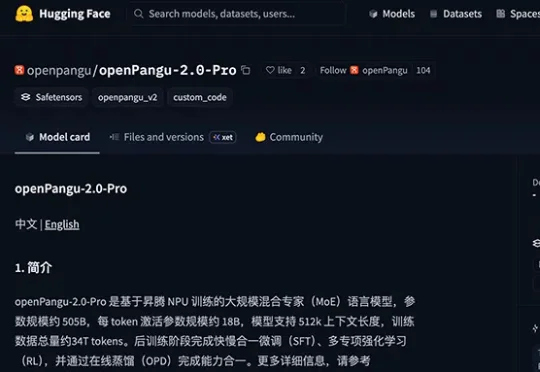
今日,华为开源基于昇腾NPU训练的盘古MoE模型openPangu-2.0-Pro。该模型是openPangu-2.0系列的最新开源模型,总参数规模5050亿,激活参数规模180亿,支持512K上下文长度,训练数据总量约34T tokens。另一轻量化模型openPangu-2.0-Flash已于6月12日开源,参数92亿,其中6亿为激活参数。
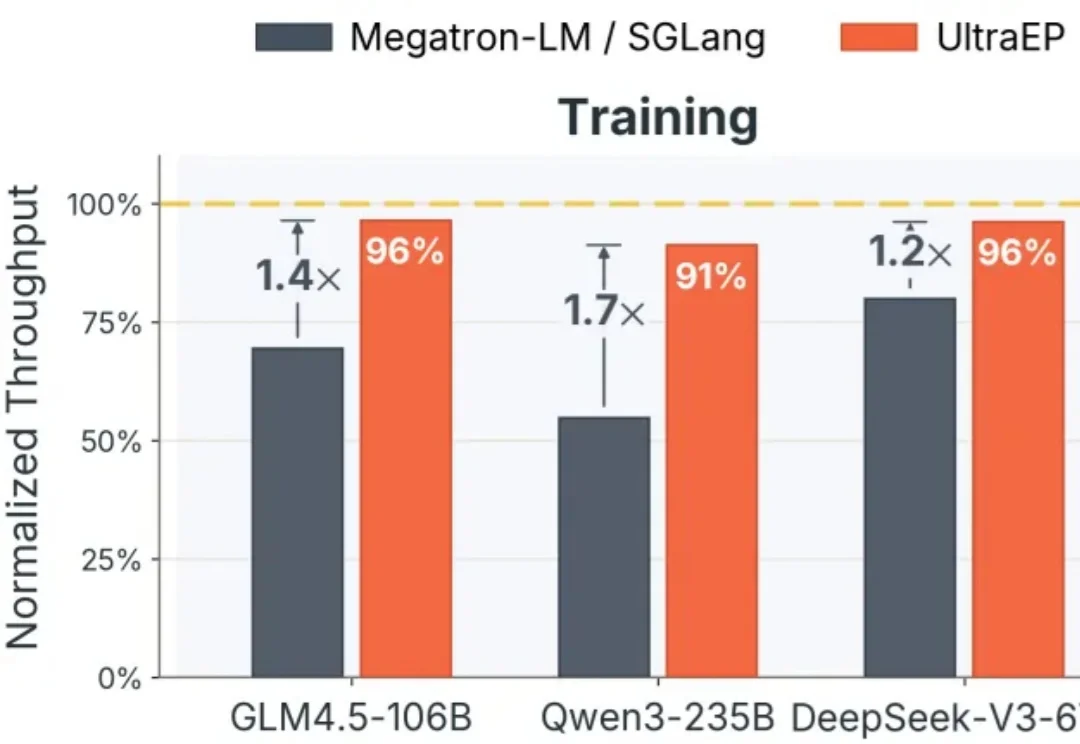
AI 算力的下一个浪费重灾区,可能就在价值数百万美元的整柜系统内部。