AI资讯新闻榜单内容搜索-Max

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: Max
林俊旸离职后,阿里Qwen3.5首次发新

林俊旸离职后,阿里Qwen3.5首次发新

林俊旸离职后,阿里Qwen3.5首次发新

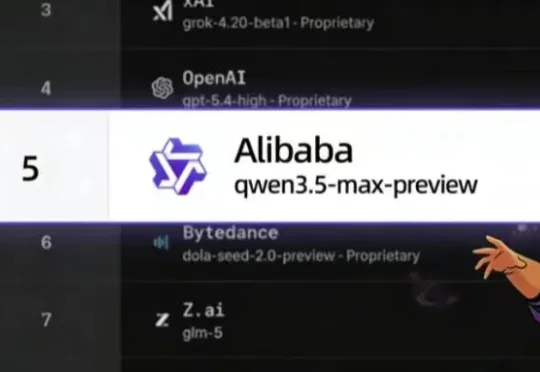
今日,阿里千问最新旗舰模型预览版Qwen3.5-Max-Preview正式亮相,并登上全球大模型评测平台LMArena。在最新榜单中,该模型拿下1464分,进入第一梯队,同时带动阿里千问跻身全球大模型实验室前五、国内第一。

来自主题: AI资讯
10323 点击    2026-03-20 14:40
实测 MiniMax M2.7:AI 狠起来,连自己都卷

实测 MiniMax M2.7:AI 狠起来,连自己都卷

实测 MiniMax M2.7:AI 狠起来,连自己都卷

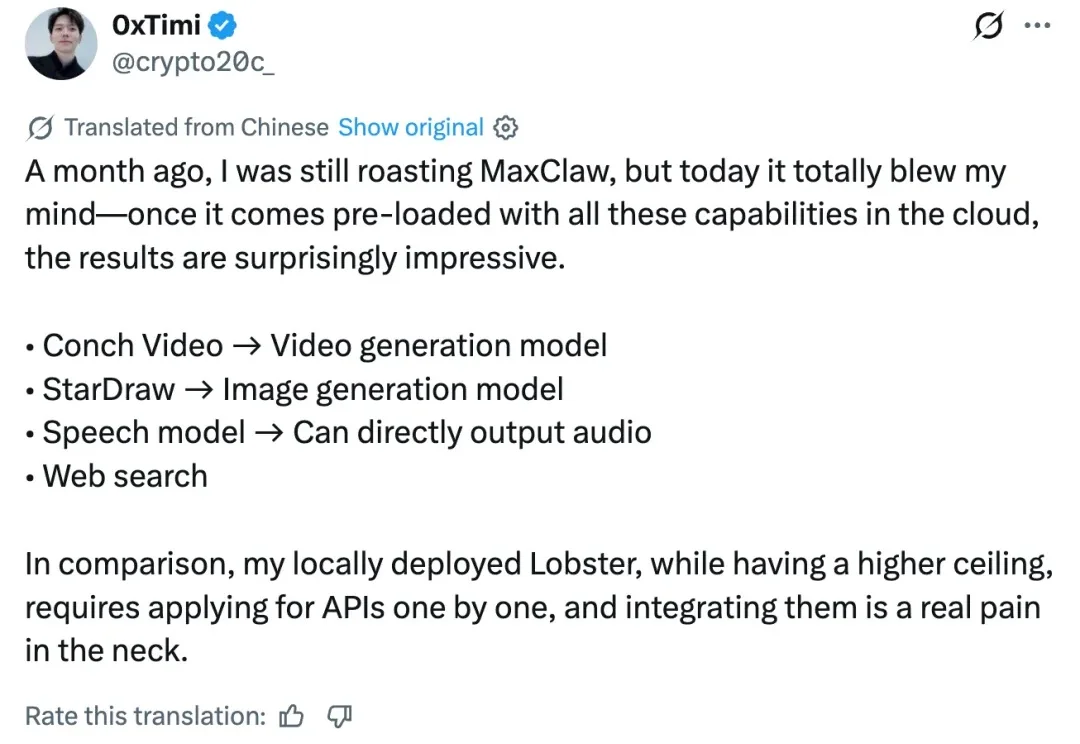
我们也在 Claude Code、本地部署的龙虾里,都接入了 MiniMax M2.7 模型,以及 MiniMax 提供的 MaxClaw,然后把真实的开发过程中遇到的 Bug、枯燥的金融数据,还有大量的长流程任务统统交给它。
来自主题: AI产品测评
11240 点击    2026-03-20 11:16
接入 MiniMax M2.7 后,我的 OpenClaw「超进化」了

接入 MiniMax M2.7 后,我的 OpenClaw「超进化」了

接入 MiniMax M2.7 后,我的 OpenClaw「超进化」了

上周,除了 OpenClaw,AI 圈还有个词越来越火🔥。

来自主题: AI技术研报
11121 点击    2026-03-19 15:20
刚刚,MiniMax直接让龙虾学会自我进化,也认识「马嘉祺」了

刚刚,MiniMax直接让龙虾学会自我进化,也认识「马嘉祺」了

刚刚,MiniMax直接让龙虾学会自我进化,也认识「马嘉祺」了

谁能料到,OpenClaw 的热度从年初延续到了今天。除了专业工程师,很多普通人也在 FOMO(错失恐惧)情绪驱动下,开始了对「养龙虾」的追捧。
来自主题: AI技术研报
8426 点击    2026-03-19 10:49
MiniMax M2.7: 开启模型的自我进化

MiniMax M2.7: 开启模型的自我进化

MiniMax M2.7: 开启模型的自我进化

在 M2 系列模型发布后的几个月,我们收到了大量热心用户的反馈和建议,这促使我们进一步加速模型的迭代效率。除了更加认真工作之外,我们能找到的唯一途径就是开启模型和组织的自我进化。MiniMax M2.7 是我们第一个模型深度参与迭代自己的模型。
来自主题: AI资讯
10495 点击    2026-03-18 15:12
挺搞笑,MiniMax模型就是不认识「马嘉祺」

挺搞笑,MiniMax模型就是不认识「马嘉祺」

挺搞笑,MiniMax模型就是不认识「马嘉祺」

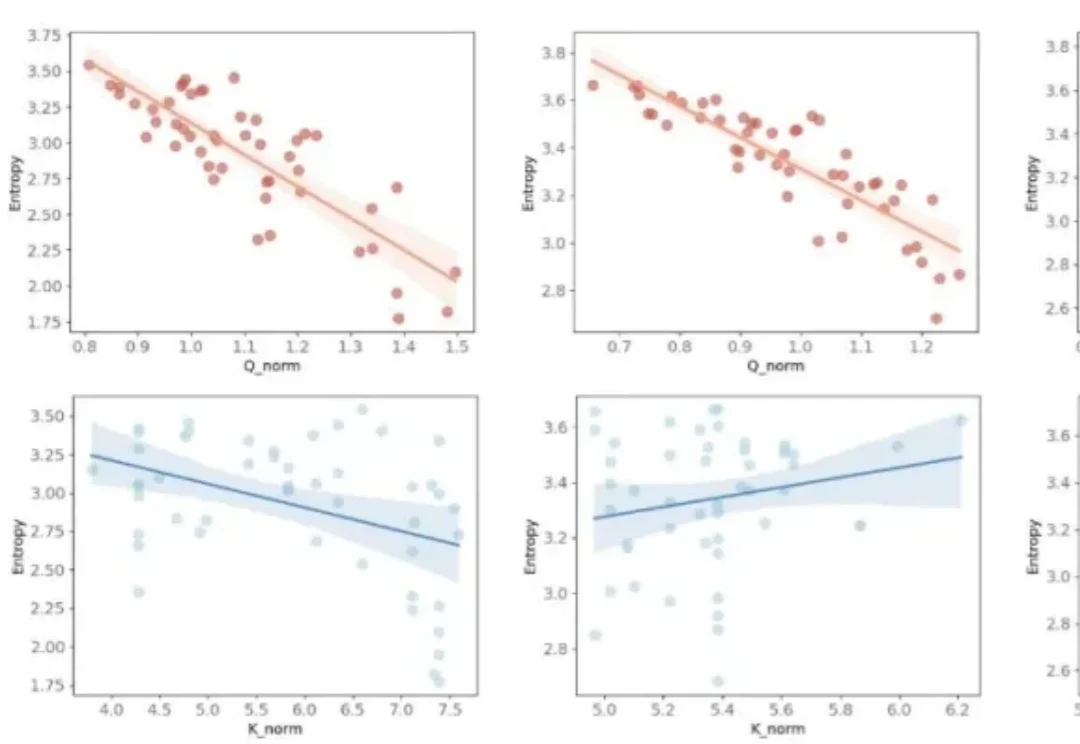
最近,有网友发现了一个很有意思的 bug:MiniMax 的模型似乎不认识「马嘉祺」这三个字。
来自主题: AI技术研报
9190 点击    2026-03-17 14:35
全新线性注意力范式!哈工深张正团队提出模长感知线性注意力!显存直降92.3%!

全新线性注意力范式!哈工深张正团队提出模长感知线性注意力!显存直降92.3%!

全新线性注意力范式!哈工深张正团队提出模长感知线性注意力!显存直降92.3%!

当 Transformer 席卷计算机视觉领域,高分辨率图像、超长序列任务带来的算力与显存瓶颈愈发凸显:标准 Softmax 注意力的二次复杂度,让 70K+token 的超分辨率任务直接显存爆炸,高分辨率图像分割、检测的推理延迟居高不下。
来自主题: AI技术研报
6972 点击    2026-03-17 08:48
MiniMax市值超越百度,一个时代轰然倒塌

MiniMax市值超越百度,一个时代轰然倒塌

MiniMax市值超越百度,一个时代轰然倒塌

百度再一次沦为了计量单位!

来自主题: AI资讯
9626 点击    2026-03-13 09:58
又走一个!OpenAI研究VP离职,转投Anthropic做RL研究员

又走一个!OpenAI研究VP离职,转投Anthropic做RL研究员

又走一个!OpenAI研究VP离职,转投Anthropic做RL研究员

OpenAI的人才地震还在继续!刚刚,前研究副总裁Max Schwarzer宣布离职,这位亲手主导o1、o3和整个GPT-5系列post-training的核心人物,选择加入Anthropic,重返一线RL研究。
来自主题: AI资讯
10392 点击    2026-03-05 14:57
为什么BF16的FlashAttention会把训练「炸掉」?清华首次给出机制解释,用极简改动稳住训练

为什么BF16的FlashAttention会把训练「炸掉」?清华首次给出机制解释,用极简改动稳住训练

为什么BF16的FlashAttention会把训练「炸掉」?清华首次给出机制解释,用极简改动稳住训练

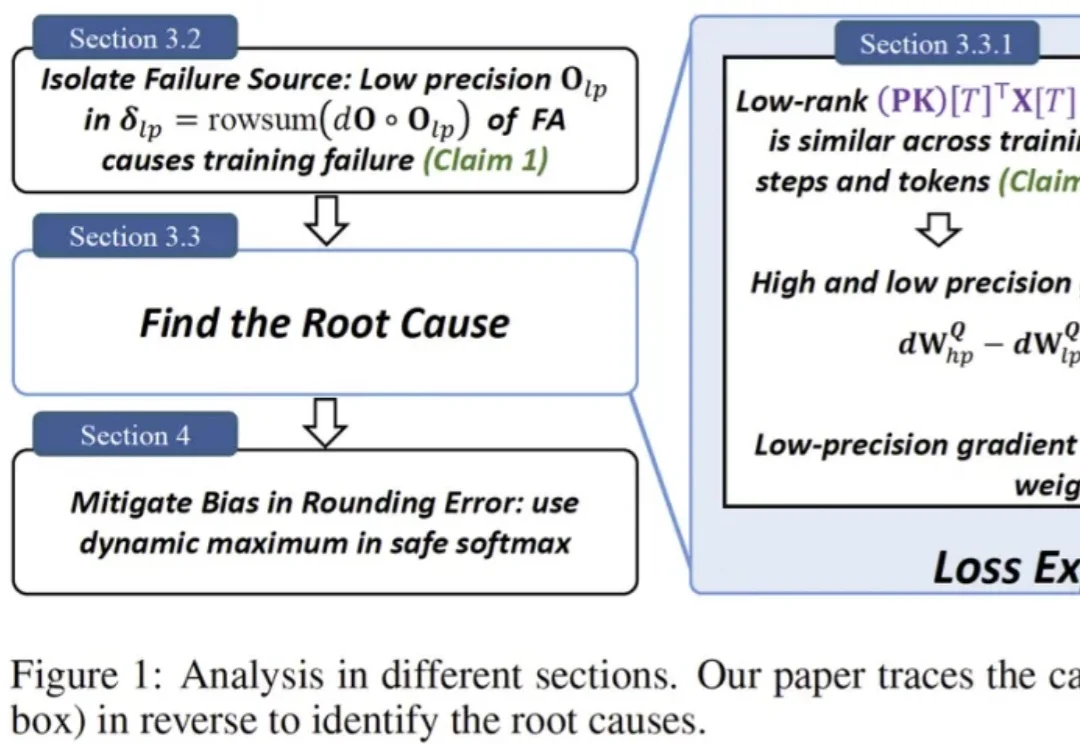
一句话总结:社区里困扰了多年的一个 “玄学” 现象终于被拆解清楚了:在 BF16 等低精度训练里,FlashAttention 不是随机出 bug,而是会在特定条件下触发有方向的数值偏置,借助注意力中涌现的相似低秩更新方向被持续放大,最终把权重谱范数和激活推到失控,导致 loss 突然爆炸。论文还给出一个几乎不改模型、只在 safe softmax 里做的极小修改,实测能显著稳定训练。

来自主题: AI技术研报
7721 点击    2026-03-04 13:49