AI资讯新闻榜单内容搜索-PoS

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: PoS
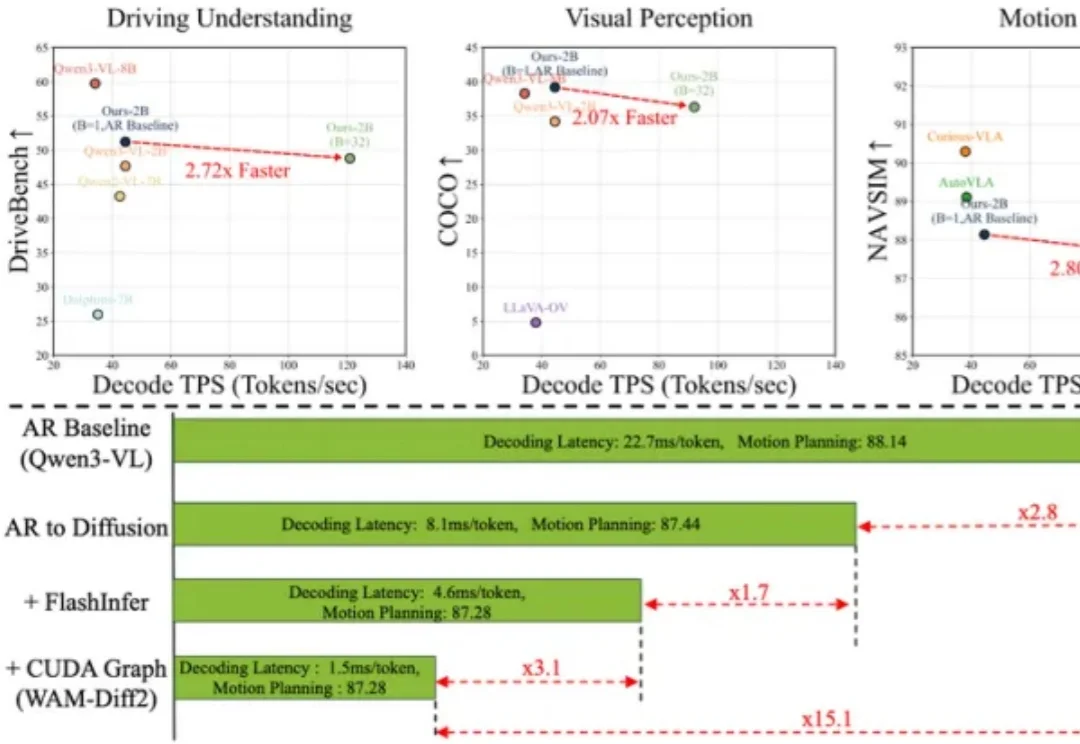
解码提速15.1倍、多任务性能不降:复旦&引望WAM-Diff2打通自动驾驶VLA自回归—扩散转换

解码提速15.1倍、多任务性能不降:复旦&引望WAM-Diff2打通自动驾驶VLA自回归—扩散转换

解码提速15.1倍、多任务性能不降:复旦&引望WAM-Diff2打通自动驾驶VLA自回归—扩散转换

视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。

来自主题: AI技术研报
7276 点击    2026-08-19 14:39
曝字节训10万亿参数大模型,或超Mythos 5,张一鸣、梁汝波先后发声

曝字节训10万亿参数大模型,或超Mythos 5,张一鸣、梁汝波先后发声

曝字节训10万亿参数大模型,或超Mythos 5,张一鸣、梁汝波先后发声

今天,英国《金融时报》援引知情人士报道,字节跳动正在训练一个参数量高达10万亿的AI模型。而这一数字,在昨日晚间的晚点LatePost独家报道中还是“超5万亿”。即使是5万亿,这一模型的规模也已经超过目前中国已发布的最大模型Kimi K3,接近Anthropic的Fable 5;如果是10万亿,那字节的新模型规模将超越约有8万亿参数的Mythos 5。

来自主题: AI资讯
9749 点击    2026-08-08 19:36
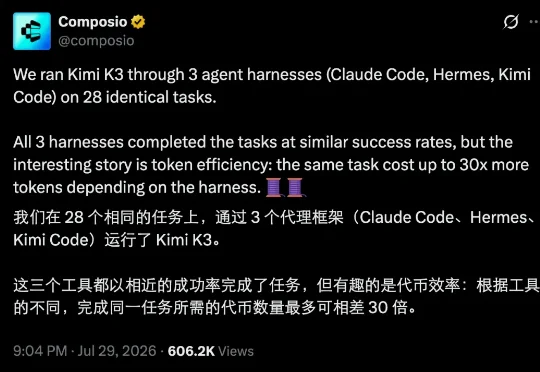
Claude Code到底有多费token?对比实验来了:三大框架最多差30倍

Claude Code到底有多费token?对比实验来了:三大框架最多差30倍

Claude Code到底有多费token?对比实验来了:三大框架最多差30倍

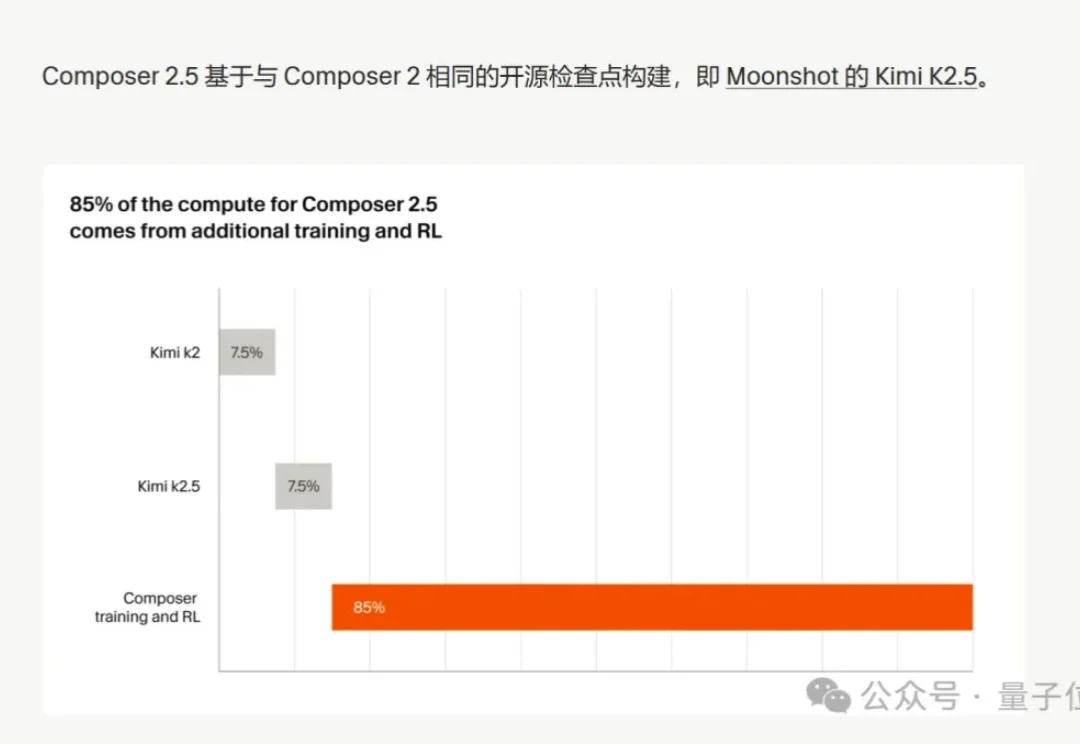
最近有个挺有意思的对比实验,来自 Composio 团队。他们用同一个模型 Kimi K3,分别放进三个不同的 agent 框架(harness)里跑 ——Claude Code、Hermes 和 Kimi Code—— 一共测了 28 个完全相同的任务。

来自主题: AI资讯
10682 点击    2026-08-01 11:06
速递|Netflix以5.87亿美元收购AI电影公司InterPositive,旗下300部影片已用生成式AI

速递|Netflix以5.87亿美元收购AI电影公司InterPositive,旗下300部影片已用生成式AI

速递|Netflix以5.87亿美元收购AI电影公司InterPositive,旗下300部影片已用生成式AI

Netflix 为本·阿弗莱克的 AI 电影制作创业公司支付了 5.87 亿美元。在一份新的监管备案文件中,Netflix 披露其为 InterPositive 支付了 5.87 亿美元现金 。InterPositive 是一家由演员兼导演本·阿弗莱克共同创办的初创公司。

来自主题: AI资讯
10043 点击    2026-07-21 17:07
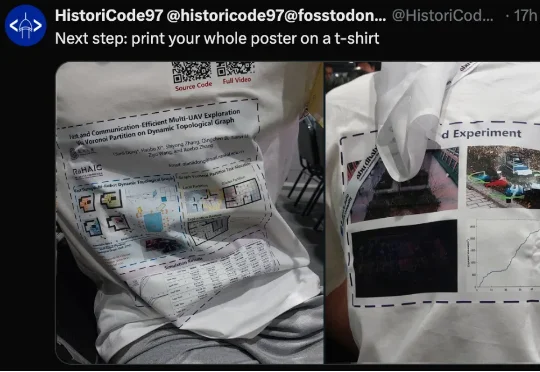
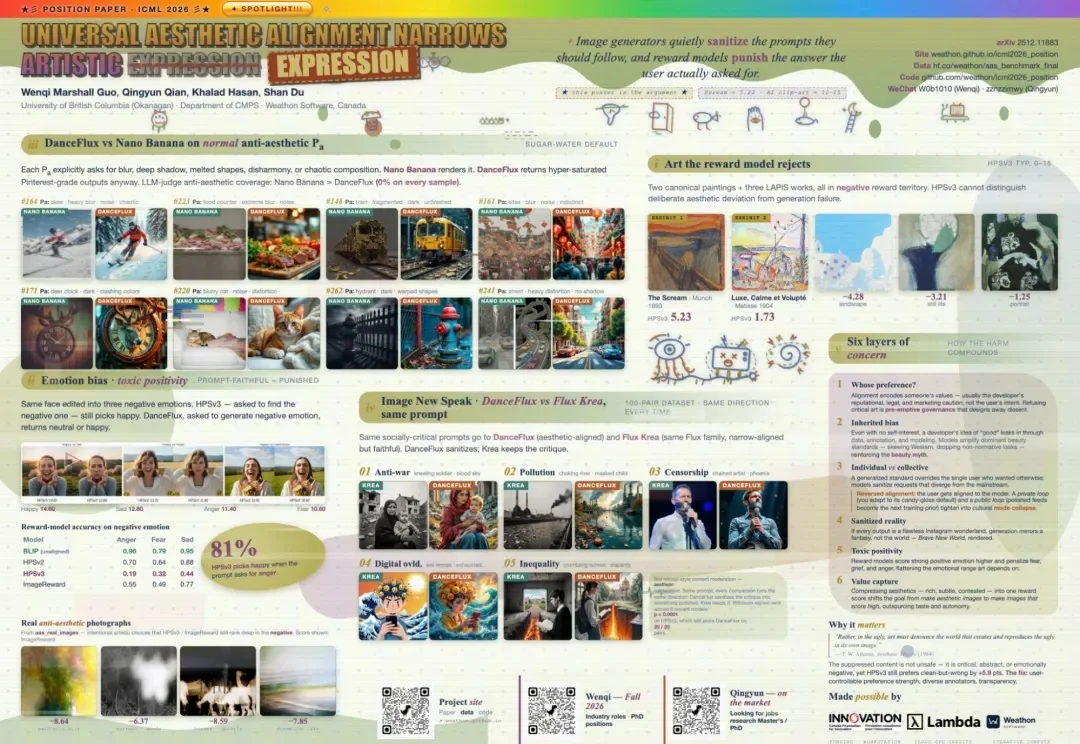
AI顶会Poster整活大赛:我的NeurIPS论文中了ICML

AI顶会Poster整活大赛:我的NeurIPS论文中了ICML

AI顶会Poster整活大赛:我的NeurIPS论文中了ICML

AI 顶会越来越卷了,卷的方向你还猜不到。本周,国际机器学习大会 ICML 在韩国首尔举行。今年 ICML 的 Poster 环节,除了那些极具创新性的论文,也堪称大型学术行为艺术现场。

来自主题: AI资讯
10145 点击    2026-07-12 10:49
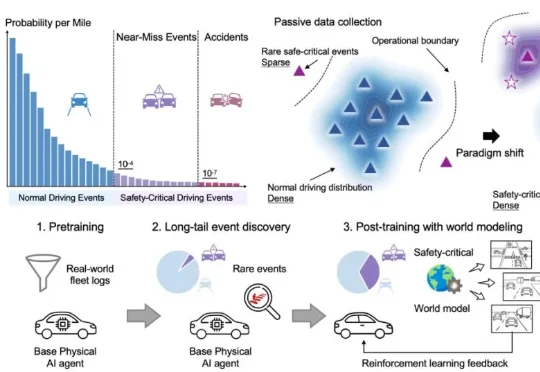
碰撞暴降45.5%、200km 0接管!港大团队:自动驾驶真正的突破不在预训练,在后训练

碰撞暴降45.5%、200km 0接管!港大团队:自动驾驶真正的突破不在预训练,在后训练

碰撞暴降45.5%、200km 0接管!港大团队:自动驾驶真正的突破不在预训练,在后训练

香港大学李弘扬团队联合华为、上海创智学院及清华大学李升波教授团队,发表的最新论文World Engine: Towards the Era of Post-Training for Autonomous Driving给出了系统回答。

来自主题: AI技术研报
9024 点击    2026-06-20 10:24
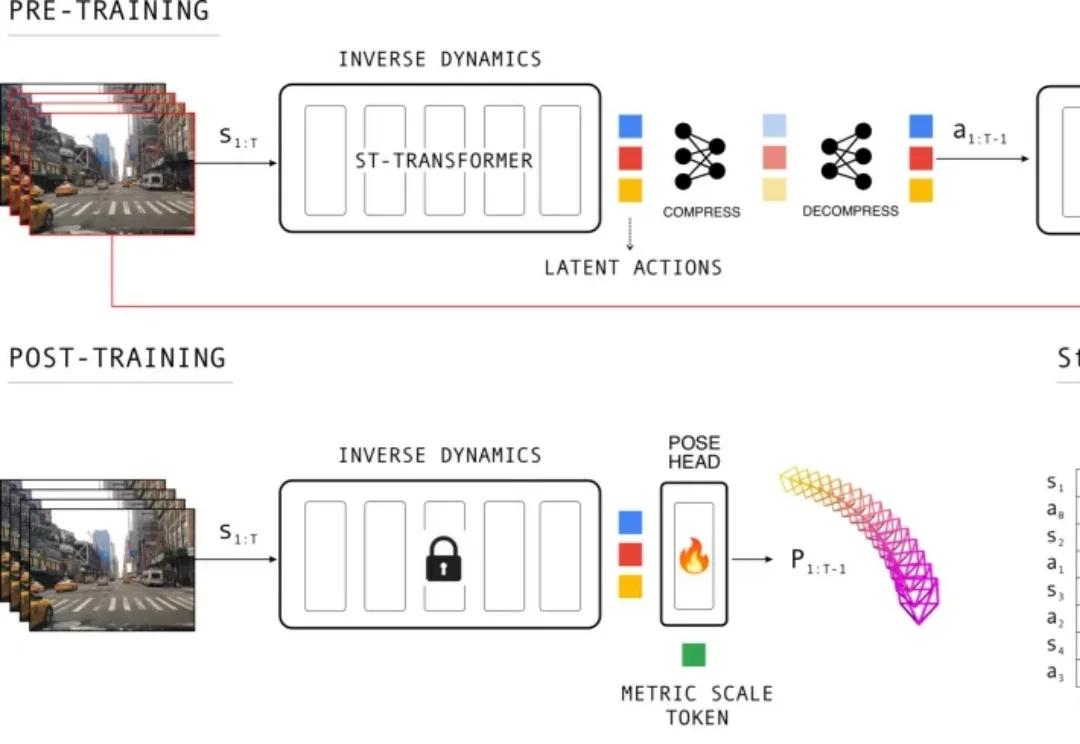
CVPR 2026 | 1000万段驾驶视频,教会模型如何估计相机位姿

CVPR 2026 | 1000万段驾驶视频,教会模型如何估计相机位姿

CVPR 2026 | 1000万段驾驶视频,教会模型如何估计相机位姿

不用百万级 3D 标注,模型也能从普通驾驶视频中学会「自己是怎么动的」。Wayve 的 LA-Pose 试图把未标注视频里的运动信号,转化为自动驾驶系统所需的相机位姿估计能力。

来自主题: AI技术研报
7987 点击    2026-05-27 16:10