名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」
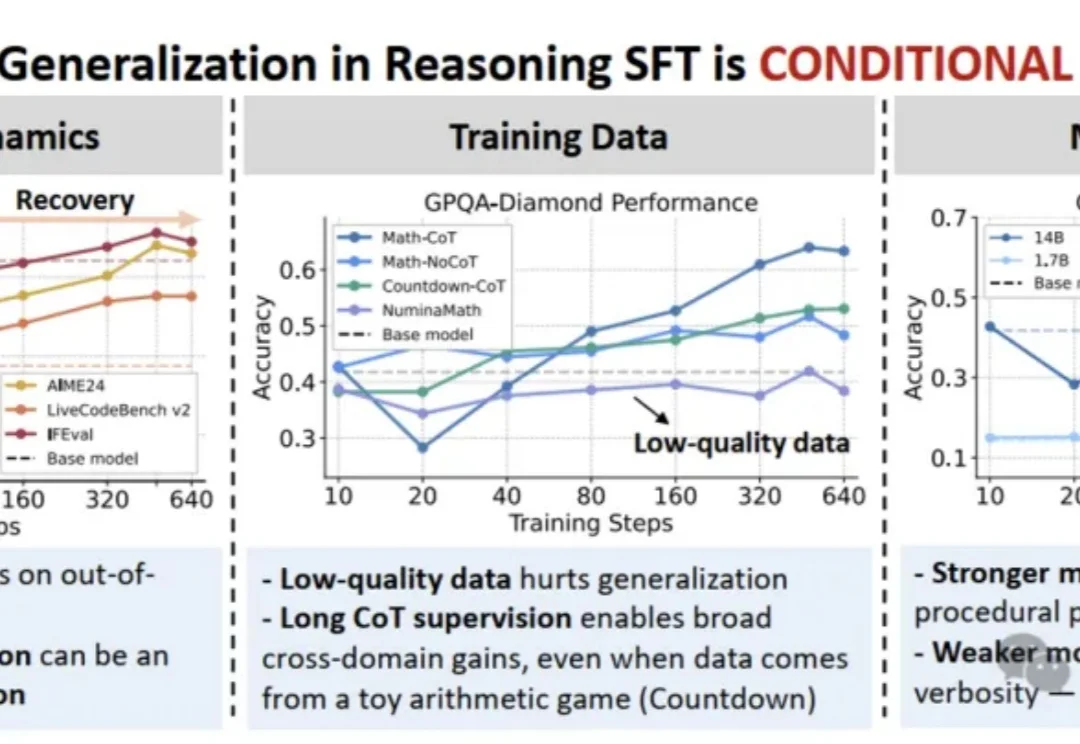
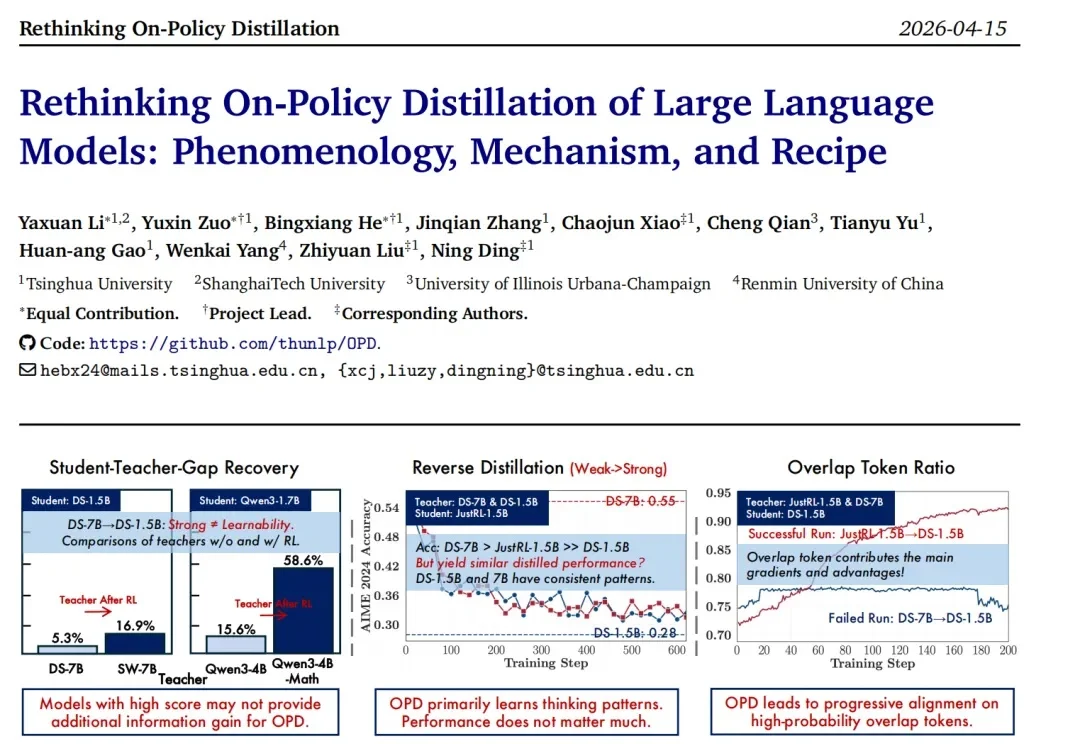
名师一定出高徒?清华团队最新揭秘:别再迷信大模型蒸馏的「免费午餐」当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
搜索
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
随着大模型后训练(Post-training)技术的发展,强化学习(RL)在提升模型推理能力方面的表现备受瞩目。
当OpenAI 还在抢模型话语权时,马斯克已经一手把 xAI 变成「算力包租公」,一手 Tesla AI5、AI6 与 Dojo 芯片——这个男人的AI帝国,永远比你想象的更疯狂。
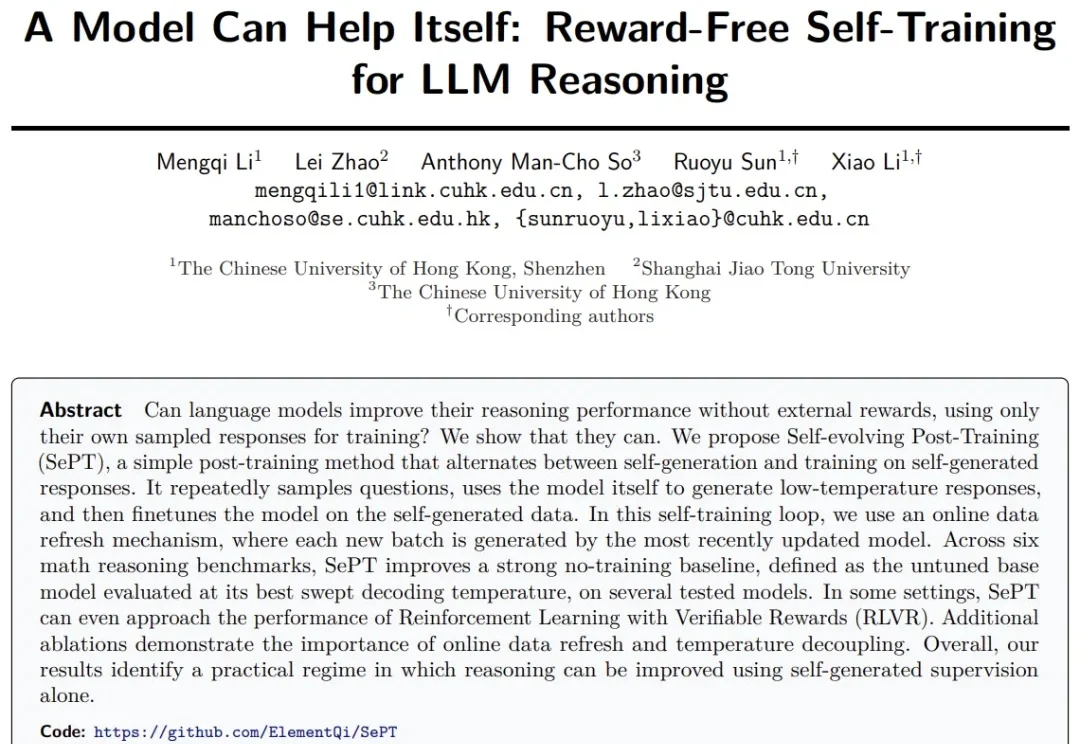
在推理后训练里,多数方法仍依赖奖励模型、验证器或额外教师信号。如果不依赖这些外部信号,只使用模型自身生成的答案进行自训练,是否仍然能够提升推理能力?是的!SePT(Self-evolving Post-Training)给出肯定答案,简洁的自训练方法,可在数学推理任务准确率直升10个点!
一年前,DeepSeek R1 横空出世,人们才意识到,真正让模型产生推理能力质变的,不必是更大的预训练规模 —— 后训练,用强化学习、过程奖励、闭环反馈,以极低的代价解锁了原本需要数倍算力才能触达的能力边界。
今天凌晨,Physical Intelligence发布了全新的VLA模型π0.7,狠狠敲了世界模型一记闷棍。π0.7第一次在机器人领域证明了Compositional Generalization(组合泛化),且VLA。
Braintrust 是一家做 AI 产品可观测性和评估的公司。你可以理解为:帮你监控和调试 AI 智能体的工具。他们发现,现有的数据库——无论是 Postgres、数据仓库还是浏览器端的 DuckDB——全都扛不住 AI 工作负载。于是他们做了一个很大胆的决定:自己造一个数据库。
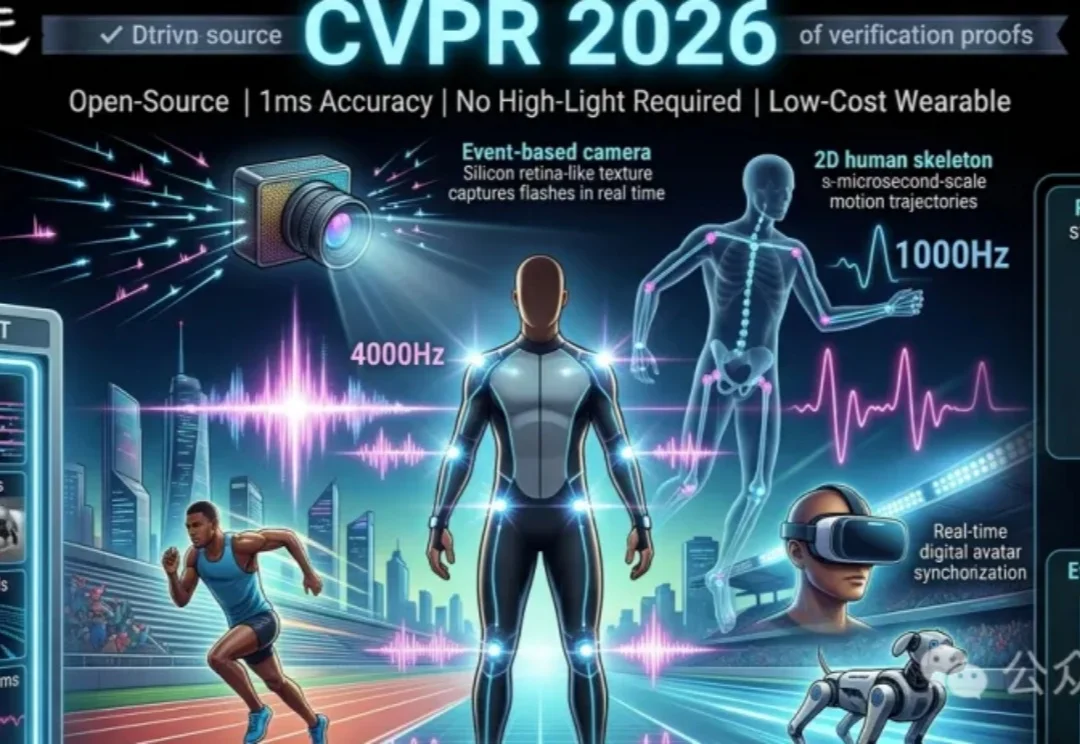
全球首个1毫秒级人体动作捕捉系统FlashCap,通过闪烁LED与事件相机结合,实现1000Hz超高帧率捕捉。无需昂贵设备或强光环境,低成本穿戴服即可精准捕捉极速动作。团队同步开源715万帧的FlashMotion数据集与多模态模型ResPose,显著提升运动分析精度,推动体育、VR与机器人领域迈向高动态智能新阶段。
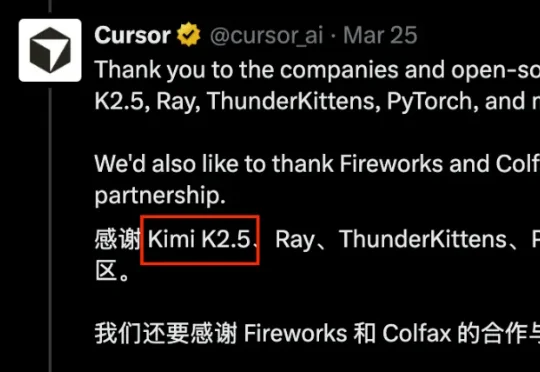
Cursor套壳Kimi这事还没完…… 最新消息,Cursor放出Composer 2技术报告,力证自己还是有在“自研”。(doge) 不是纯套,而是有技术地套、循序渐进地套。用的方法,还是他们一开始就强调的预训练+强化学习。
3 月 20 日,知名 AI 代码编辑器 Cursor 高调发布了所谓的编程模型 Composer 2,结果被网友质疑「套壳」 Kimi K2.5。而从官方口径来看, Composer 2 的性能简直是降维打击:全基准大幅领先前代,首次引入持续预训练,叠加大规模强化学习,能解决需要数百个操作的高难度编程任务。