写入记忆,何必读完整个网络?英伟达SEED每GPU吞吐最高提升42%
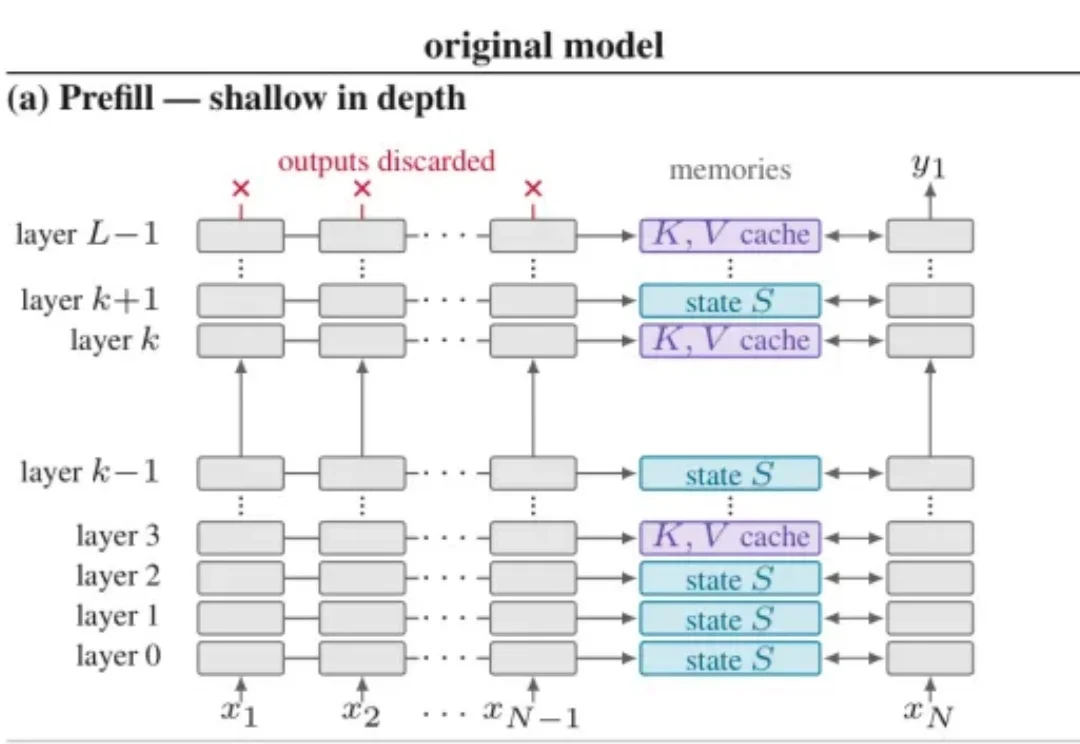
写入记忆,何必读完整个网络?英伟达SEED每GPU吞吐最高提升42%Qwen3.8-Flash-Next 有 48 层。处理一段输入时,SEED 让除最后一个以外的 token 只运行前 31 层,再由轻量的记忆写入组件,为后续 17 层生成 KV Cache 和循环状态。到了生成阶段,每个 token 仍然运行完整的 48 层。
来自主题: AI技术研报
6010 点击 2026-11-19 14:50

 搜索
Qwen3.8-Flash-Next 有 48 层。处理一段输入时,SEED 让除最后一个以外的 token 只运行前 31 层,再由轻量的记忆写入组件,为后续 17 层生成 KV Cache 和循环状态。到了生成阶段,每个 token 仍然运行完整的 48 层。
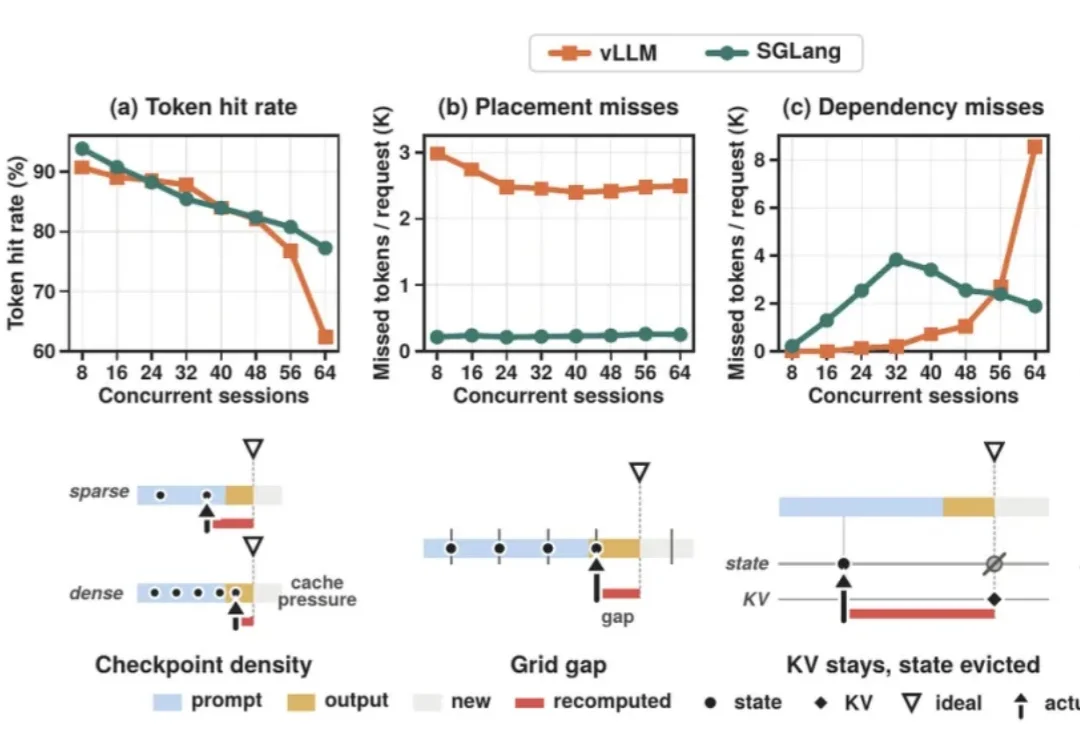
Kimi Delta Attention(KDA)、Gated DeltaNet(GDN)、Mamba-2 等线性注意力与状态空间层,正在成为开源大模型的常见组件。Kimi K3.1 Pro、GLM-5.3-Flash、Qwen3.8-Flash-Next、Nemotron 3 Super 都采用了「全注意力 + 线性层」的混合架构,以换取更快的解码和更小的 KV Cache。
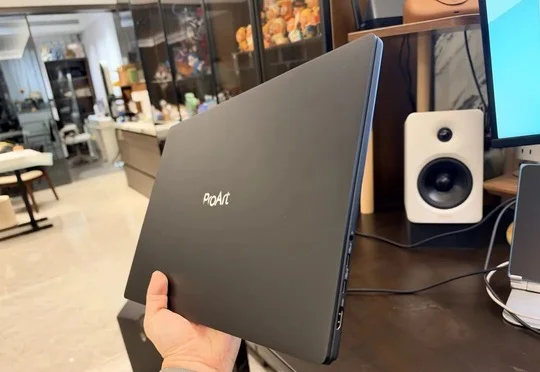
英伟达RTX Spark全球开售,128GB版本开售数分钟即售罄;作者使用售价37999元的华硕ProArt创16本地运行Qwen3.8-27B等模型,实现免API费用的多种AI任务并获得“Token自由”体验。
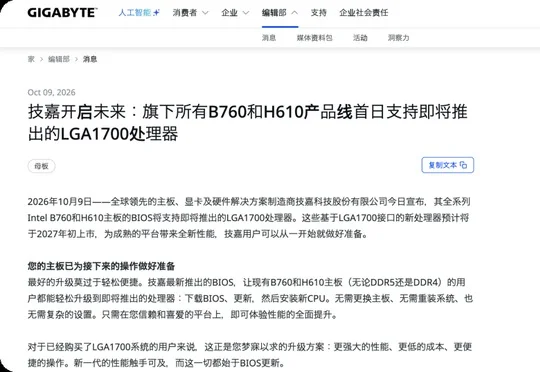
AI需求挤压消费级内存产能并推高PC成本,技嘉通过BIOS更新让B760、H610及DDR4平台继续支持英特尔LGA1700新处理器,开源项目Strata则让消费级电脑本地运行1250亿参数的Qwen3.8-Flash-Next成为可能。
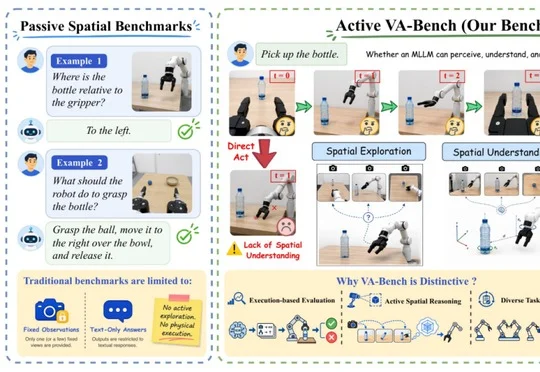
VA-Bench测试12个主要多模态模型发现,Qwen3.8-max、Opus-5和GPT-5.6-sol虽在目标识别与定位上达100%、操作语义理解达99.6%—100%,完整任务成功率却仅为53.93%、52.86%和51.55%,暴露大模型从空间理解到执行与修正的断层。
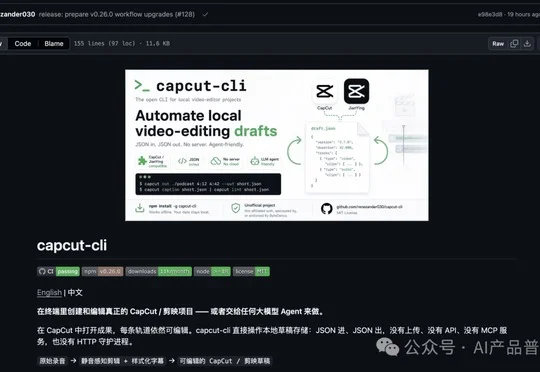
作者用 Qoder 搭配 Qwen3.8-Flash 模型调用开源工具 capcut-cli,在剪映 5.9 中自动完成口播视频的字幕识别、贴字和音效添加,生成可继续手动修改的分轨草稿。
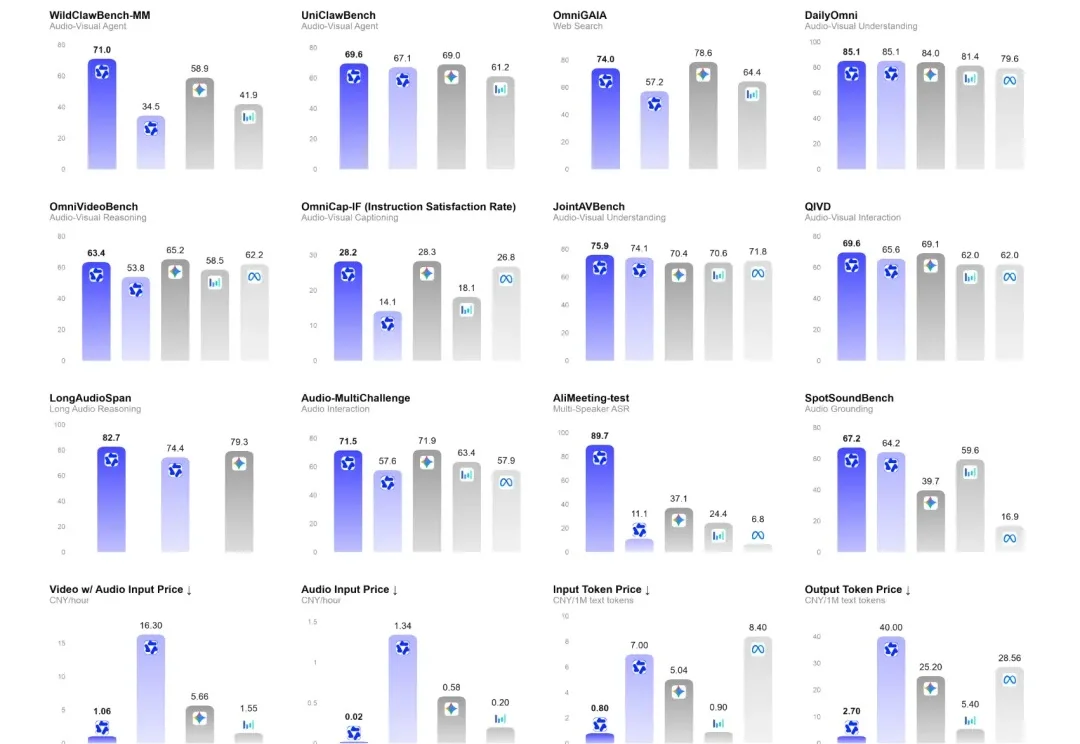
千问把全模态Agent的使用成本,直接砍掉了90%!
原生全模态模型Qwen3.8-Omni-Flash正式上线千问AI平台,支持文本、图像、音频、视频输入及1M长上下文,在30项评测中平均得分较上一代Qwen3.5-Omni-Plus提升超26%,在音视频Agent、剪辑、创作等场景效果显著,API每小时音频输入价格降幅超98%。
杭州自9月20日起向35家市级大学生创业园每人发放一张含1万积分的千问办公token卡,这是千问办公接入Qwen3.8-Max一个月后杭州首次将算力帮扶平铺到个人,标志着其AI产业思路从支持做模型的企业转变为支持用模型的人。
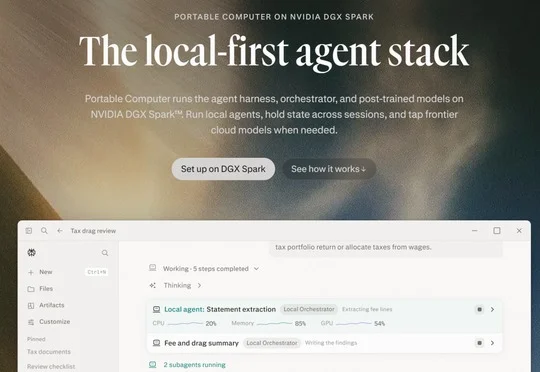
Perplexity推出本地优先智能体Portable Computer,通过专为端侧模型设计的Harness配合Qwen3.8-27B实现近零成本的本地推理,并在多项基准测试中超越Hermes和Pi等开源通用框架。