AI巨头陷版权风暴,免费的“数据盛宴”即将散场?
AI巨头陷版权风暴,免费的“数据盛宴”即将散场?近日,备受关注的德里亚·巴茨(Andrea Bartz)等诉Anthropic公司的集体诉讼案以一项高达15亿美元的和解协议暂告段落。该案自立案之初便牵动科技界与版权界神经,其最终处理结果及创纪录的和解金额,在AI行业内引发强烈震动。
来自主题: AI资讯
11879 点击 2025-09-08 16:10

 搜索
近日,备受关注的德里亚·巴茨(Andrea Bartz)等诉Anthropic公司的集体诉讼案以一项高达15亿美元的和解协议暂告段落。该案自立案之初便牵动科技界与版权界神经,其最终处理结果及创纪录的和解金额,在AI行业内引发强烈震动。
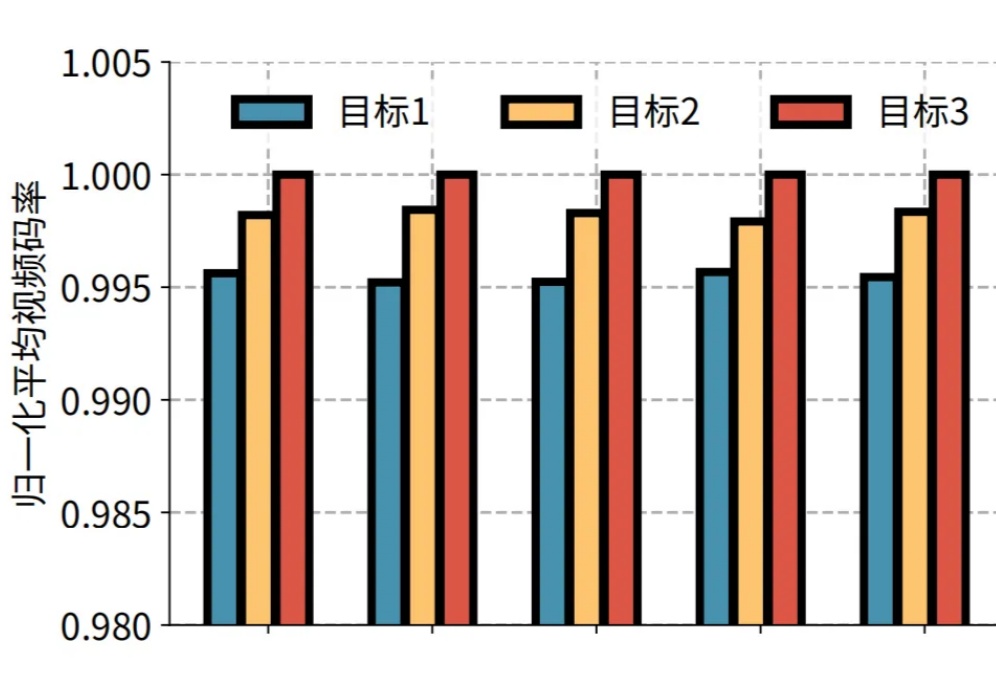
近日,快手与清华大学孙立峰团队联合发表论文《Towards User-level QoE: Large-scale Practice in Personalized Optimization of Adaptive Video Streaming》,被计算机网络领域的国际顶尖学术会议 ACM SIGCOMM 2025 录用。
您对“思维链”(Chain-of-Thought)肯定不陌生,从最早的GPT-o1到后来震惊世界的Deepseek-R1,它通过让模型输出详细的思考步骤,确实解决了许多复杂的推理问题。但您肯定也为它那冗长的输出、高昂的API费用和感人的延迟头疼过,这些在产品落地时都是实实在在的阻碍。
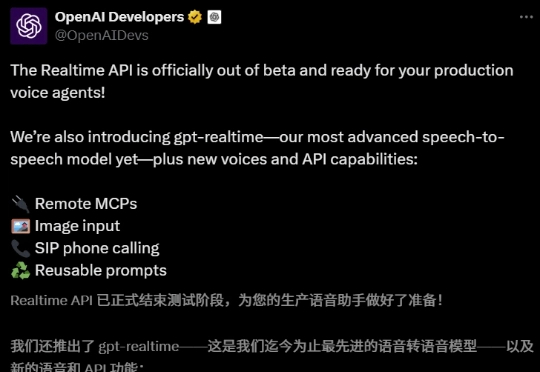
OpenAI凌晨发布最新生产级别语音模型和API。Realtime API实现语音直接处理,支持图像输入、远程MCP服务器与SIP打电话,极大简化语音智能体构建;而新一代语音到语音模型gpt-realtime,在音质、理解力、指令遵循和函数调用上全面提升,语音几乎媲美真人,还能多语种切换与细腻表达。
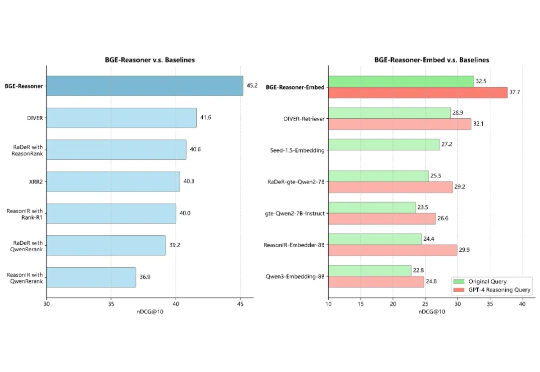
人工智能的浪潮正将我们推向一个由 RAG 和 AI Agent 定义的新时代。然而,要让这些智能体真正「智能」,而非仅仅是信息的搬运工,就必须攻克一个横亘在所有顶尖团队面前的核心难题。这个难题,就是推理密集型信息检索(Reasoning-Intensive IR)。
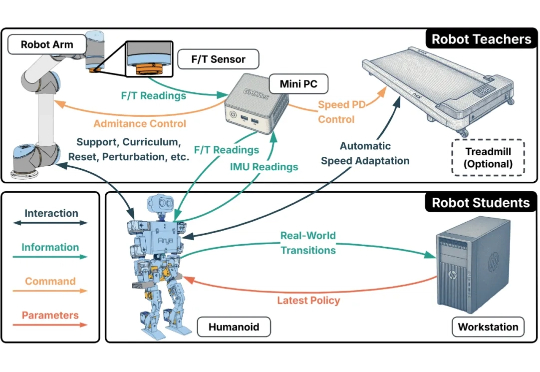
人形机器人的运动控制,正成为强化学习(RL)算法应用的下一个热点研究领域。当前,主流方案大多遵循 “仿真到现实”(Sim-to-Real)的范式。研究者们通过域随机化(Domain Randomization)技术,在成千上万个具有不同物理参数的仿真环境中训练通用控制模型,期望它能凭借强大的泛化能力,直接适应动力学特性未知的真实世界。
Meta 首席 AI 负责人 Alexandr Wang 周五在 Threads 上发帖宣布,Meta 将与 Midjourney 合作 ,获得这家初创公司 AI 图像和视频生成技术的使用许可。Wang 表示 Meta 的研究团队将与 Midjourney 协作,将该技术整合到未来的 AI 模型和产品中。
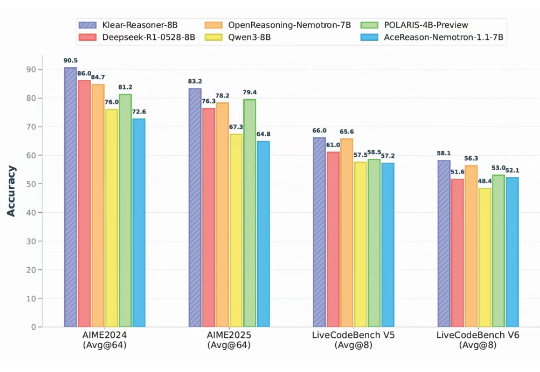
在大语言模型的竞争中,数学与代码推理能力已经成为最硬核的“分水岭”。从 OpenAI 最早将 RLHF 引入大模型训练,到 DeepSeek 提出 GRPO 算法,我们见证了强化学习在推理模型领域的巨大潜力。
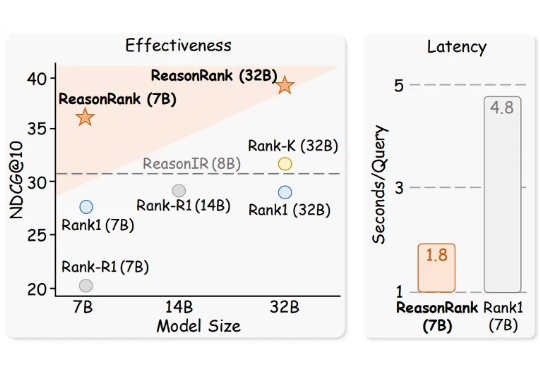
推理大模型(Large Reasoning Model)极大的促进了自然语言处理领域的发展,而信息检索领域的核心问题之一是文档排序,如何利用强大的推理大模型通过主动推理来判断文档的相关性,进而再对文档进行排序是一个值得探索的方向。
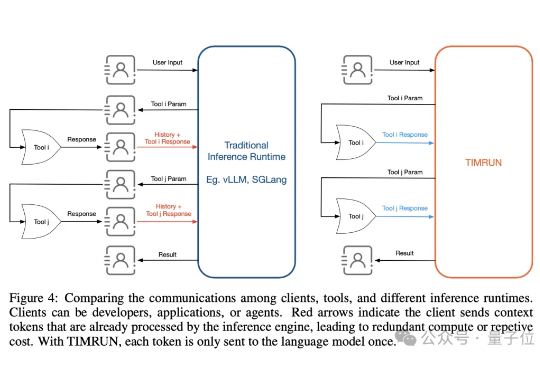
大模型的记忆墙,被MIT撬开了一道口子。 MIT等机构最新提出了一种新架构,让推理大模型的思考长度突破物理限制,理论上可以无限延伸。 这个新架构名叫Thread Inference Model,简称TIM。