

OPD训练也能无损加速?STOPD最高加速2.2倍!
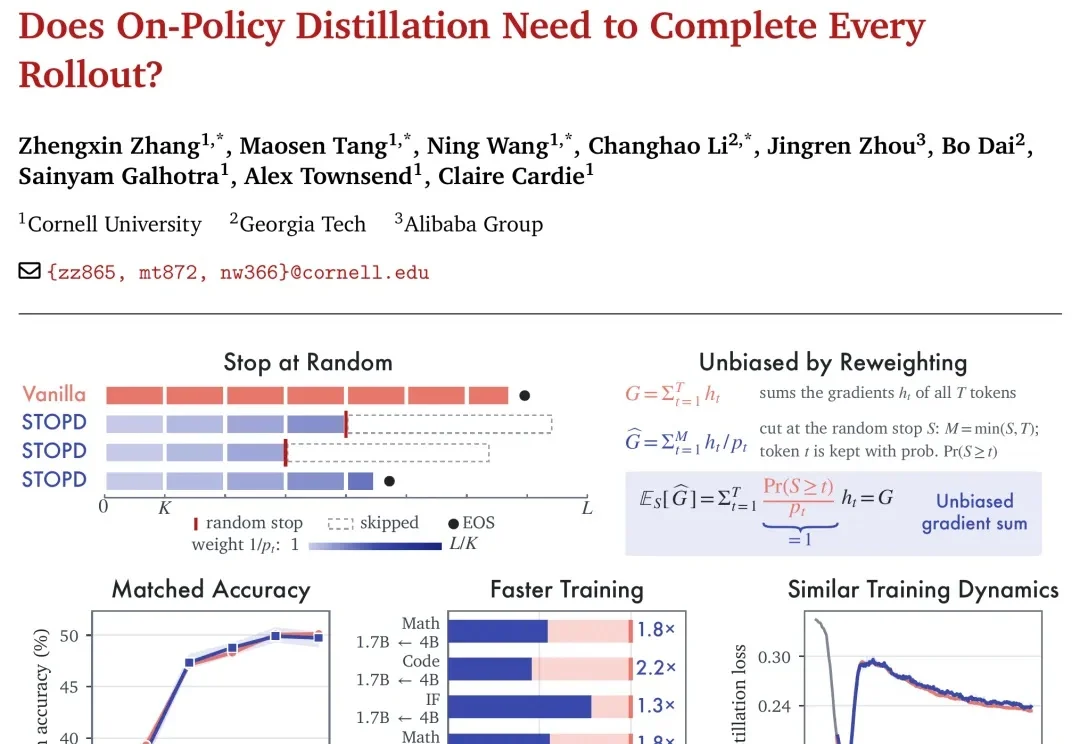
OPD训练也能无损加速?STOPD最高加速2.2倍!On-policy distillation(OPD)的做法很简单:先让学生自己生成回答,再由教师逐 token 提供反馈,指导学生更新。这样教师就能直接针对学生实际生成的内容进行指导,而不必依赖预先准备好的答案。问题在于,每一轮训练都需要学生生成完整的回答,之后教师还要对每个位置进行评估。随着回答变长,训练成本也会越来越大。
来自主题: AI技术研报
8849 点击 2026-11-19 15:10