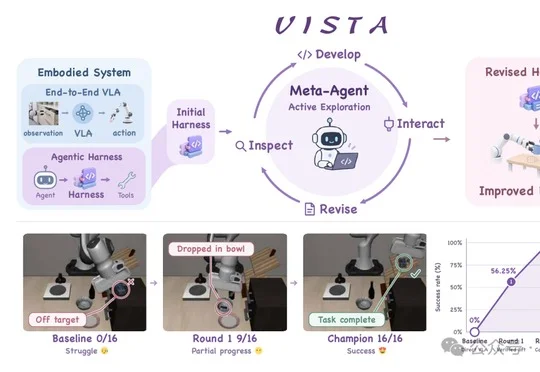
机器人自己写代码修自己,成功率从17.5%涨到95%:具身智能有了不动权重的自进化框架
机器人自己写代码修自己,成功率从17.5%涨到95%:具身智能有了不动权重的自进化框架清华大学和新加坡国立大学团队提出并开源VISTA,通过Meta-agent自主修改Harness代码且不更新模型权重,将LIBERO-Pro整体任务成功率从17.5%提升至95.0%。
来自主题: AI技术研报
8605 点击 2026-11-07 14:48

 搜索
清华大学和新加坡国立大学团队提出并开源VISTA,通过Meta-agent自主修改Harness代码且不更新模型权重,将LIBERO-Pro整体任务成功率从17.5%提升至95.0%。
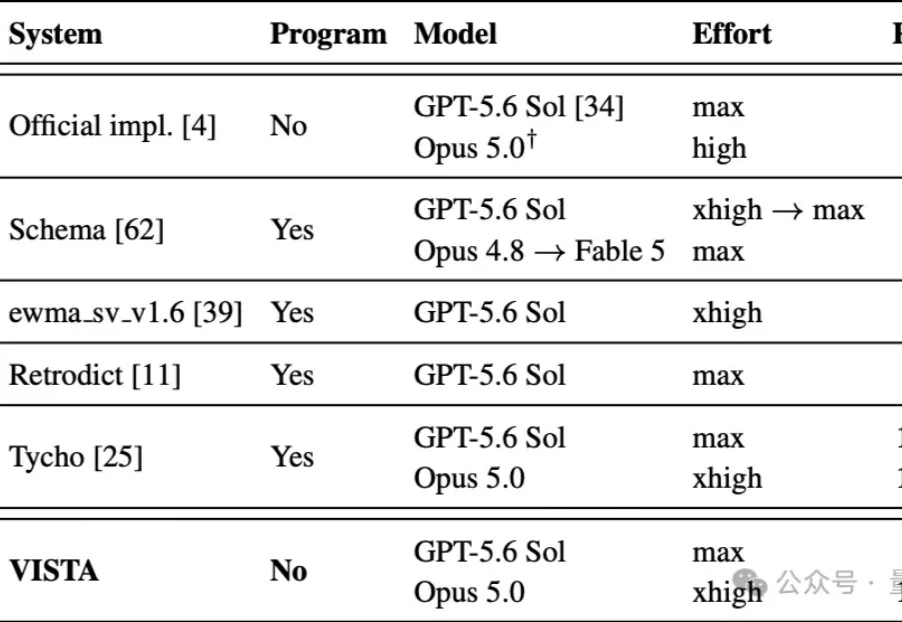
多模态模型的视觉原生Harness,来了!
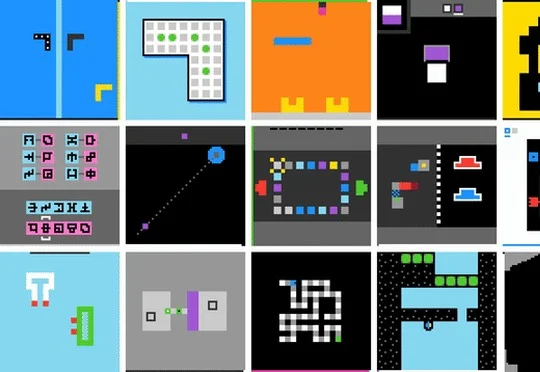
何恺明团队提出VISTA方法,将ARC-AGI-3的数字表换回图像并配备可随时翻看的视觉记忆相册,使Claude Opus 5拿下满分100分、GPT-5.6 Sol获得99分,证明卡住大模型的是眼睛和记性而非模型能力本身。
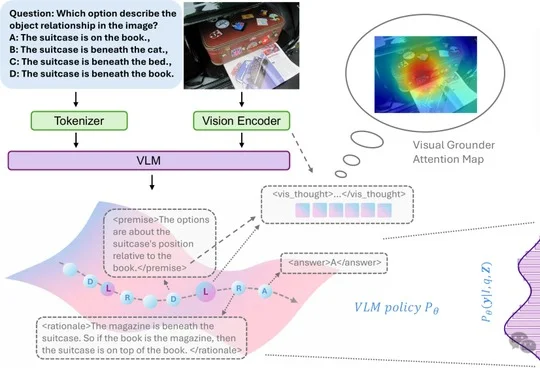
埃默里大学提出的Decompose–Look–Reason(DLR)框架被EMNLP 2026接收,该方法通过分解问题、按premise提取视觉latent再推理,在Qwen3-VL-8B-Thinking上于V*、MathVista等基准取得显著提升。
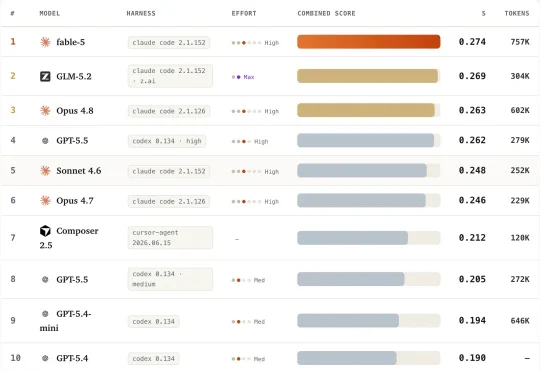
为了解决这一问题,来自 University of Arizona、Zoom 与 Stony Brook University 的研究团队推出了 VISTA(VIsual Spec-To-App Benchmark), 首个面向 Visual Spec-to-Web-App Coding Agents 的端到端 Benchmark。
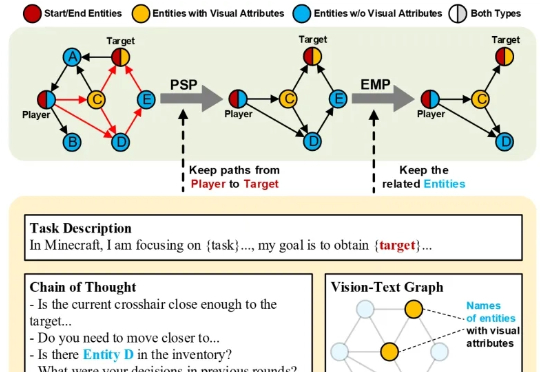
在大多数人眼中,《我的世界》(Minecraft)只是一款自由度极高的沙盒游戏。 而在香港科技大学(广州)与腾讯联合团队的眼中,它却是一座可以演练通用人工智能的“数字练兵场”。
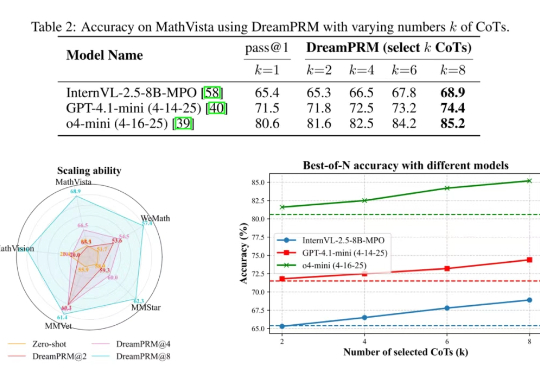
使用过程奖励模型(PRM)强化大语言模型的推理能力已在纯文本任务中取得显著成果,但将过程奖励模型扩展至多模态大语言模型(MLLMs)时,面临两大难题:

Vista-LLaMA 在处理长视频内容方面的显著优势,为视频分析领域带来了新的解决框架。

大型多模态模型会做数学题吗?在UCLA等机构最新发布的MathVista基准上,即使是当前最强的GPT-4V也会感到「挫败感」。