RAGFlow 1.0 正式发布:超越 RAG,迈向 Agent Native Database
RAGFlow 1.0 正式发布:超越 RAG,迈向 Agent Native Database过去两年,几乎每家企业都在用 RAG 解决大模型落地的问题。把文档切块,做 Embedding,算相似度,塞进 Prompt。简单、直接、听起来无懈可击。但真正把它搬进生产环境的人都知道:RAG 远不够好。
来自主题: AI资讯
7406 点击 2026-11-09 16:28

 搜索
过去两年,几乎每家企业都在用 RAG 解决大模型落地的问题。把文档切块,做 Embedding,算相似度,塞进 Prompt。简单、直接、听起来无懈可击。但真正把它搬进生产环境的人都知道:RAG 远不够好。
广州智跃深空(Zleap)开源了自研的SAG2及桌面端SAG Wiki,利用BM25与JEV直接索引和检索本地文件,无需大模型预处理、Embedding或向量数据库,以极快建库、精准多跳检索和低Token消耗提供轻量本地知识库方案。
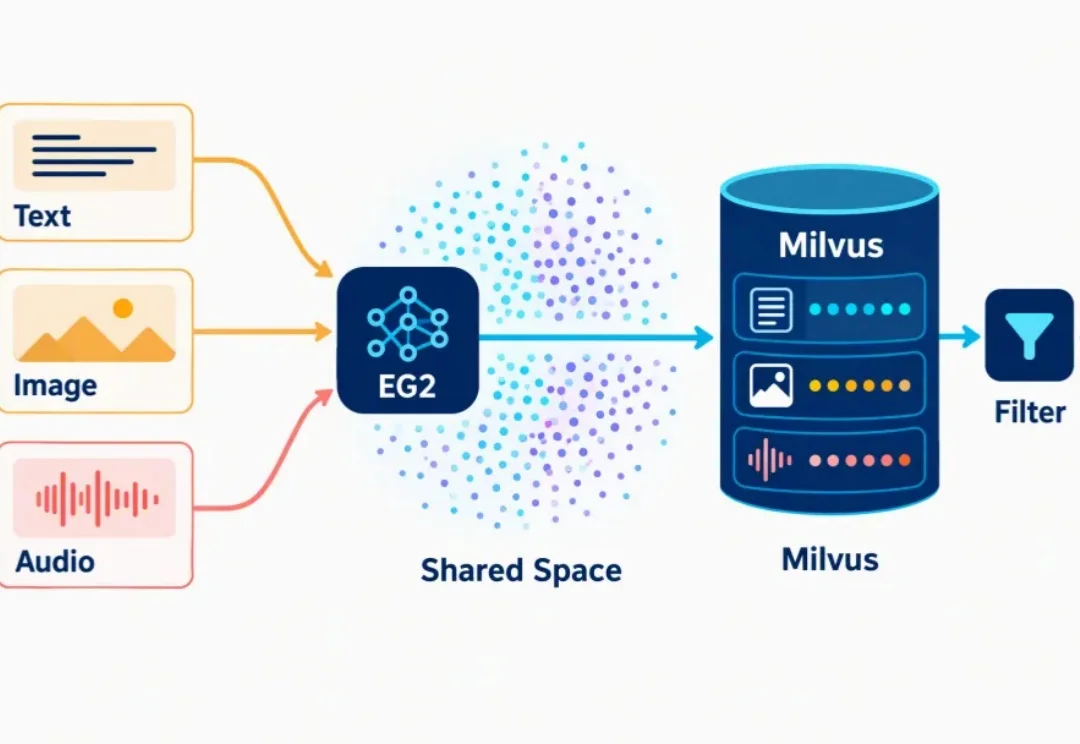
传统多模态检索,往往要维护多套embedding模型。文本用一套 embedding,图片用一套视觉模型,音频再单独接一条链路。
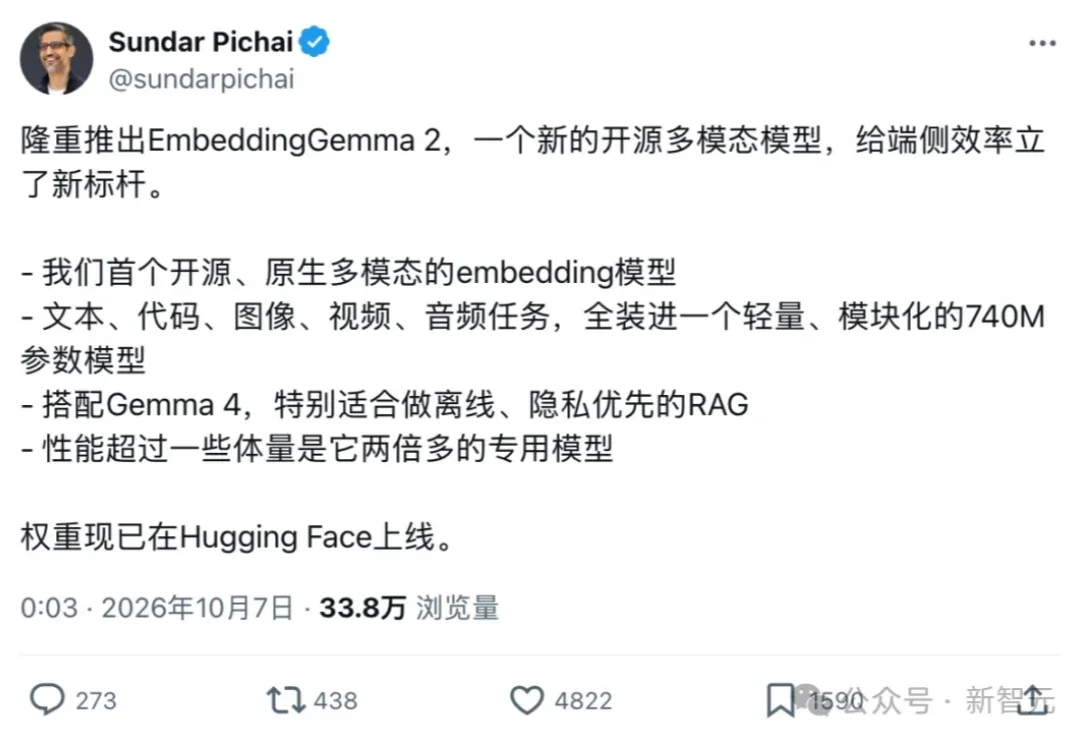
10月6日,谷歌开源EmbeddingGemma 2,把一个能搜图、看视频、听声音的搜索引擎,塞进了一个内存不到600MB的小模型!
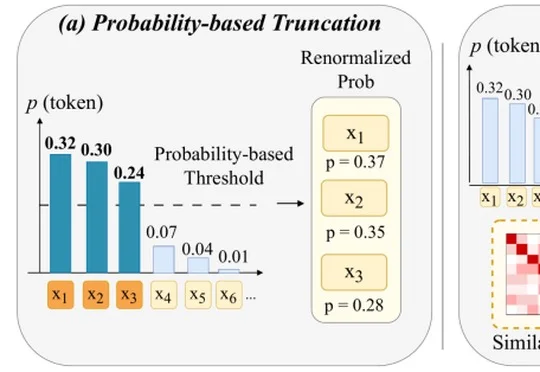
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
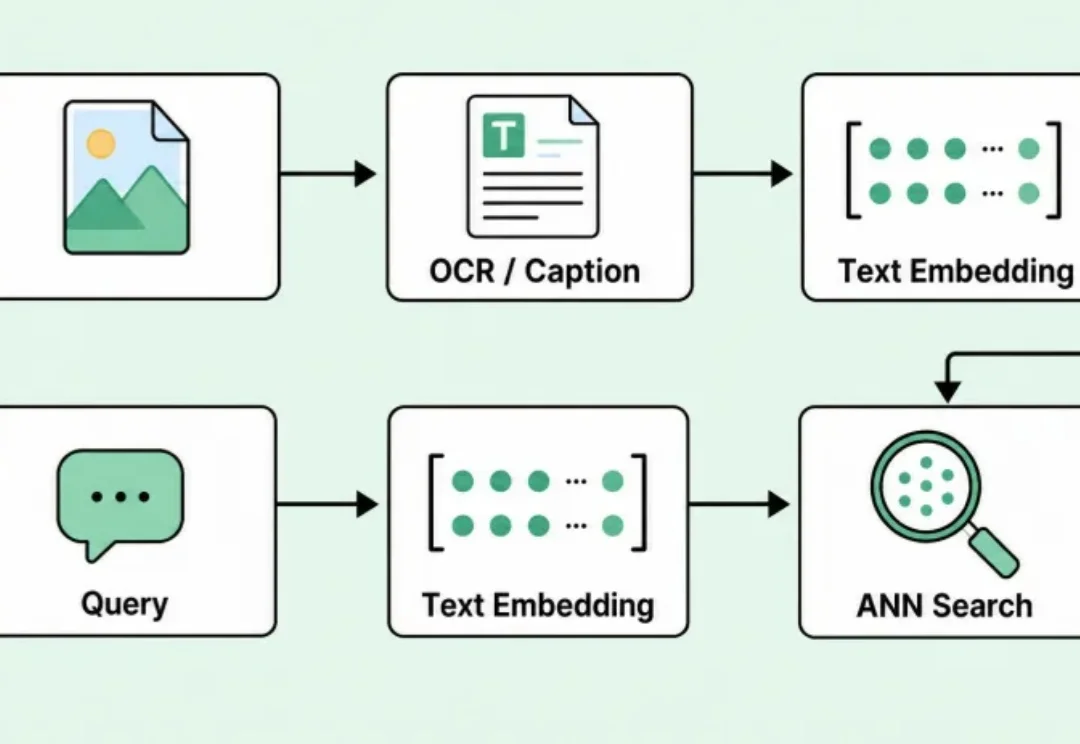
前不久,微信视觉团队开源了WeMM-Embedding。
研究团队提出了符号嵌入量子算法(Sign Embedding Quantum Algorithms),形成了一篇84页的量子算法论文。可以说,相比此前主要解决研究者给定的开放数学问题,这一次,AIM开始参与研究问题的提出与方向探索。
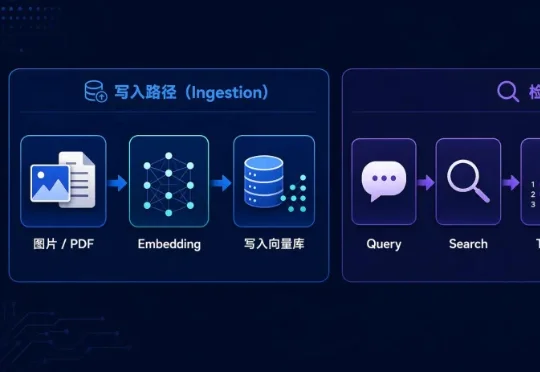
多模态 Agent 的记忆系统,过去很容易被理解成一个升级版 RAG:图片、图表、PDF 进来之后,先抽取内容、做 embedding、写进向量库;用户提问时,再用 query 做检索,把命中的top-k图片、文档页或图表一并塞进上下文,再交给多模态模型回答。整个过程中,所有原始模态信息都会不加选择的塞给大模型。
一篇发表于 2015 年的论文《LINE: Large-scale Information Network Embedding》被授予 Seoul Test of Time Award(时间检验奖)。这篇由国际知名 AI4S 科学家、Mila 终身教授、百奥几何公司创始人唐建博士领衔
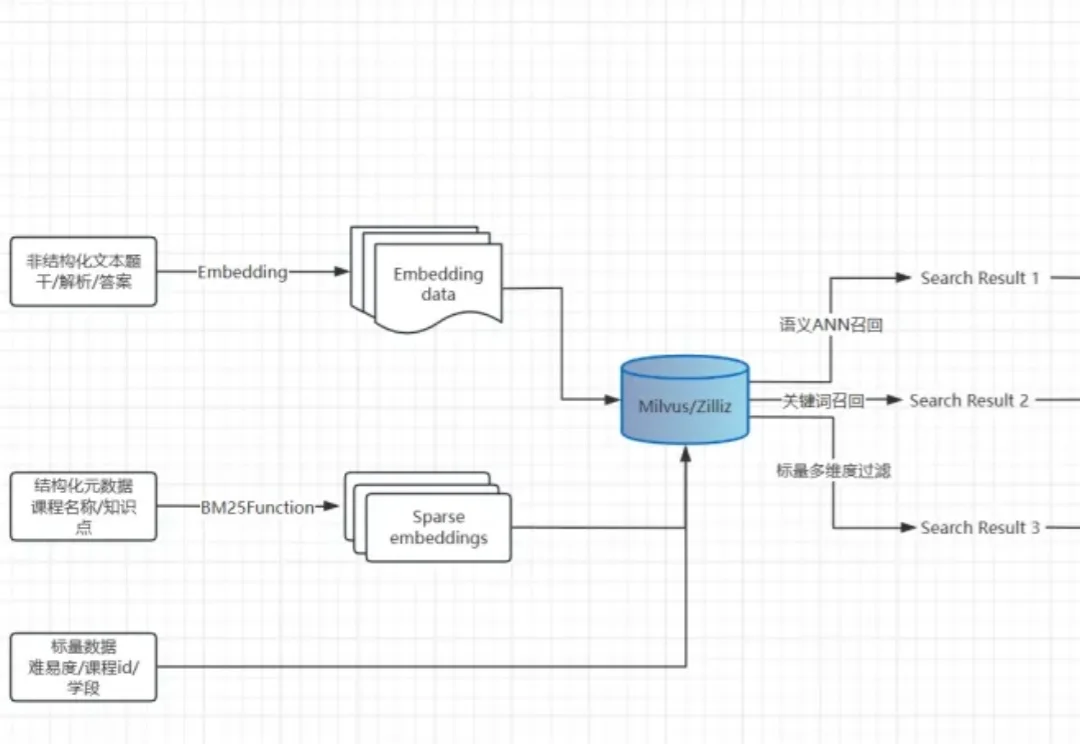
在教育科技领域,题库是核心资产,更是连接学生、教师与知识体系的关键入口。