无需参数访问!CMU用大模型自动优化视觉语言提示词 | CVPR’24
无需参数访问!CMU用大模型自动优化视觉语言提示词 | CVPR’24视觉语言模型(如 GPT-4o、DALL-E 3)通常拥有数十亿参数,且模型权重不公开,使得传统的白盒优化方法(如反向传播)难以实施。
来自主题: AI技术研报
5471 点击 2024-11-05 15:28

 搜索
视觉语言模型(如 GPT-4o、DALL-E 3)通常拥有数十亿参数,且模型权重不公开,使得传统的白盒优化方法(如反向传播)难以实施。
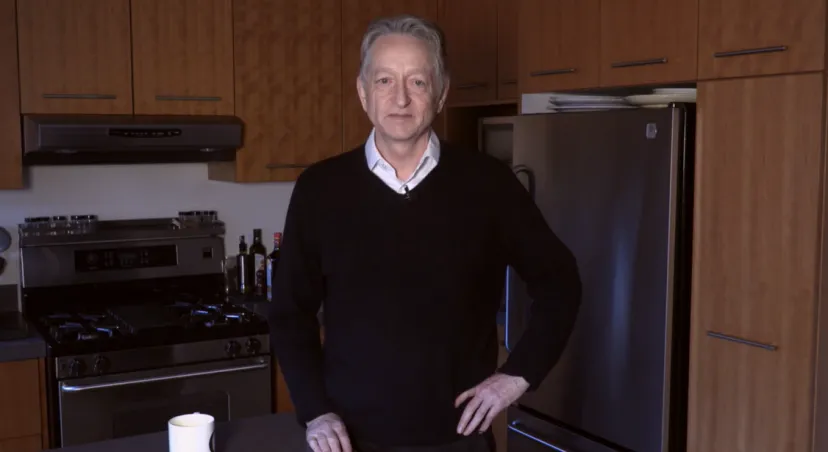
Hinton在人工智能领域的贡献极其卓越,被誉为 “神经网络之父”、“人工智能教父”。他的主要贡献包括:反向传播算法的改进与推广、深度学习模型的创新(深度置信网络、卷积神经网络等多个深度学习网络结构)。Hinton还为AI行业培养了包括OpenAI前首席科学家伊尔亚・苏茨克维(Ilya Sutskever)在内的诸多人才。
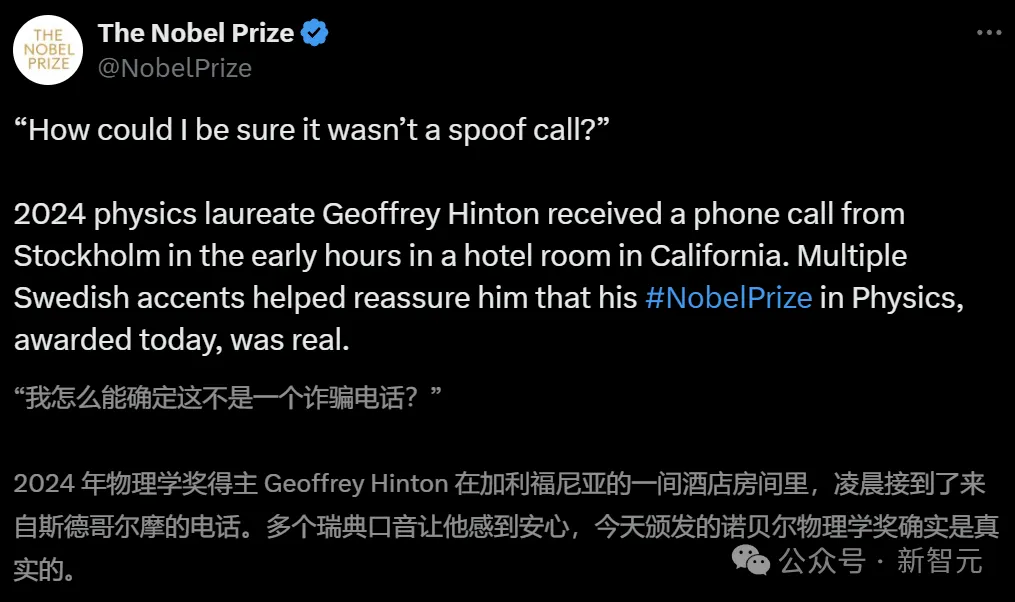
诺贝尔物理学奖公布第二天,争议依然未平息。诺奖官号都被愤怒的网友冲了:AI不是物理学!Hopfield网络和反向传播算法究竟与物理学有何关系?这要从Hinton和Ilya 12年前的那件事说起。
人工神经网络、深度学习方法和反向传播算法构成了现代机器学习和人工智能的基础。但现有方法往往是一个阶段更新网络权重,另一个阶段在使用或评估网络时权重保持不变。这与许多需要持续学习的应用程序形成鲜明对比。
用光训练神经网络,清华成果最新登上了Nature!
自从大型 Transformer 模型逐渐成为各个领域的统一架构,微调就成为了将预训练大模型应用到下游任务的重要手段
生物神经网络有一个重要的特点是高度可塑性,这使得自然生物体具有卓越的适应性,并且这种能力会影响神经系统的突触强度和拓扑结构。
开源大语言模型(LLM)百花齐放,为了让它们适应各种下游任务,微调(fine-tuning)是最广泛采用的基本方法。基于自动微分技术(auto-differentiation)的一阶优化器(SGD、Adam 等)虽然在模型微调中占据主流,然而在模型越来越大的今天,却带来越来越大的显存压力。