千万token下,比DeepSeek式稀疏注意力再快22倍
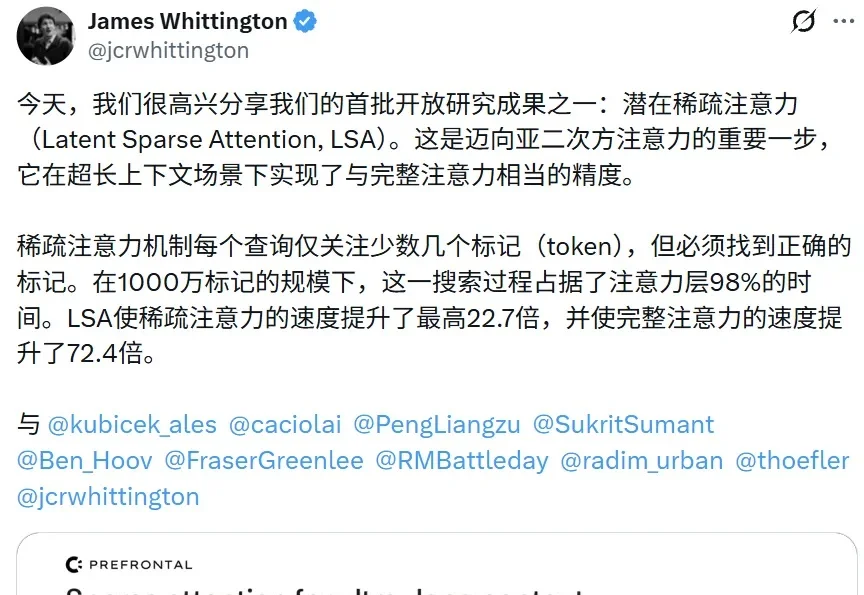
千万token下,比DeepSeek式稀疏注意力再快22倍如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。
搜索
如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。
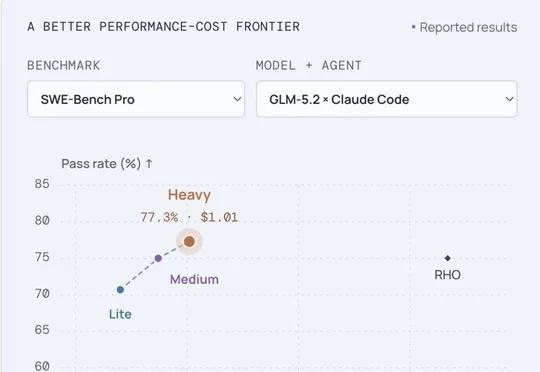
智谱唐杰团队发布并开源无标签递归自我改进框架HarnessPro,在SWE-Bench Pro等基准提升通过率的同时,将单任务平均成本降低53.0%。
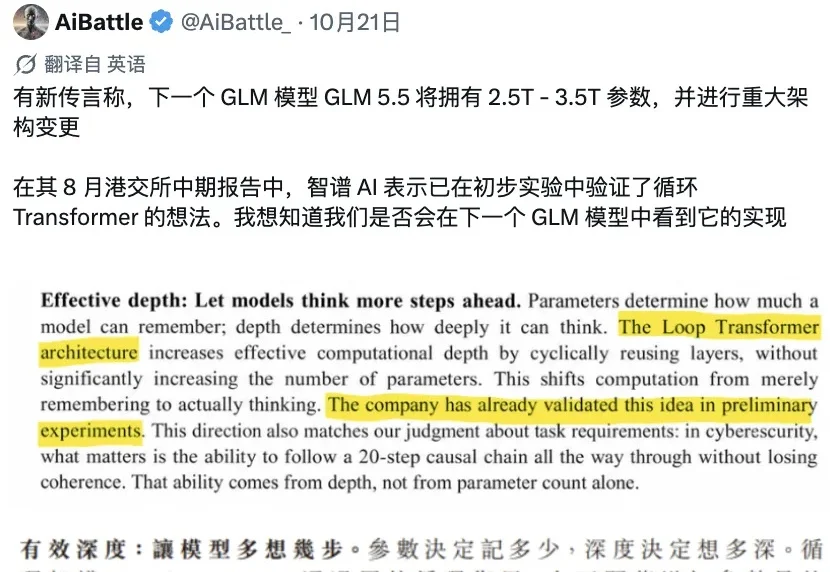
GLM-5.5,真的马上就来了?!
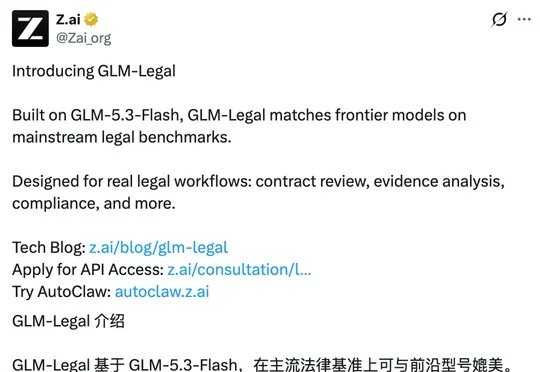
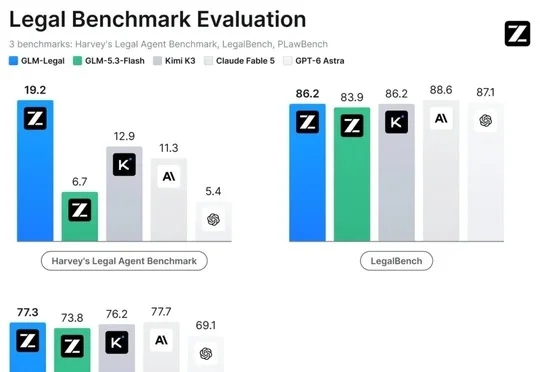
智谱推出法律专用开源模型GLM-Legal,可处理合同审查、证据分析和跨境合规,并在Vals AI法律测评中以19.2%的任务全通过率和86.23%的准确率位居Harvey LAB与LegalBench双榜开放权重模型榜首。
智谱旗下Z.ai发布基于GLM-5.3-Flash的法律专用模型GLM-Legal,面向合同审查、证据分析和合规研究,官方评测显示其在Harvey LAB明显领先、其余两项接近一线,目前需申请API权限且未开源。
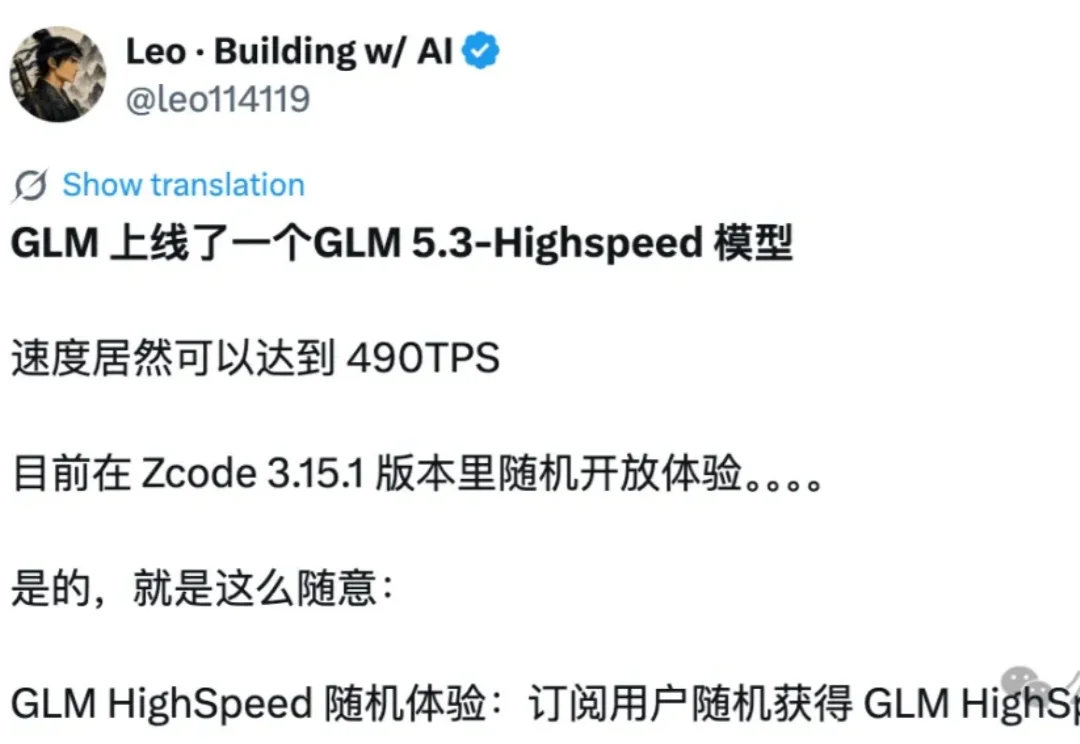
智谱上新了一个GLM-5.3-Highspeed模型,就在Zcode里。
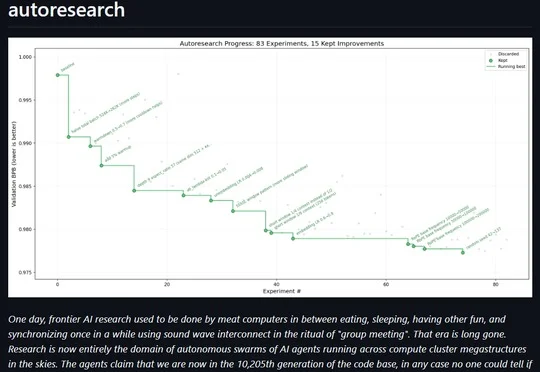
2026年,Anthropic披露Claude已主导26%的研发,OpenAI宣布自动化研究实习生达标,智谱与MiniMax推进工程优化,但Weco AI的AIDE²实验尚未证明系统能提升自我改进能力。
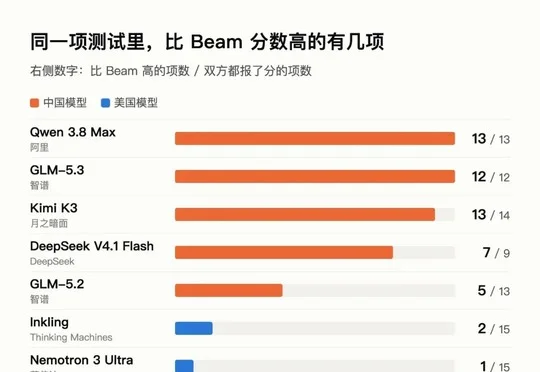
英伟达投资的Reflection发布开源模型Beam,采用MoE架构,专注代码、推理和Agent任务,官方称其以GLM-5.2三分之一至四分之一的推理算力取得相当成绩,但原始能力仍落后部分前沿开源模型,计划月底以Apache 2.0放出权重。
因OpenAI、Anthropic闭源模型价格高昂,AT&T、Tinder等美国大企业正将越来越多AI工作负载迁移至开放权重模型以控制成本,DeepSeek、智谱等中国开放模型成为本轮企业降本红利的最大受益者。
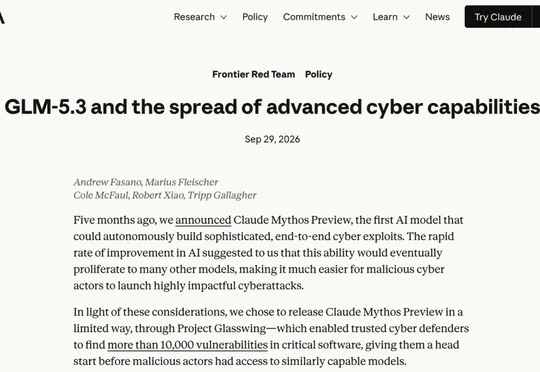
Anthropic发布网络安全评估报告指出,智谱AI的GLM-5.3已具备自主开发端到端网络漏洞利用程序的高级网络攻击能力,但其内置安全护栏极易被简单方法绕过或移除,导致恶意攻击者可轻易获取该能力。