4B模型下棋比肩大师、还会讲棋,陈丹琦团队怎么做到的?
4B模型下棋比肩大师、还会讲棋,陈丹琦团队怎么做到的?普林斯顿大学陈丹琦团队在arXiv发布约4B参数模型QUEEN,通过门控交叉注意力连接Leela与SmolLM3-3B,并引入四阶段课程和迭代搜索蒸馏,使其棋力接近特级大师且能用自然语言解释着法。
来自主题: AI技术研报
8654 点击 2026-10-07 15:18

 搜索
普林斯顿大学陈丹琦团队在arXiv发布约4B参数模型QUEEN,通过门控交叉注意力连接Leela与SmolLM3-3B,并引入四阶段课程和迭代搜索蒸馏,使其棋力接近特级大师且能用自然语言解释着法。
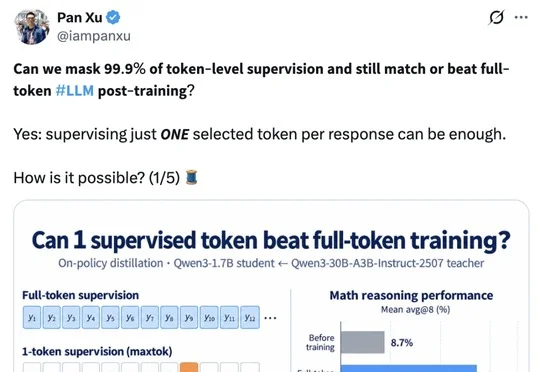
亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。
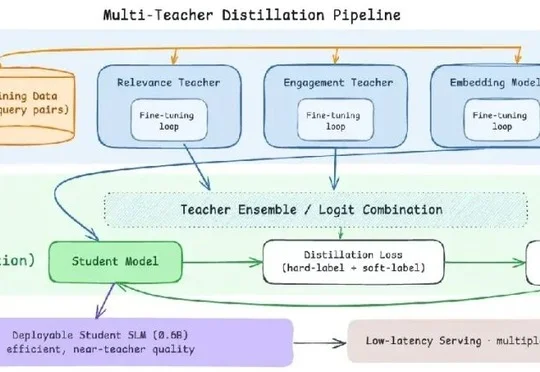
LinkedIn 公开其 AI 职位搜索的多教师蒸馏训练基础设施,通过基于 SGLang 的定制框架结合在线与离线蒸馏方案,并叠加 LiGer、多节点训练、FSDP2 及 H200 集群等优化,实现约 8 倍训练加速,将 80 亿参数相关性模型和 17 亿参数互动模型的知识压缩至 6 亿参数排序模型,使职位搜索 NDCG@10 提升 24.48%。
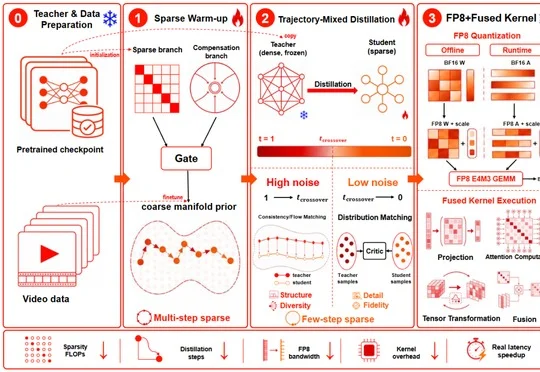
北京大学、清华大学与阿里巴巴等机构联合提出SparkDiffusion视频生成加速系统,通过融合稀疏注意力、少步蒸馏与FP8量化,在单卡RTX 5090上实现最高720倍推理加速,可在18秒内生成5秒720P视频,并已完整开源权重与训练代码。
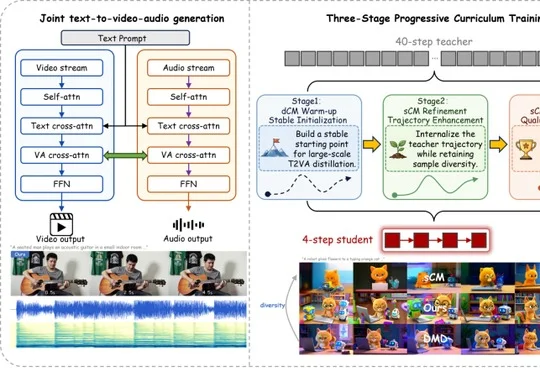
浙江大学、清华大学与新加坡国立大学团队推出TurboT2VA,采用分布蒸馏与轨迹蒸馏联合方案将音视频生成速度提升54.67倍,在单张H20上将1024×1792分辨率121帧的生成耗时从318.74秒降至5.83秒。
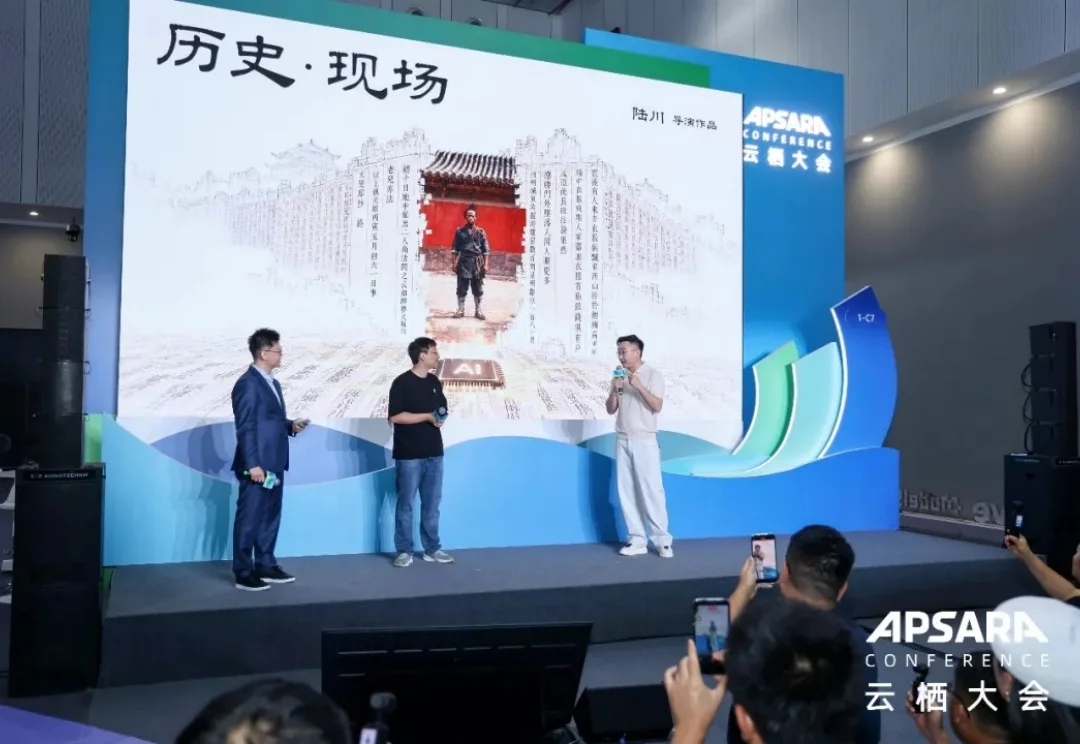
一名电影导演,主动把自己蒸馏成skill。
过去一年,AI数据市场经历了几轮剧烈的主题切换:从标准Coding到垂直行业,从合成蒸馏到真实场景,从任务够长就是好数据到什么任务值得解。需求每两个月刷新一次,供给侧的生存法则也在同步重写。在这个过程中,一些原本隐身于产业链深处的角色开始浮出水面——数商,就是其中之一。
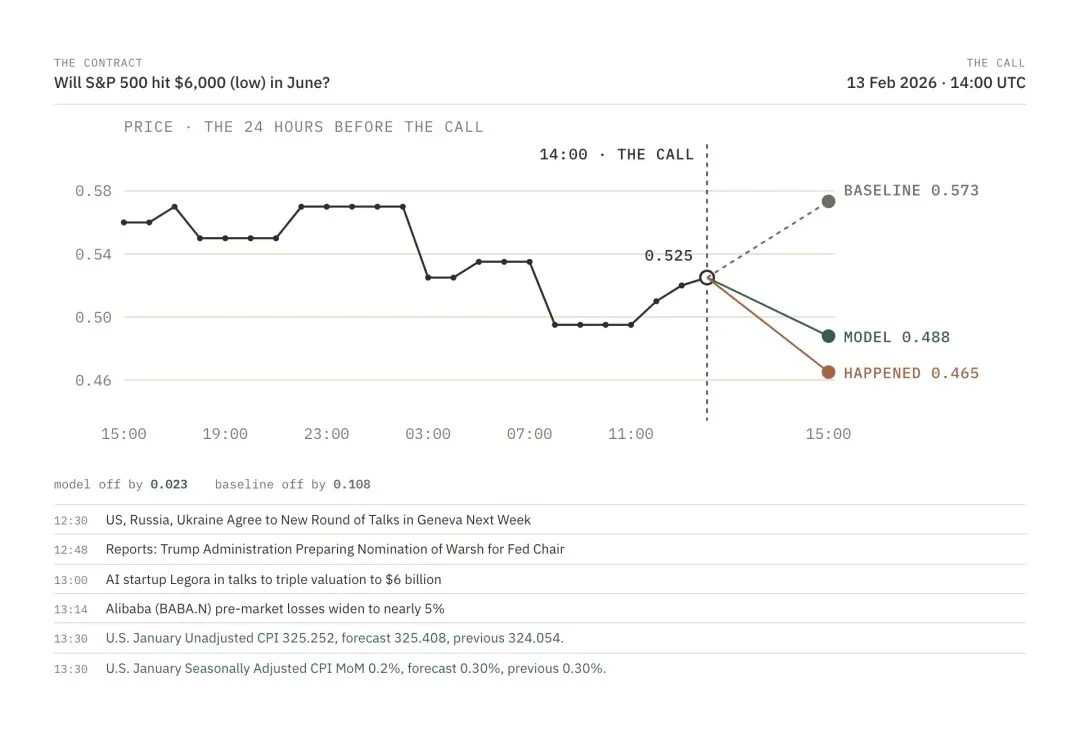
在社会变化的洪流中,LLM 能不能不断修正自己对社会的认知?
Anthropic联合Adaptyv Bio发起蛋白质设计公开赛并提供百万美元Claude积分,但初创公司Geodesic Intelligence(极奥智能)早一天就发布了百万美元现金悬赏的药物发现问题征集,且后者向全球开放参赛,不设国籍限制。
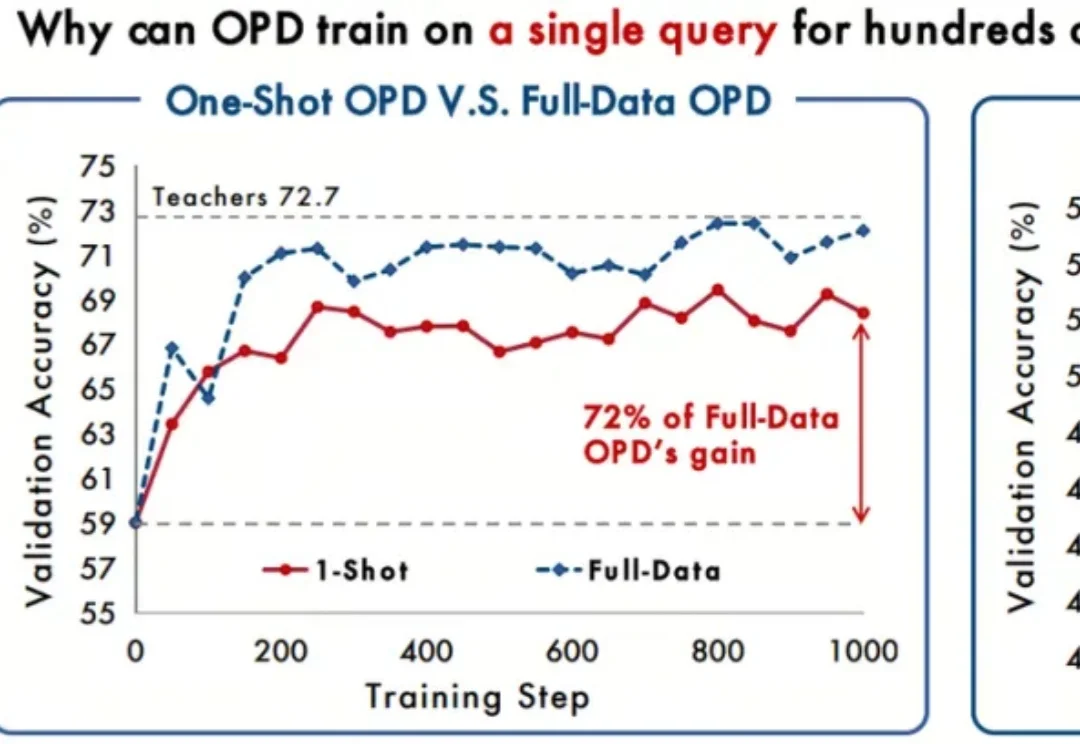
把 On-Policy Distillation(在线策略蒸馏,OPD)的训练集从 17000 道题删到 1 道,会发生什么?