
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
真实家庭任务往往从「不完整的信息」开始:机器人不知道目标在哪里,用户也未必能一次说清自己想要什么。面对「帮我从餐桌上拿点零食」这样的模糊指令,机器人不仅要主动寻找候选物体,还要在发现面包和多个甜甜圈后进一步询问用户,确认究竟该拿哪一个。
在真实世界里,探索环境、理解意图和执行动作,本就不是三个彼此独立的问题。
围绕这一问题,来自上海交通大学、上海人工智能实验室等机构的研究者提出 REAL,一个面向开放世界移动操作的可探索、可交互、可部署的视觉具身智能体框架,并构建了贯穿仿真、数据生成、模型训练、系统评测与真机部署的完整技术链路。这篇工作已被 ECCV 2026接收。
📄 论文链接:https://arxiv.org/abs/2607.13653
🏗️ 项目主页:https://internrobotics.github.io/REAL/
💻 开源代码:https://github.com/InternRobotics/REAL
面向从仿真到真实世界的迁移,REAL 重点针对现有具身智能体仿真环境中两项被过度理想化的假设:环境信息充分可知与用户意图清晰明确。而在真实部署中,智能体往往面临相反的情况——环境未知,机器人缺乏先验感知;以及意图模糊,用户难以在任务开始时一次性明确需求。具体而言:
首先是环境状态信息缺失。现有仿真环境通常通过特权感知接口(oracle perception API)提供任务相关物体的数量、位置等真实信息,但在真实环境中这些信息无法被直接获取,智能体需要依靠主动探索发现物体。依赖特权信息训练得到的智能体,在真实部署中往往缺乏自主感知与探索能力。
其次是用户意图信息模糊。现有的具身智能体评测任务通常假定指令是清晰明确的,但真实场景下的用户未必知晓环境全貌,往往只能给出模糊需求,并根据智能体的反馈逐步细化任务。因此,真实环境下的智能体需要能反馈当前环境状态,并按照用户需求调整后续行为。
为应对这两类不确定性,REAL 将主动探索、视觉目标定位、自然语言意图消歧和物理操作统一到同一决策闭环中:系统以第一视角 RGB 观测为主要感知输入,并结合建图系统提供的承载区域(如桌面、柜子)作为搜索先验;当智能体在探索阶段发现多个候选目标时,智能体会主动汇报探索结果并请求用户细化指令(例如:「我找到了一个面包和两个不同的甜甜圈,您想要哪一个?」);智能体的询问由当前探索结果触发,用户反馈则进一步细化任务目标。通过这一机制,环境探索、意图确认与物理执行被统一到同一决策闭环中。
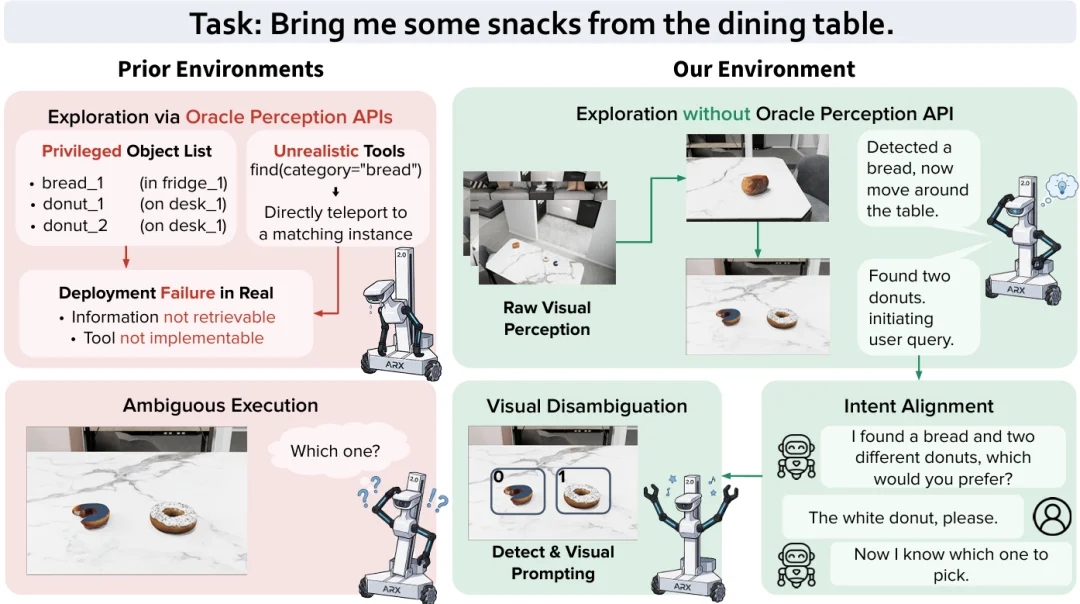
图 1. REAL 的工作模式与既往执行方式的对比
REAL 构建于 InternUtopia 仿真平台之上,利用其高保真渲染能力、丰富的可交互仿真场景与资产,设计了适用于移动操作智能体的数据采集、训练和评测管线,最终形成了一套面向开放世界移动操作的 Agentic 框架。该框架的系统顶层架构由以下三大核心组件构成:
Nav_to、Walk_around、Show_object_by_category、Gaze_at),用于底层物理执行的控制接口(Pick、Place、Open、Close),以及用于发现歧义并提问的主动交互工具(Ask)。为了实现工具的有效组织,框架引入了模型上下文协议(Model Context Protocol,MCP)作为统一的接口标准。高层大脑只需输出离散工具调用,通过 MCP 服务器下发并执行,从而实现了认知规划与底层执行的解耦。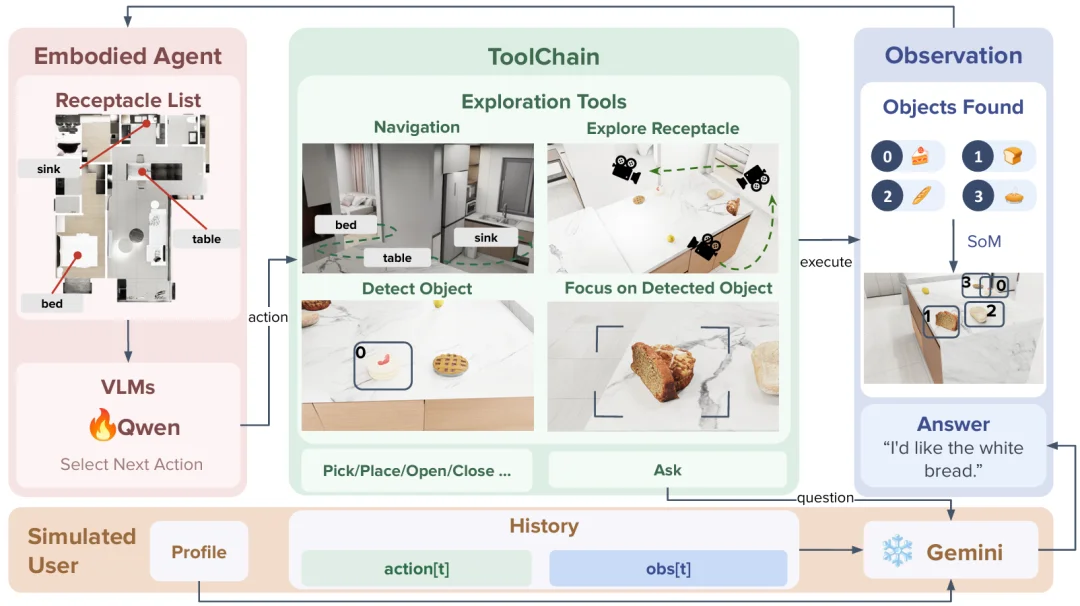
图 2. REAL 框架设计
基于这一顶层架构,REAL 在环境、数据与部署层面实现了三项核心贡献:
无特权感知的主动探索与交互
在 REAL 框架中,智能体仅接收可获取的结构先验,即承载区域或场景节点(如桌面、柜体)的 ID 与语义类别。为了定位目标,智能体通过四步探索工具链(导航、多视角扫描、目标检测、对齐注视)主动获取视觉信息。系统将检测到的 2D 分割掩码反投影到 3D 空间以构建临时探索地图,并通过 SoM(Set-of-Mark)为物体分配视觉 ID。后续的抓取、放置等操作均基于视觉 ID 调用,使机器人能够完成视觉目标定位与消歧,有效区分同类但外观不同的物体。同时,REAL 接入了一个由大模型驱动的模拟用户,它能依据当前已发现的物体和任务配置给出回答,使主动沟通成为由探索结果直接触发的执行环节。
基于 MCP 协议的高低层解耦执行
得益于 MCP 协议的引入,模型「大脑」可以始终专注于任务规划与状态跟踪,并输出统一格式的离散工具调用。在此机制下,仿真环境与真实环境通过统一的工具接口被抽象为一致的交互空间。当系统迁移到真机部署时,底层的连续物理控制由微调后的 $\pi_{0.5}$ 模型等专门的物理技能来接管。这种高低层解耦的设计,使得高层策略在完全不重新训练的情况下,就能直接零样本迁移到真实的物理机器人上。
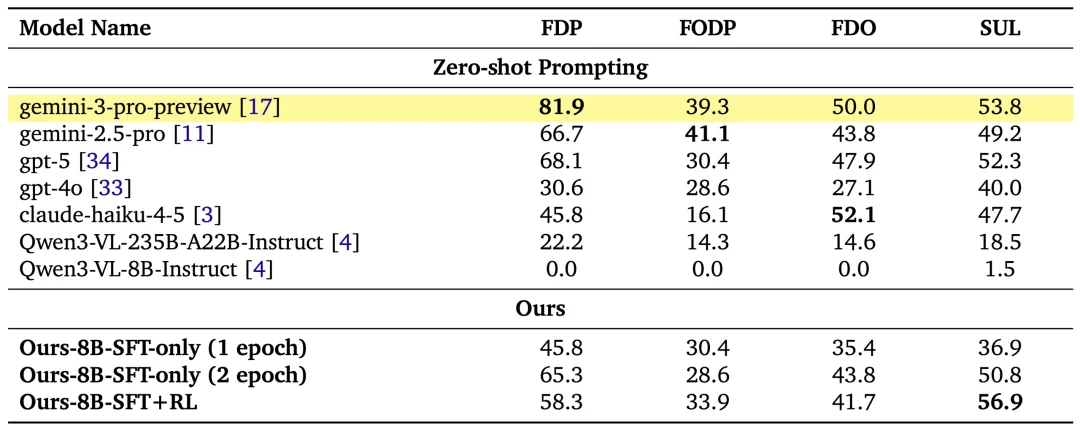
智能体采用 Qwen3-VL-8B-Instruct 作为基座模型,以兼顾多模态能力与机器人侧的推理效率。针对长程任务中容易出现的上下文膨胀问题,系统将决策过程建模为部分可观察马尔可夫决策过程,并使用结构化的自摘要历史状态,避免了在每一步重复拼接完整的交互轨迹。整个训练管线分为两个核心阶段:
Ask 调用及模拟用户的回答。这使得模型初步掌握了探索、操作和沟通工具的基础调用范式。通过这套双阶段训练管线,训练后的策略会根据环境的真实反馈,自主决定何时继续探索、何时重新规划,以及何时向用户确认。
Ask,并根据用户反馈完成目标对齐。四类任务共同覆盖「探索—定位—操作—沟通」的完整执行过程,并从不同侧面检验智能体应对视觉干扰、感知动态状态、交互决策和主动探索的能力。
为了验证 sim-to-real 能力,团队将训练得到的高层策略零样本迁移到 ARX LIFT2 双臂移动机器人:
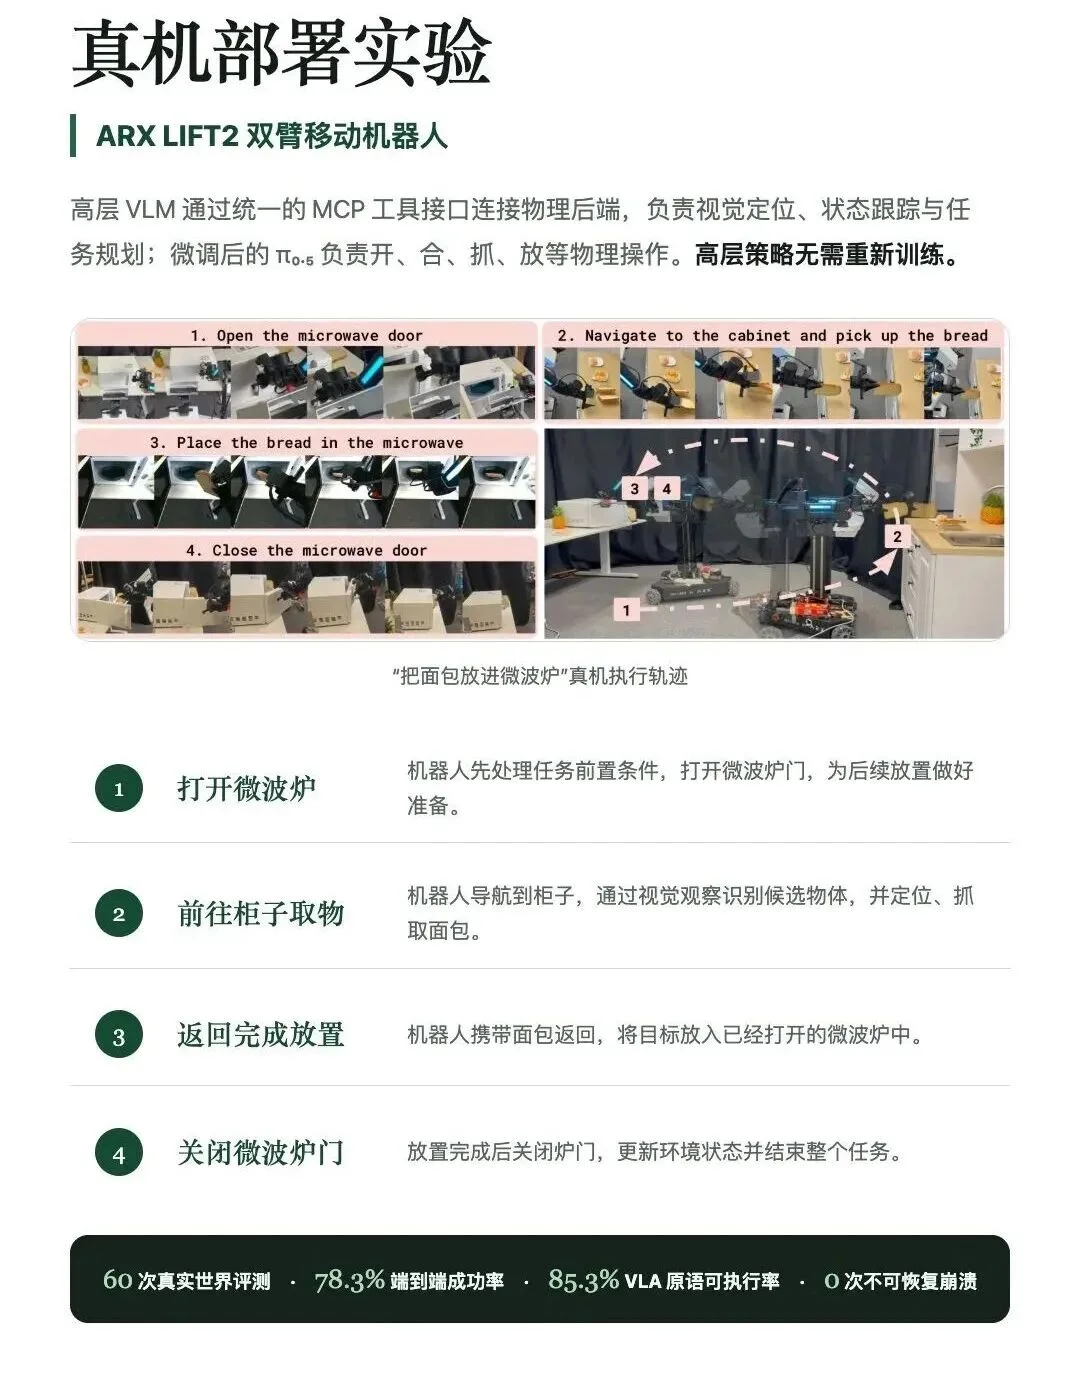
图 4. 真实任务中的部署验证了 REAL 的有效性
「把面包放进微波炉」这一任务直观展示了 REAL 在长程任务中的规划与状态维护能力。机器人并没有直接前往柜子取面包,而是先打开微波炉,再去柜子抓取面包,最后返回微波炉,放入面包并关门。这一执行顺序体现了系统对任务前置条件与操作依赖关系的理解。与此同时,REAL 通过结构化历史状态持续记录并更新当前任务进展,进展中仅保留与后续决策相关、并经过工具反馈验证的信息,而非完整的历史交互轨迹,从而避免了上下文的快速增长,减少了执行中的状态遗忘与错误累积。
REAL 的核心是重新设计仿真训练与真实部署之间的信息边界,使具身智能体不再依赖两项传统的理想化假设——依赖现实中无法获取的「完美感知」,以及假定用户总能给出明确、完整的指令,转而面向更真实的部署条件:智能体必须通过视觉探索主动获取环境证据,在必要时通过沟通补全用户意图,并最终调用可部署的物理技能完成任务。
在此基础上,REAL 借助统一的 MCP 工具接口,将高层视觉推理与具体物理执行后端深度解耦,使得同一套高层策略能够从仿真环境零样本迁移至真实双臂移动机器人。REAL-Bench 与真机实验一致表明,促使模型学会在「看不全、说不清、执行会失败」的非理想条件下持续闭环决策,提供了一条具身智能从受限基准迈向真实世界的有效路径。
文章来自于"机器之心",作者 "机器之心"。


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】XTuner 是一个高效、灵活、全能的轻量化大模型微调工具库。它帮助开发者提供一个简单易用的平台,可以对大语言模型(LLM)和多模态图文模型(VLM)进行预训练和轻量级微调。XTuner 支持多种微调算法,如 QLoRA、LoRA 和全量参数微调。
项目地址:https://github.com/InternLM/xtuner
