Coding agent写测试集体失败!AI代码合格率被高估一倍
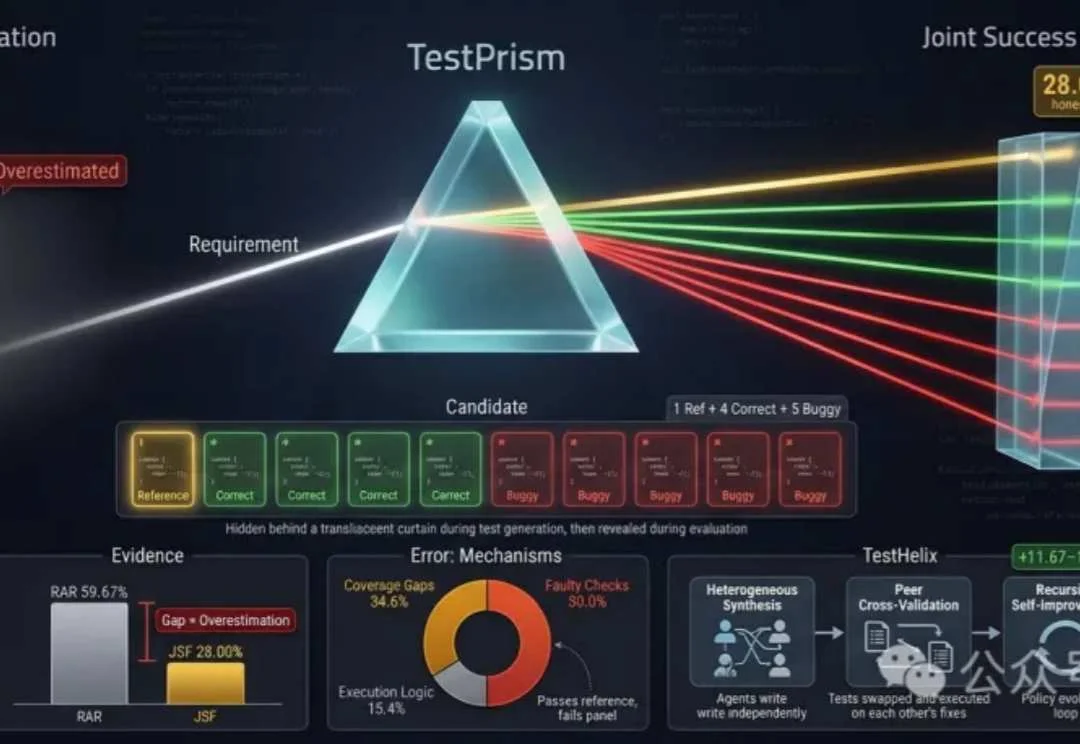
Coding agent写测试集体失败!AI代码合格率被高估一倍Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。
搜索
Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。
机器人正迎来自己的 Computer Use 时刻。
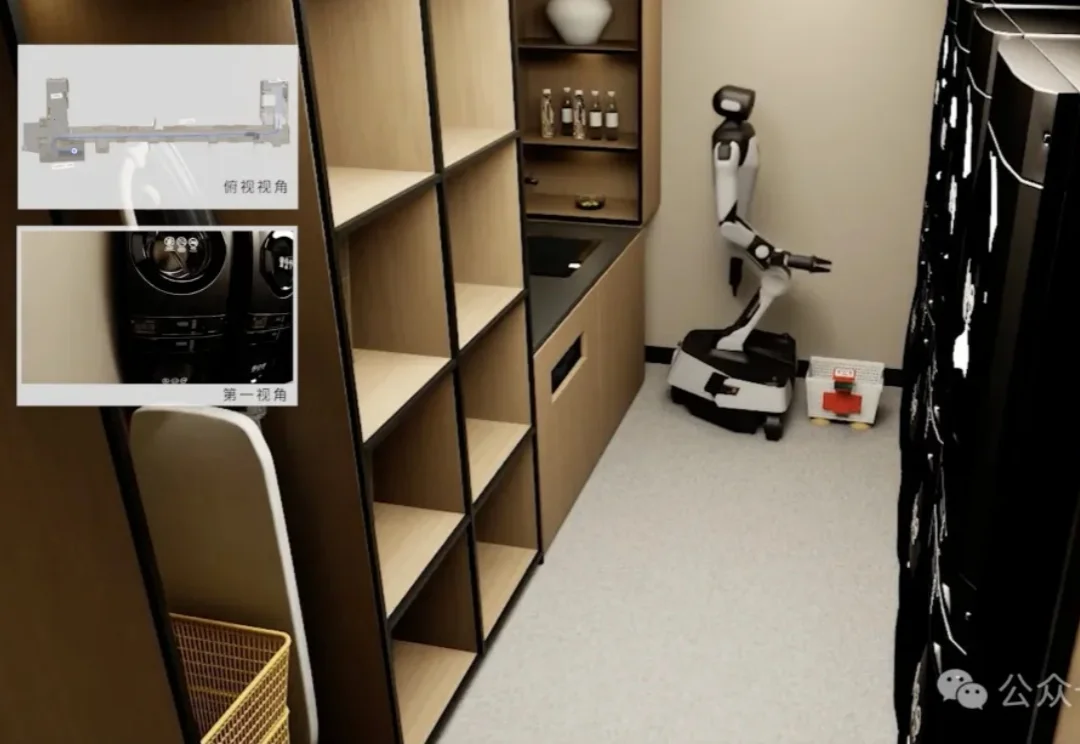
啥,机器人已经能接管酒店洗衣房了??
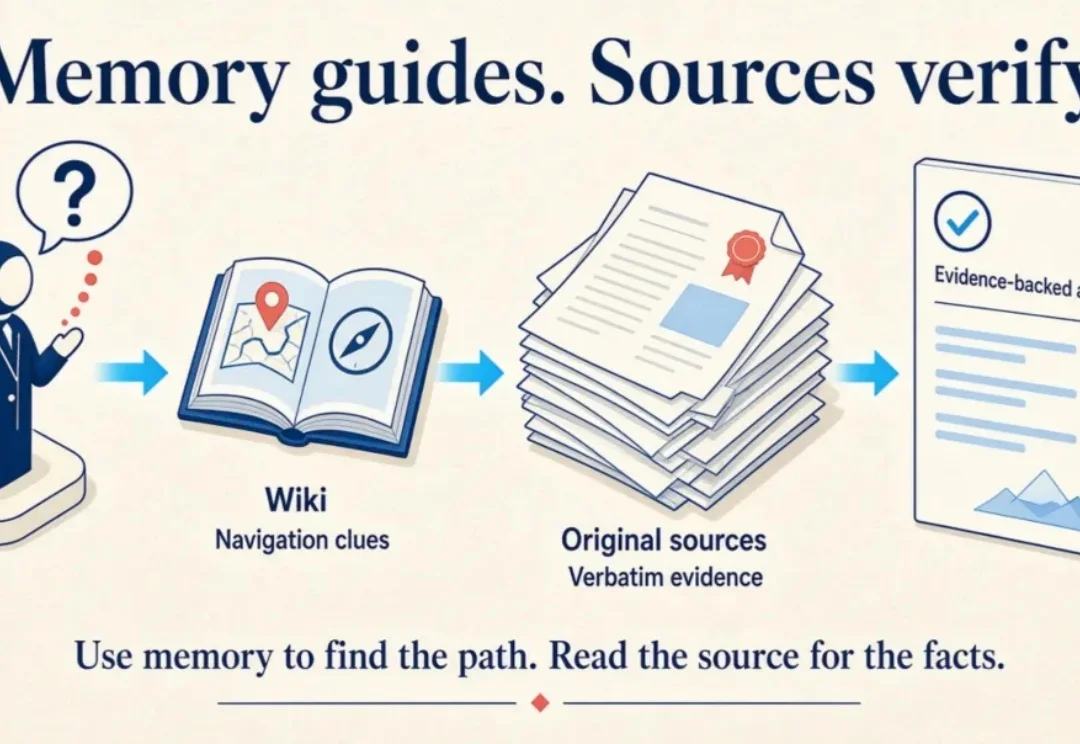
前不久,Anthropic 的工程团队在 11 月 6 日发了一篇文章《The components of agent memory》。里面有一个非常有意思的观察:很多被精心设计过的知识wiki或者Agent Memory准确率有时候还不如直接搜索原始文档高。但换个场景,过多的原始信息塞给模型,有时候也同样会让检索的准确率暴跌。
多模态Agent交付亮眼,连“画地为牢”梗都接住了。
AI Agent驱动的超级个体。 现在给AI 安排的工作已经可以到什么地步了? 写代码只是其中一项,让Agent全天盯着GitHub,收到用户反馈就检查代码、尝试修复问题,还有让它跟进客户,甚至每天定
智能正在走向更持续的理解与行动。围绕一个目标,Agent 理解上下文、制定计划,在执行中验证判断;面对新的信息,它重新评估已有结论,调整行动路径,继续推进任务。未来,更多智能将融入我们日常使用的应用。
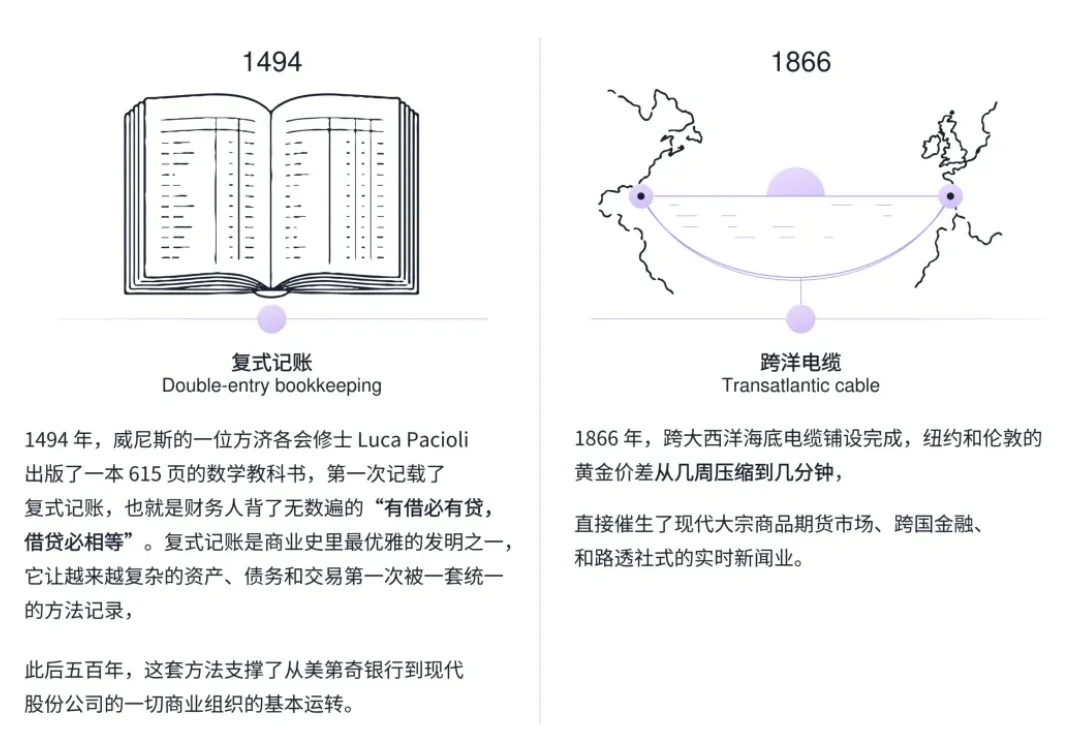
每一次经济活动的规模化跃迁,背后总有一次基建的大机会。
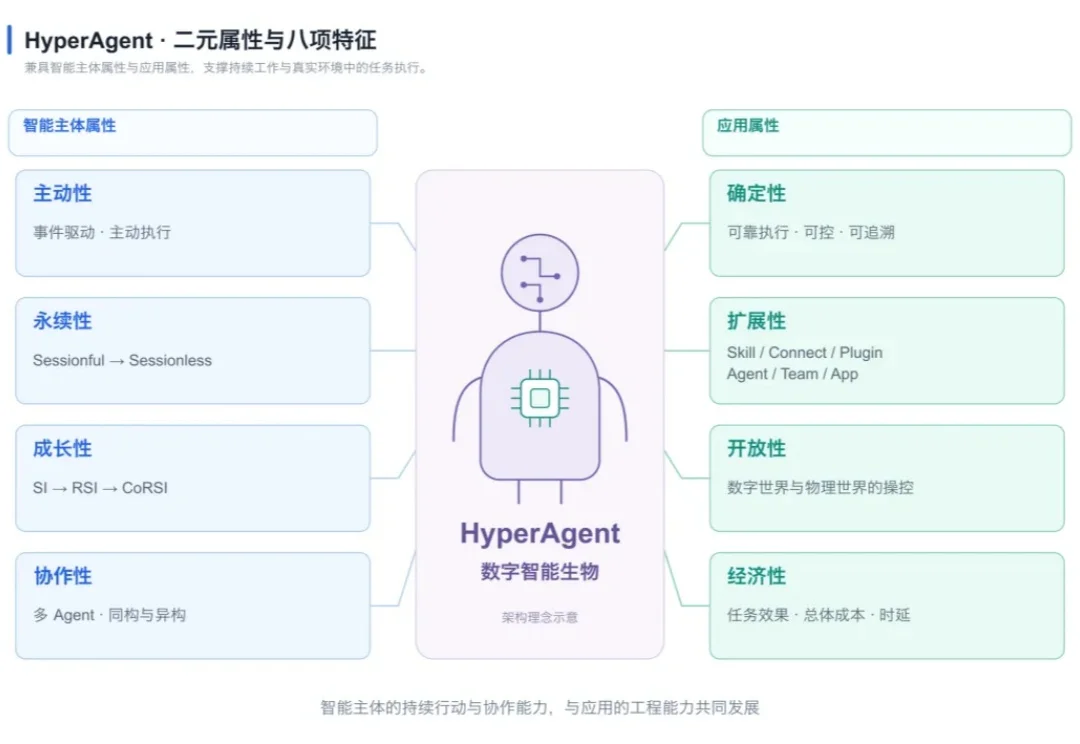
Agent 正在从「回答一个问题」走向「承担一份工作」。近日,开源 AI Agent 社区 openJiuwen 针对 HyperAgent 架构详细解读,系统阐述了它对下一代 Agent 形态的判断 ——HyperAgent 应具备的八项特征,以及支撑这一形态的开源 AgentOS 分层设计。
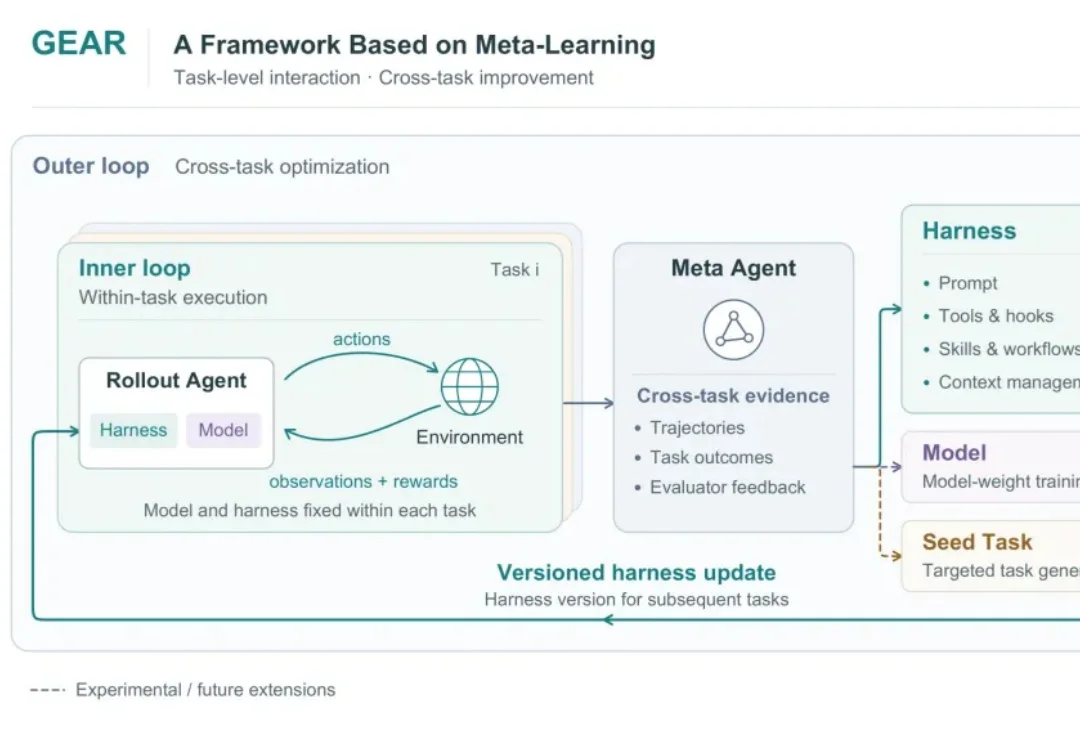
GEAR 可以让研究者像使用 Scikit-learn 一样模块化构建 RSI 算法。它将采样、候选评测和多样性管理所需的算法模块与并行推理等测评设施组织起来,使得 RSI 算法能够快速搭建、比较和复用。基于 GEPA(Genetic-Pareto)算法改进的实验结果证明,GEAR 调优的 Agent 在营销、客服和代码任务上均取得显著提升。