OpenAI也缺卡!僧多粥少,自曝内部抢卡抢到发疯
OpenAI也缺卡!僧多粥少,自曝内部抢卡抢到发疯OpenAI正面临绝对的算力稀缺。
来自主题: AI资讯
10231 点击 2025-10-22 13:03

 搜索
OpenAI正面临绝对的算力稀缺。
最近机器人和 AI 相关领域的读者或多或少都在关注 IROS。
游戏太多,玩家却不够了。这是海外科技媒体TechSpot在不久前发布的一篇文章中描述的情况,他们警告游戏行业可能会出现结构性错配。
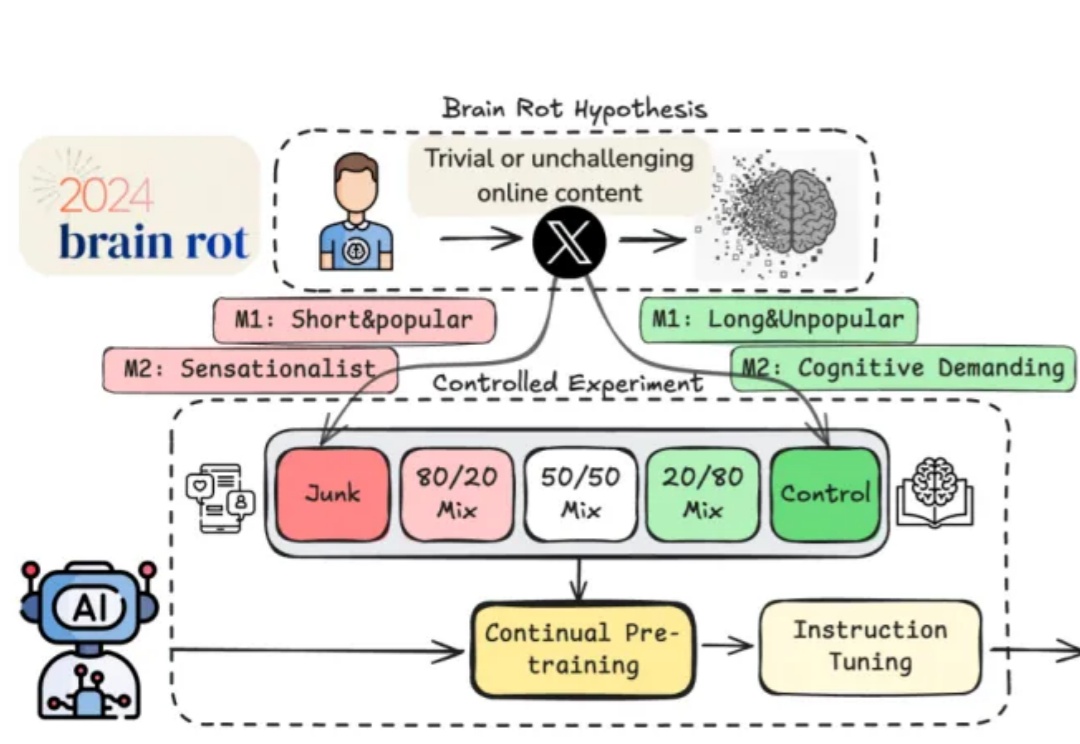
“脑腐”(Brain Rot)指的是接触了过多社交媒体的低质量、碎片化信息后,人类的精神和智力状态恶化,如同腐烂一般。它曾入选 2024 年牛津大学出版社年度热词。
DeepSeek最新开源的模型,已经被硅谷夸疯了!
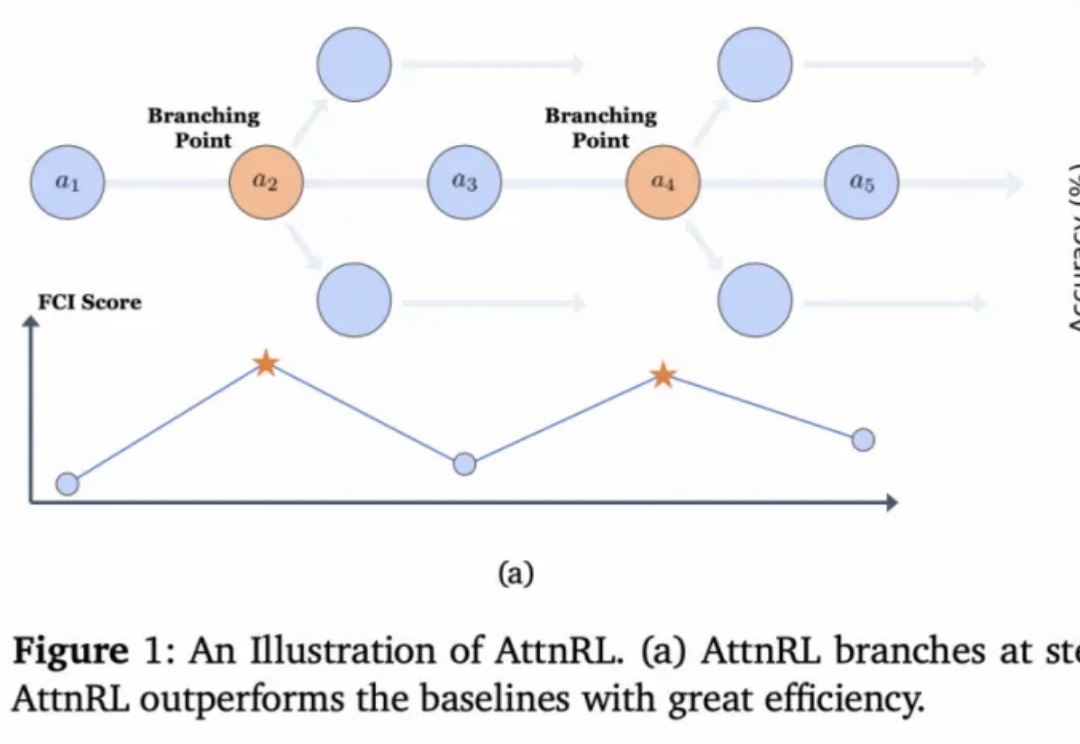
从 AlphaGo 战胜人类棋手,到 GPT 系列展现出惊人的推理与语言能力,强化学习(Reinforcement Learning, RL)一直是让机器「学会思考」的关键驱动力。
UC Berkeley、UW、AI2 等机构联合团队最新工作提出:在恰当的训练范式下,强化学习(RL)不仅能「打磨」已有能力,更能逼出「全新算法」级的推理模式。他们构建了一个专门验证这一命题的测试框架 DELTA,并观察到从「零奖励」到接近100%突破式跃迁的「RL grokking」现象。
昨天晚上闲着没事,想在 DeepSeek 搜一下 AI 博主有哪些可以学习的。 结果没想到,搜索结果里竟然出现了我自己。 内心 OS:祖坟冒青烟了,妈妈我出息了,我被 AI 认证了,以后简历可以写被
你还在依赖 SEO 和社交媒体为产品导流吗?这些传统增长驱动可能面临失效的困境了。我最近听了一场让我震惊的演讲,来自 Lovable 的增长负责人 Elena Verna。她用一组数据直接把现实摆在我
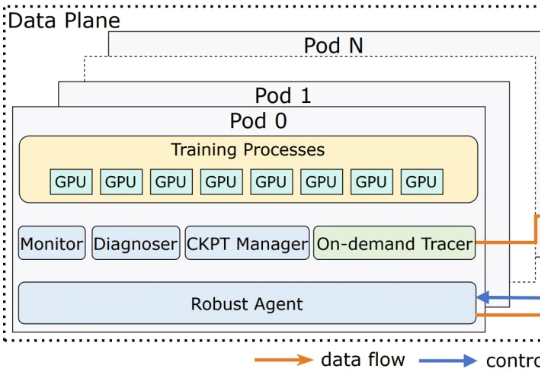
近日,字节跳动一篇论文介绍了他们 LLM 训练基础设施 ByteRobust,引发广泛关注。现在,在训练基础设施层面上,我们终于知道字节跳动会如何稳健地训练豆包了。