字节豆包、武大提出 CAL:通过视觉相关的 token 增强多模态对齐效果
字节豆包、武大提出 CAL:通过视觉相关的 token 增强多模态对齐效果当前主流的视觉语言模型(VLM)主要基于大语言模型(LLM)进一步微调。因此需要通过各种方式将图像映射到 LLM 的嵌入空间,然后使用自回归方式根据图像 token 预测答案。
来自主题: AI技术研报
10249 点击 2024-06-17 19:35

 搜索
当前主流的视觉语言模型(VLM)主要基于大语言模型(LLM)进一步微调。因此需要通过各种方式将图像映射到 LLM 的嵌入空间,然后使用自回归方式根据图像 token 预测答案。
通过算法层面的创新,未来大语言模型做数学题的水平会不断地提高。
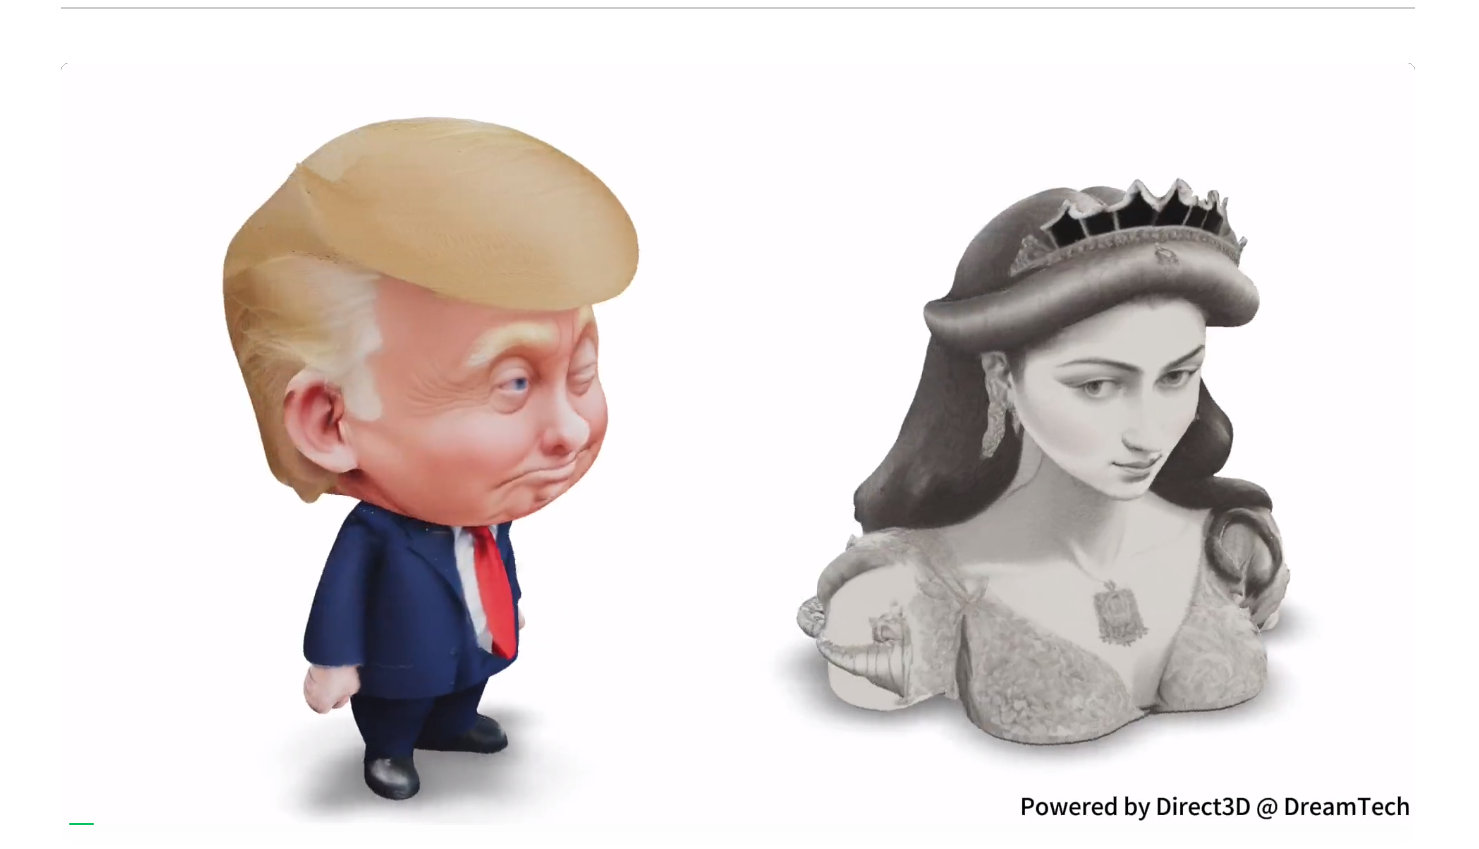
2024 年 5 月,DreamTech 官宣了其高质量 3D 生成大模型 Direct3D,并公开了相关学术论文 Direct3D: Scalable Image-to-3D Generation via 3D Latent Diffusion Transformer。
语言将是获得更智能系统的重要组成部分。

苹果讲了一个按Query难度分发模型的模式:B小模型:大多数场景,包括自动回复、改写、语法检查、Summary都用端侧的小模型跑。
文章讲述了彩云科技团队在改进Transformer架构方面的努力,尤其是推出的全新通用模型架构DCFormer,以及团队面临的种种挑战和突破。
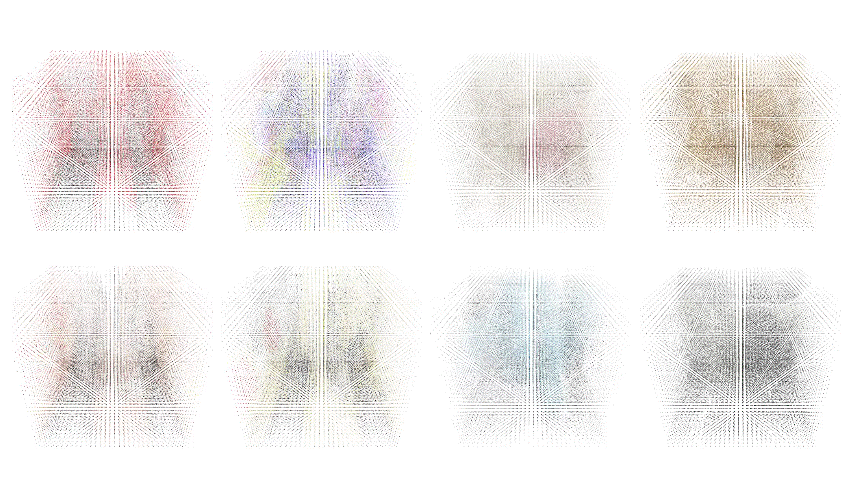
在三维生成建模的研究领域,现行的两大类 3D 表示方法要么基于拟合能力不足的隐式解码器,要么缺乏清晰定义的空间结构难以与主流的 3D 扩散技术融合。来自中科大、清华和微软亚洲研究院的研究人员提出了 GaussianCube,这是一种具有强大拟合能力的显式结构化三维表示,并且可以无缝应用于目前主流的 3D 扩散模型中。
AI 将大大提高数学研究的效率。
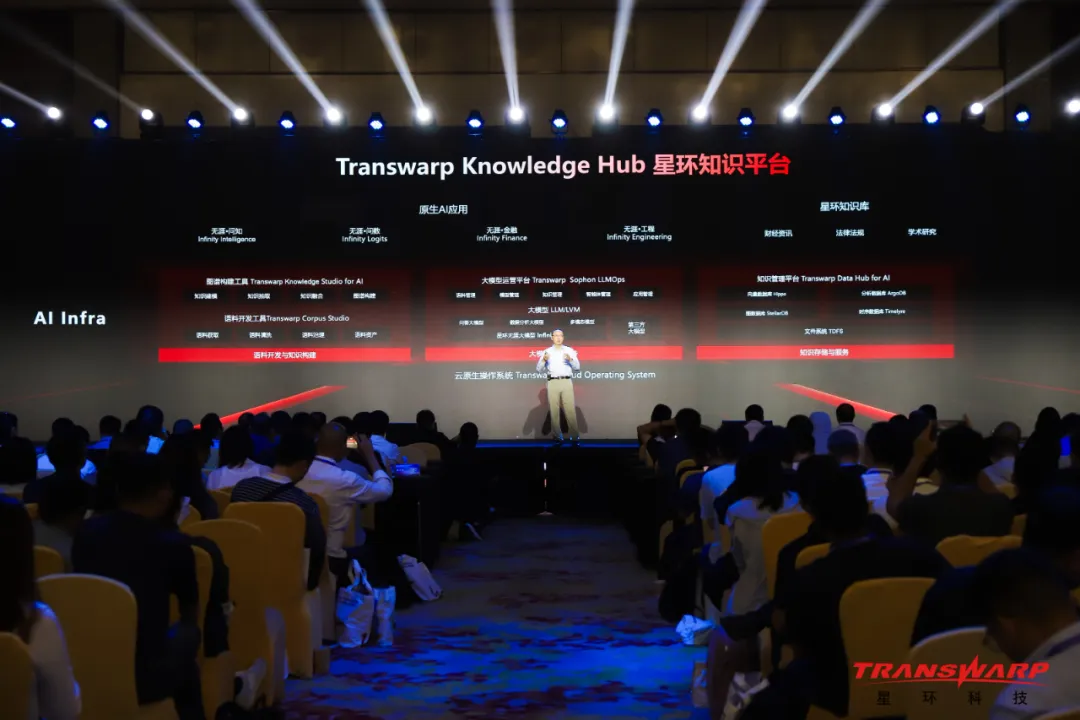
「原来以为语料已经匮乏了,大模型训练已经没有语料了,实际上不是的,数据还远远没有跑光」。
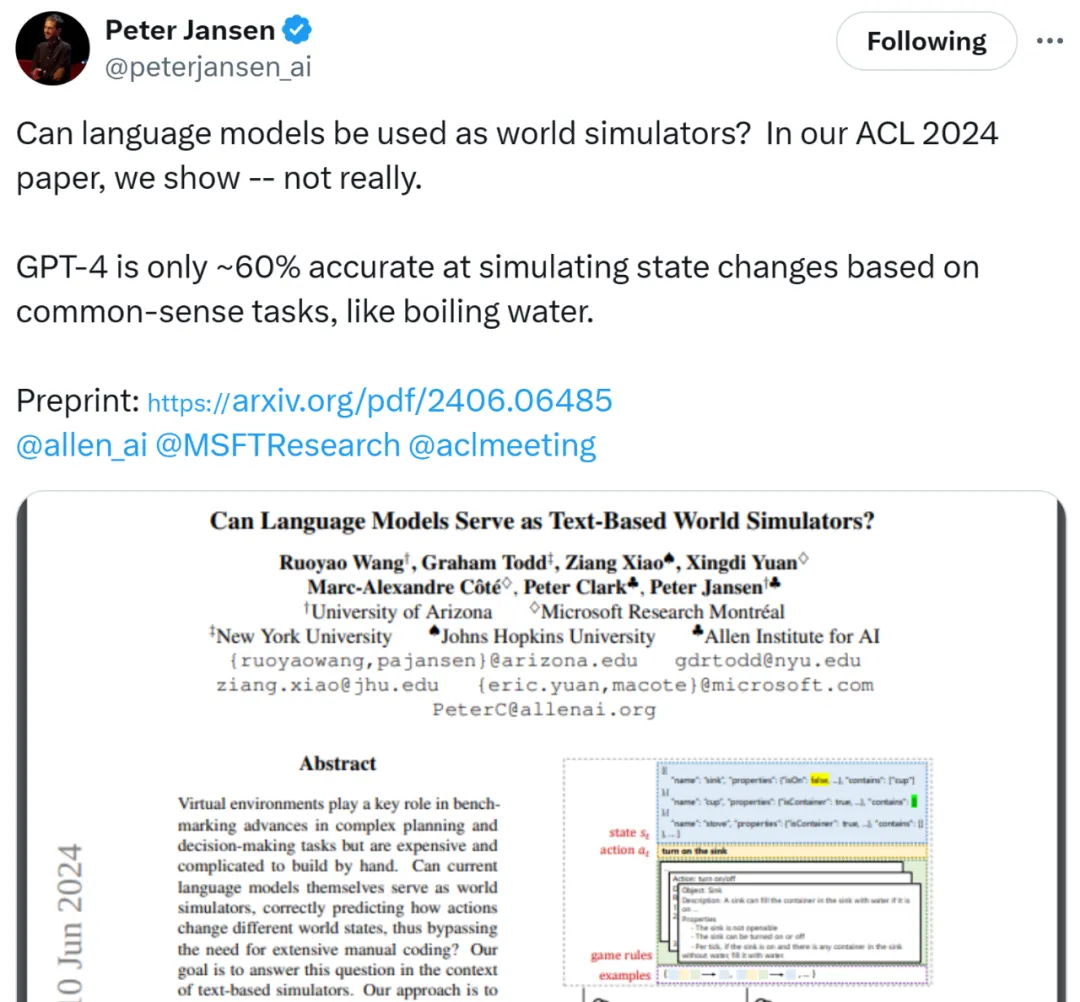
最近两天,一篇入选 ACL 2024 的论文《Can Language Models Serve as Text-Based World Simulators?》在社交媒体 X 上引发了热议,就连图灵奖得主 Yann LeCun 也参与了进来。