AI能接管实验室了?中国科大最新研究给出真实物理世界的压力测试
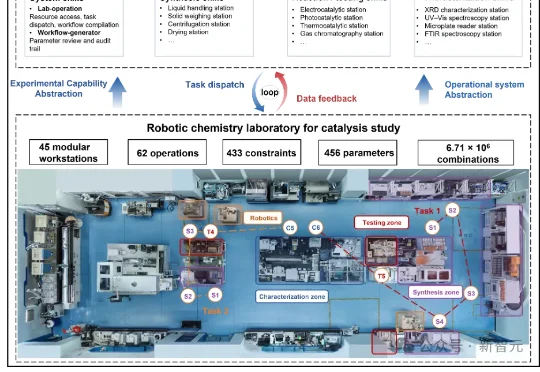
AI能接管实验室了?中国科大最新研究给出真实物理世界的压力测试中国科学技术大学发布的最新研究让AI「大脑」接管机器科学家实验室「身体」,由此将这一问题从知识问答和方案生成,推进到真实物理世界中的实验执行与反馈学习。研究团队搭建了一个机器催化实验室,其中包括45个覆盖合成、表征和催化性能测试的模块化自动工作站。
来自主题: AI技术研报
10575 点击 2026-08-01 10:45

 搜索
中国科学技术大学发布的最新研究让AI「大脑」接管机器科学家实验室「身体」,由此将这一问题从知识问答和方案生成,推进到真实物理世界中的实验执行与反馈学习。研究团队搭建了一个机器催化实验室,其中包括45个覆盖合成、表征和催化性能测试的模块化自动工作站。
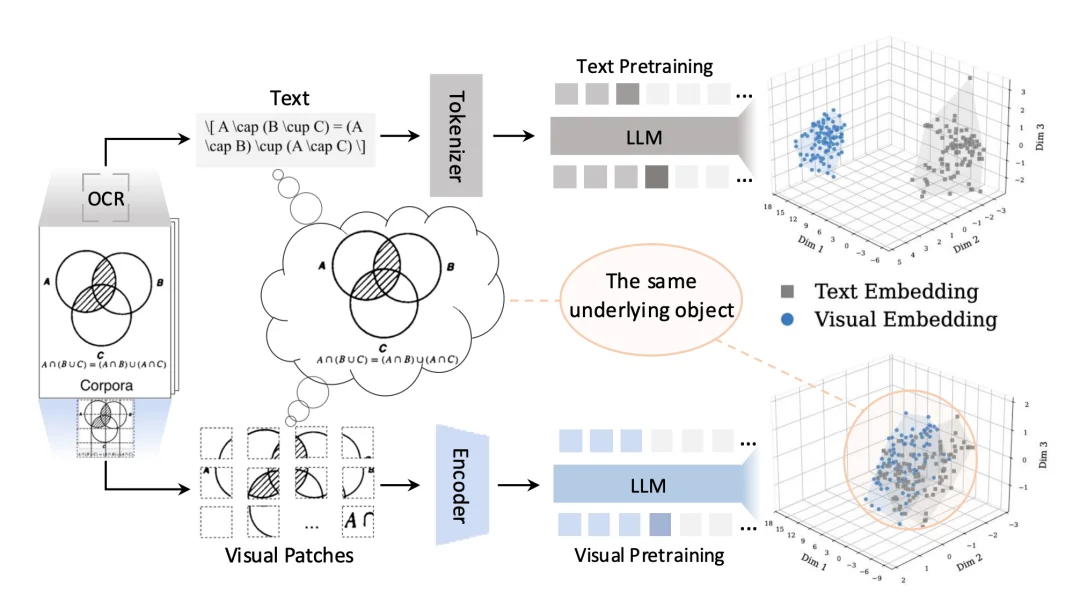
目前,这项技术已成功应用于上海人工智能实验室Intern-S2-Preview 35B/397B系列多模态大模型的预训练中,有效提升了模型的科学推理与多模态理解能力。值得一提的是,相关研发均基于国产昇腾算力平台完成,并成功实现了面向大规模预训练的深度适配与优化。
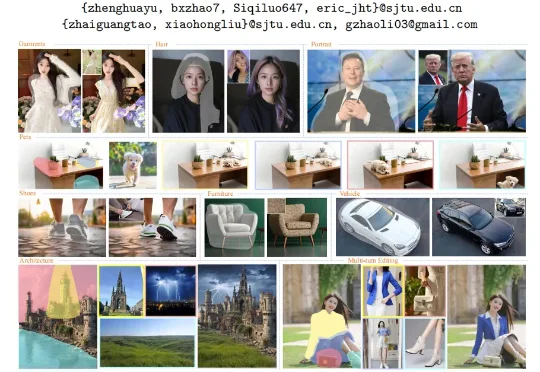
上海交通大学联合上海创智学院团队提出 A²-Edit,它以统一框架支持任意物体类别和任意精度掩码,通过混合 Transformer 专家路由、掩码退火训练及 50 万级多品类数据,让用户只需给出粗略区域,也能完成身份一致、结构完整、自然融合的参考图引导局部编辑。
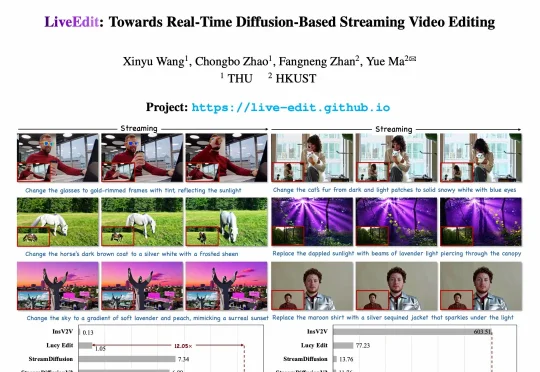
近日,清华大学与香港科技大学的研究团队提出 LiveEdit,一种面向通用文本指令的实时流式视频编辑框架。该方法以因果、分块的方式处理持续到来的视频,在 4 步 / 视频块的推理条件下实现 12.66 FPS 的流式编辑,并能保持被编辑区域的准确性以及未编辑区域的一致性。
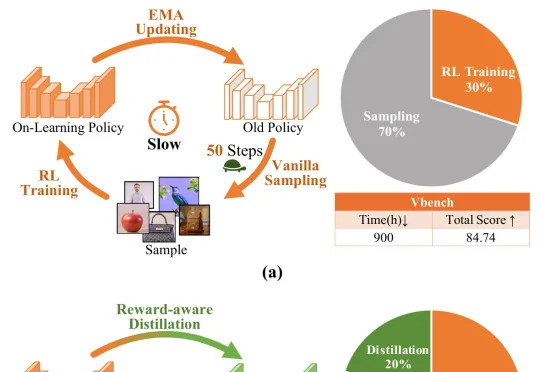
过去的 Diffusion RL 多聚焦于奖励设计与优化算法,训练时的采样成本被忽视。DMSampler 指出:在在线 RL 中,限制规模化的不只是奖励信号或优化器,很多时候是 rollout 本身太贵。
今日,华为开源基于昇腾NPU训练的盘古MoE模型openPangu-2.0-Pro。该模型是openPangu-2.0系列的最新开源模型,总参数规模5050亿,激活参数规模180亿,支持512K上下文长度,训练数据总量约34T tokens。另一轻量化模型openPangu-2.0-Flash已于6月12日开源,参数92亿,其中6亿为激活参数。
我们整理了最近半年来 OpenCode CEO Jay V 以及联合创始人 Dax Raad 近期在多档播客和访谈中的核心观点,试图还原一个完整的图景,一家开源公司究竟如何在巨头夹缝中找到自己的位置,以及他们怎么看待商业化和模型编排。
就在刚刚,字节跳动正式发布了自研视频模型Seedance 2.5,而我们熟悉的「即梦AI」作为模型的官方体验入口也第一时间妥妥接入。贴心的我呢,也直接帮友友们把这次新模型最夯夯夯夯的能力都扒好了,咱先一睹为快——
今天,Thinking Machines正式发布第二款重磅模型——Inkling-Small。276B总参数、12B激活参数,原生多模态,100万token上下文。半个月前,首个开源975B Inkling登场,曾在AI圈掀起了巨浪。
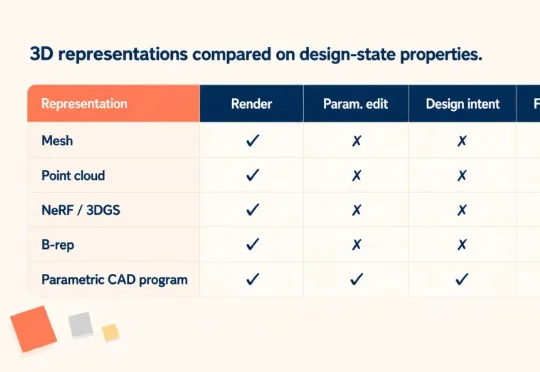
近日,比特无限发布的 Arko-T,是一款面向 Text-to-Structured 3D Generation 的 4B 参数基础模型。该模型由比特无限联创、首席科学家周平义博士带队完成。它接收自然语言描述,直接输出可执行的 Build123d 程序。程序经过 CAD 内核运行后,可以得到带有命名参数、结构特征和建模过程的 CAD 设计实体。