树搜索也存在「过思考」与「欠思考」?腾讯AI Lab与厦大联合提出高效树搜索框架
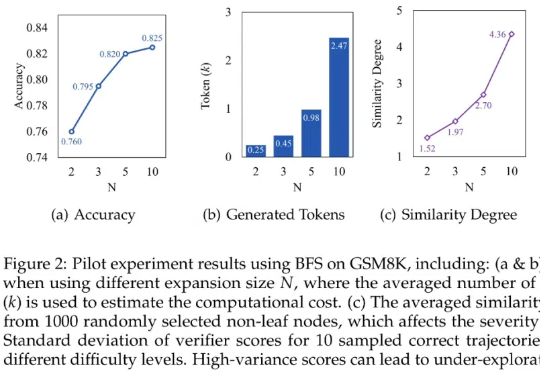
树搜索也存在「过思考」与「欠思考」?腾讯AI Lab与厦大联合提出高效树搜索框架本文探讨基于树搜索的大语言模型推理过程中存在的「过思考」与「欠思考」问题,并提出高效树搜索框架——Fetch。本研究由腾讯 AI Lab 与厦门大学、苏州大学研究团队合作完成。
来自主题: AI技术研报
6854 点击 2025-03-22 11:06

 搜索
本文探讨基于树搜索的大语言模型推理过程中存在的「过思考」与「欠思考」问题,并提出高效树搜索框架——Fetch。本研究由腾讯 AI Lab 与厦门大学、苏州大学研究团队合作完成。
只要微调模型生成的前8-32个词,就能让大模型推理能力达到和传统监督训练一样的水平?
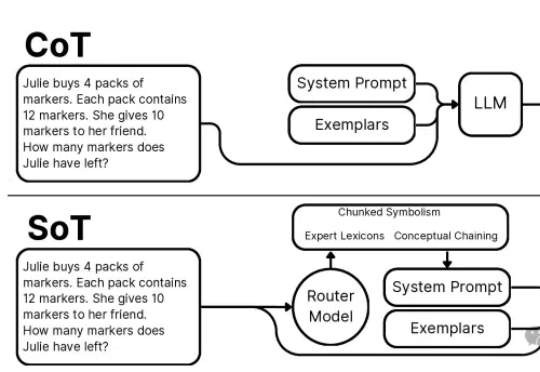
本文介绍了一项突破性的AI推理技术创新——思维草图(SoT)框架。该框架从人类认知过程中获取灵感,通过一个200M大小的路由模型将LLM引导到概念链、分块符号化和专家词汇三种推理范式,巧妙地解决了大语言模型推理过程中的效率瓶颈。
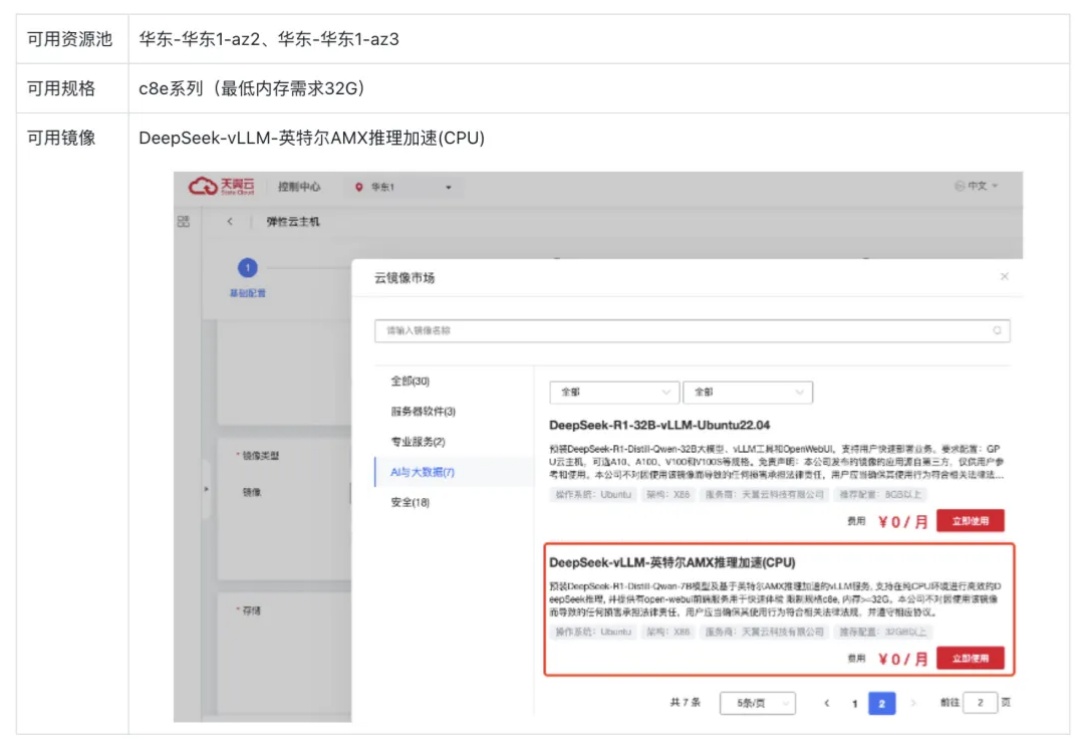
本文介绍了英特尔®至强®处理器在AI推理领域的优势,如何使用一键部署的镜像进行纯CPU环境下基于AMX加速后的DeepSeek-R1 7B蒸馏模型推理,以及纯CPU环境下部署DeepSeek-R1 671B满血版模型实践。

国际可重构计算领域顶级会议 ——FPGA 2025 在落幕之时传来消息,今年的最佳论文颁发给了无问芯穹和上交、清华共同提出的视频生成大模型推理 IP 工作 FlightVGM,这是 FPGA 会议首次将该奖项授予完全由中国大陆科研团队主导的研究工作,同时也是亚太国家团队首次获此殊荣。
强化学习训练数据越多,模型推理能力就越强?新研究提出LIM方法,揭示提升推理能力的关键在于优化数据质量,而不是数据规模。该方法在小模型上优势尽显。从此,强化学习Scaling Law可能要被改写了!
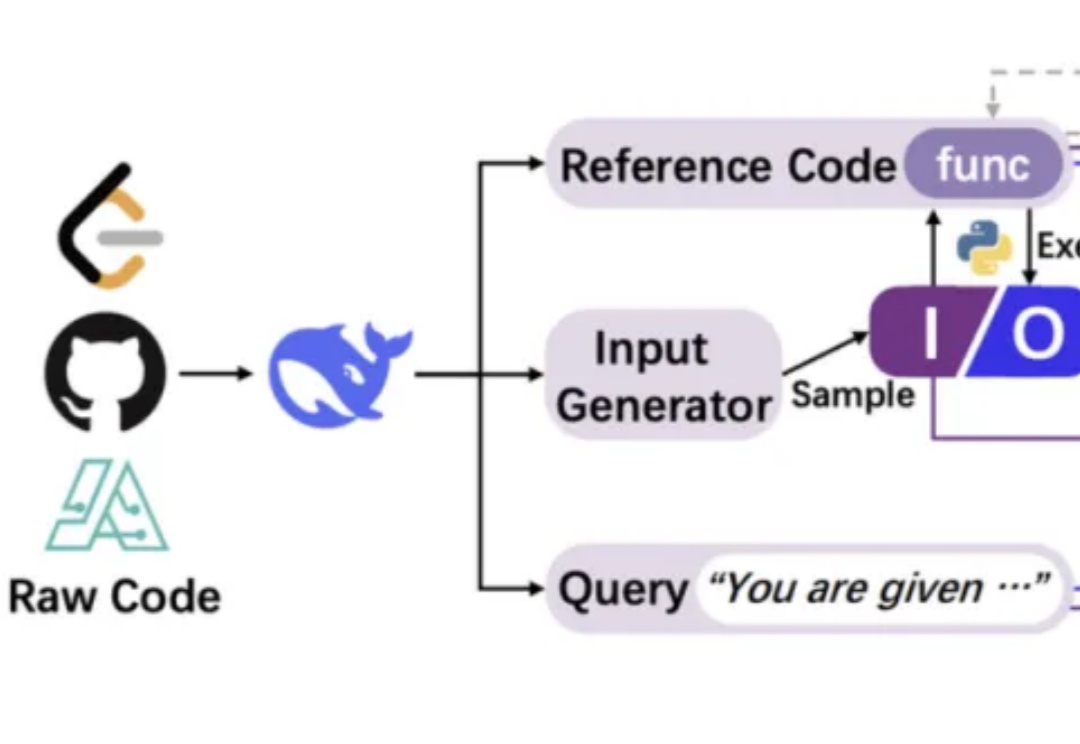
用代码训练大模型思考,其他方面的推理能力也能提升。
最新大语言模型推理测试引众议,DeepSeek R1常常在提供错误答案前就“我放弃”了?? Cursor刚刚参与了一项研究,他们基于NPR周日谜题挑战(The Sunday Puzzle),构建了一个包含近600个问题新基准测试。
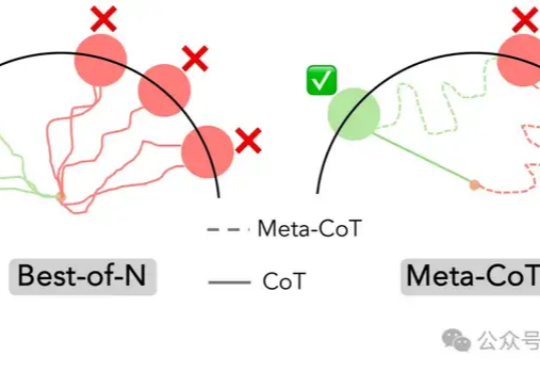
o1背后的推理原理,斯坦福和伯克利帮我们总结好了!
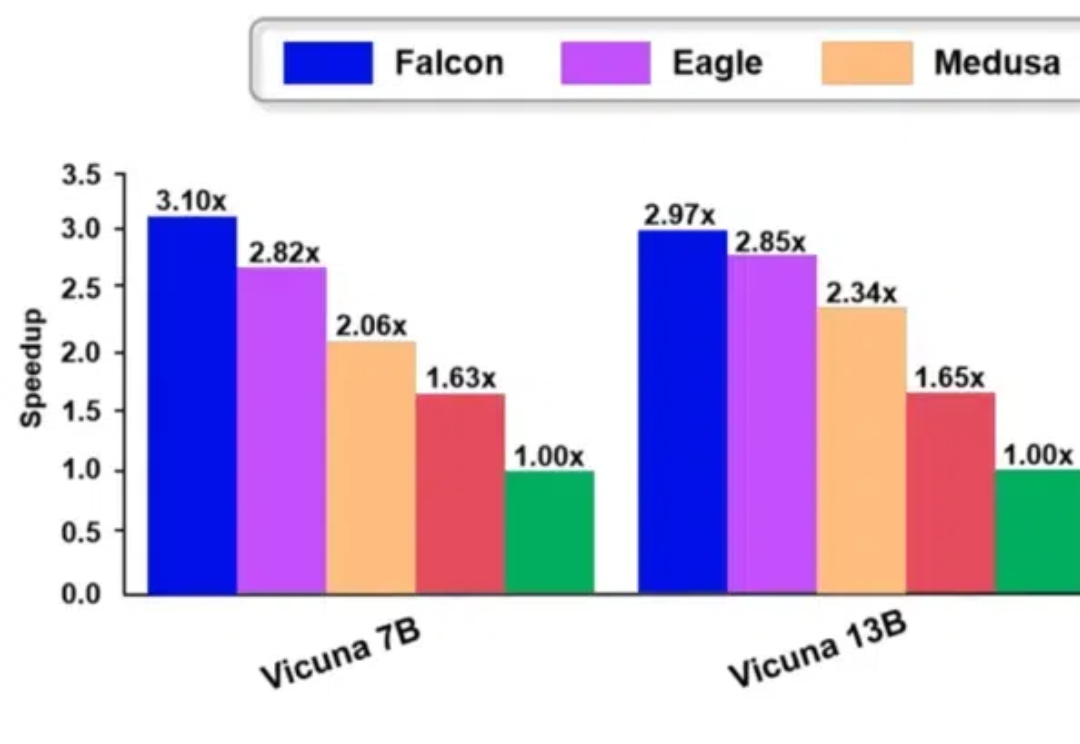
Falcon 方法是一种增强半自回归投机解码框架,旨在增强 draft model 的并行性和输出质量,以有效提升大模型的推理速度。Falcon 可以实现约 2.91-3.51 倍的加速比,在多种数据集上获得了很好的结果,并已应用到翼支付多个实际业务中。