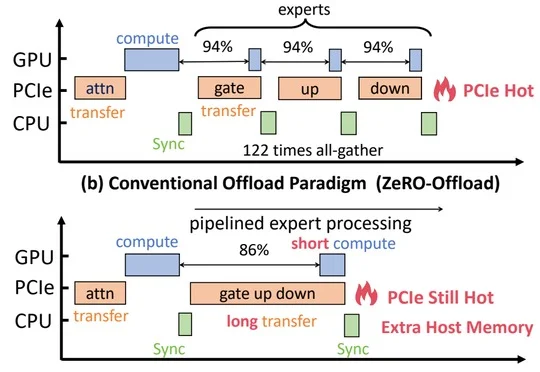
别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算
别再让计算等着搬权重了!KTransformers让CPU直接参与MoE微调计算清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
来自主题: AI技术研报
10790 点击 2026-10-17 11:56

 搜索
清华大学MADSys实验室与趋境科技主导提出开源KTransformers-FineTune(KT-FT),让CPU直接参与MoE专家计算并优化布局与线程调度,使LoRA微调吞吐达到传统卸载范式的2.5~21.2倍。
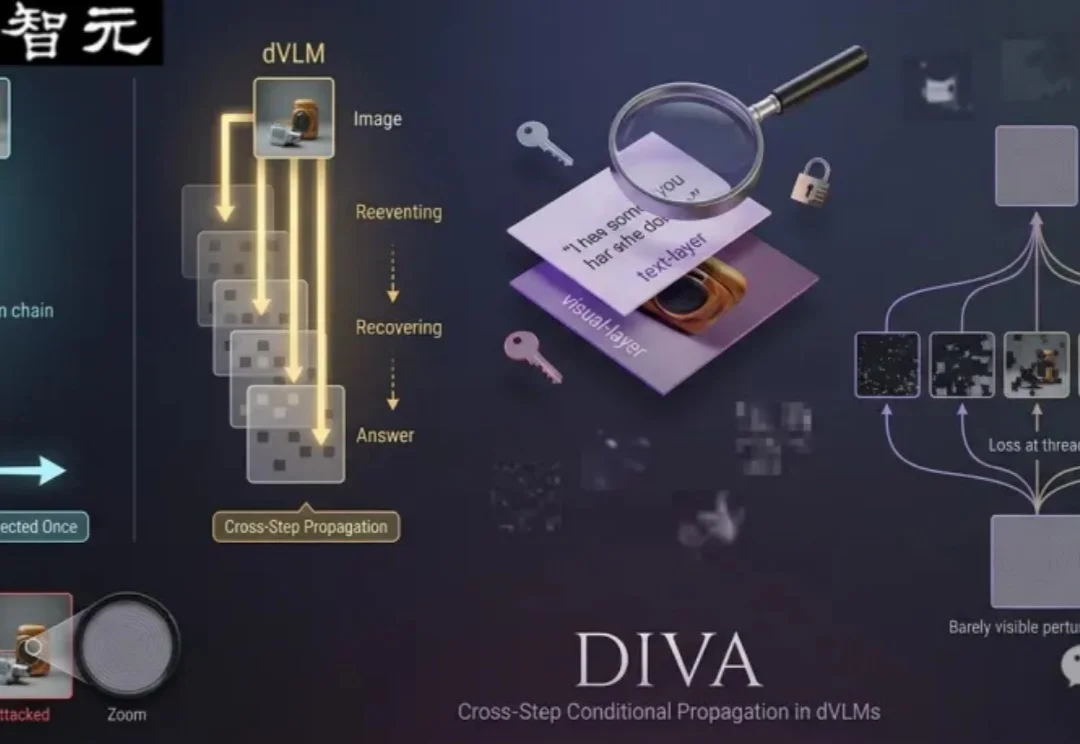
视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。
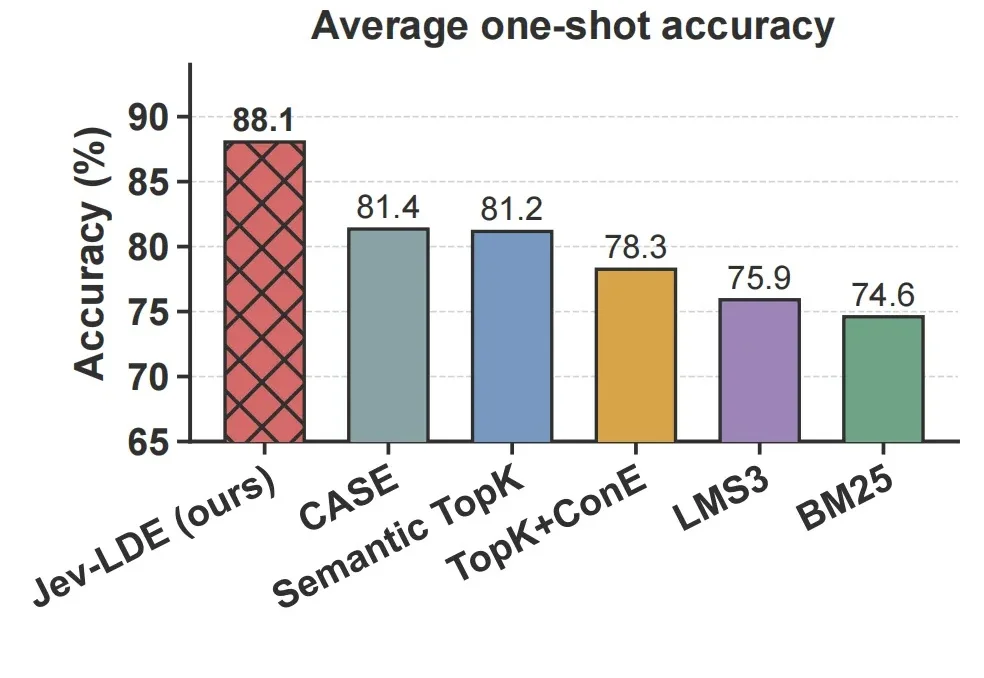
大模型做 In-Context Learning(ICL,上下文学习)时,通常会先从示例库里检索若干 demonstration,再把这些示例和当前问题一起放进 prompt。
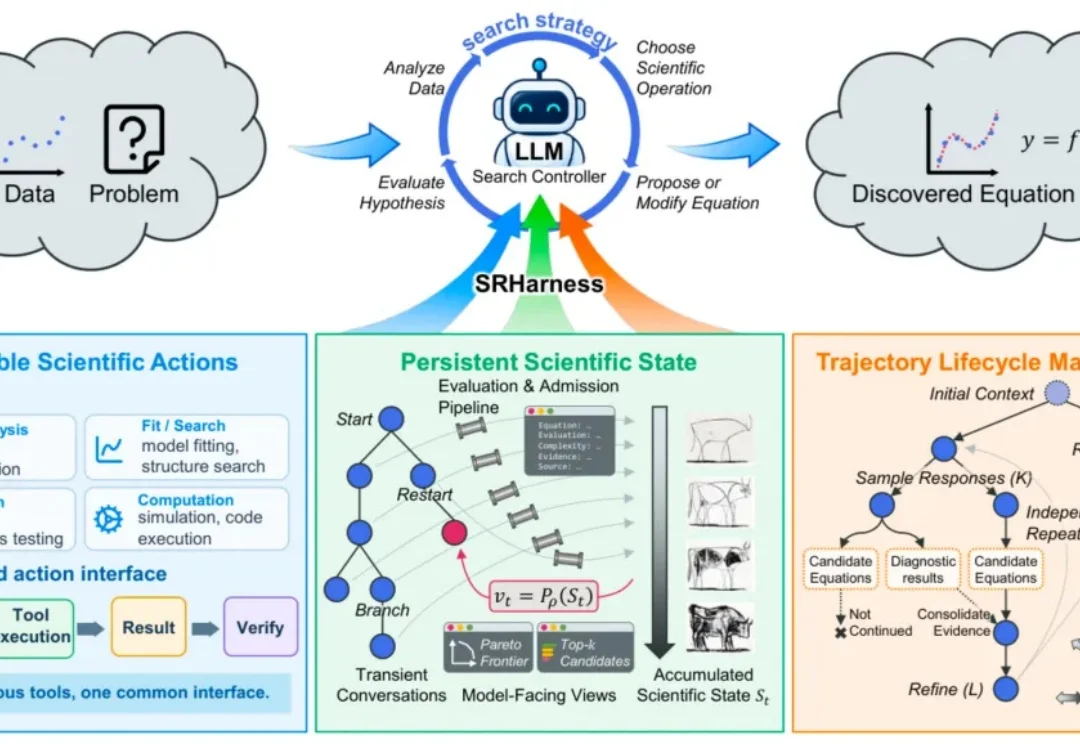
近日,清华大学电子工程系数据科学与智能实验室在 AI for Science 方向提出面向智能体符号回归(agentic symbolic regression)的运行时框架 SRHarness [1],让 AI 更可靠地从观测数据中发现公式;同时构建机制发现基准 MechBench [2],系统评测 AI 能否进一步揭示公式背后的机理。
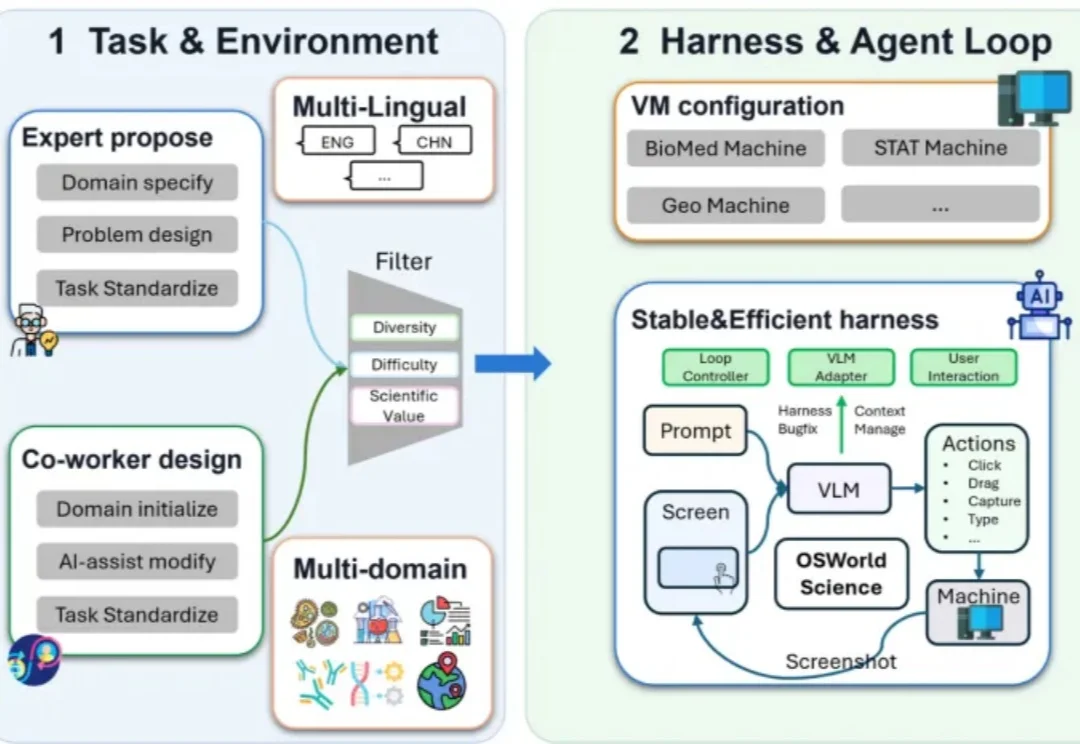
一道科学问题,AI 可以给出解释,列出步骤,甚至写出分析代码。
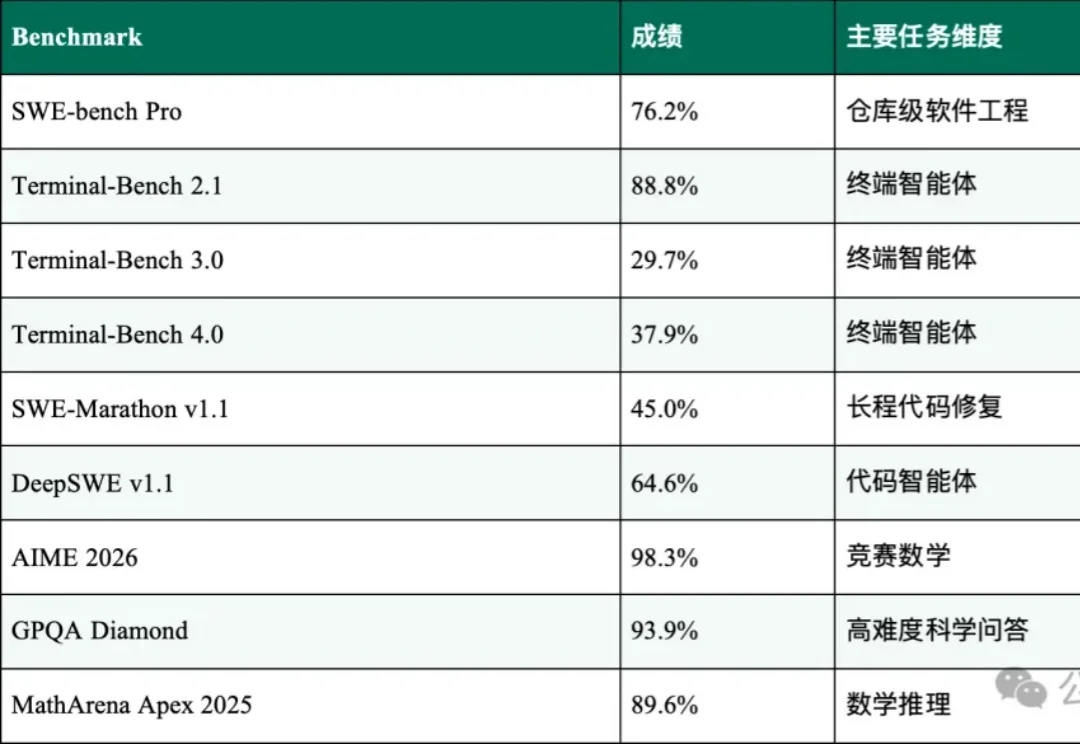
随着前沿模型进入长链推理、工具调用、代码修复与科研任务,一个关键缺口随之显现:模型不断生成和修改候选,但“新状态是否真的更可靠”不能只由模型自己判断。
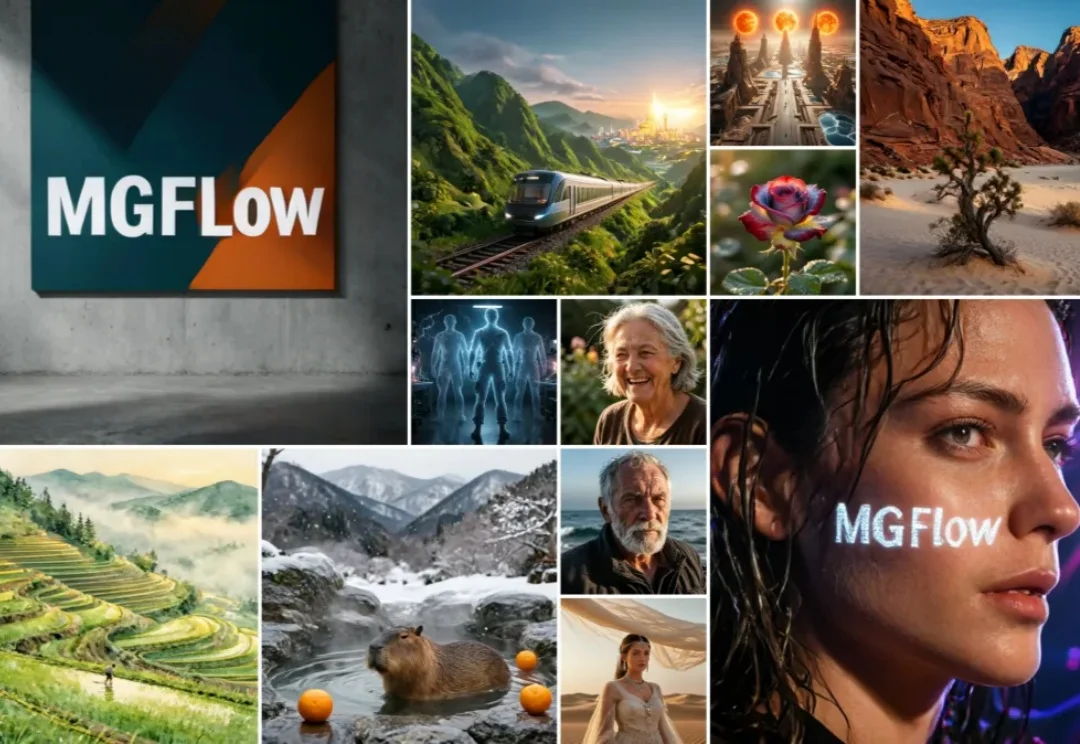
对着屏幕说一句 “向左转”,画面随即展开新的视野;调整角色的动作,场景紧接着给出反馈。多模态交互要求视觉生成跟上人的操作,而漫长的等待会打断整个体验。
阶跃星辰新出的 Step 5 Preview,我前前后后测了一圈
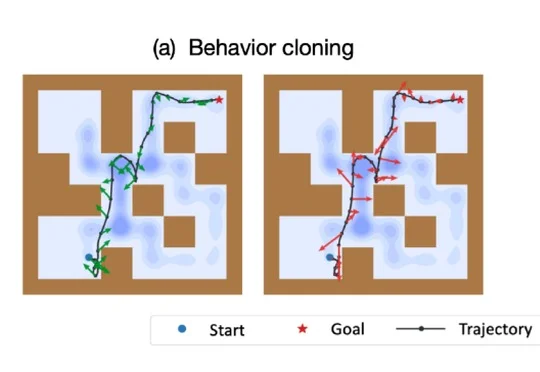
清华大学智能产业研究院(AIR)的一项NeurIPS 2026录用工作提出高阶动作监督,无需改动策略网络即可约束动作的一阶时序变化,并在OGBench及约1%数据的D4RL实验中提升小样本性能与动作平滑性。
好家伙,世界动作模型(WAM)赛道,中国团队直接冲到了全球第一?!