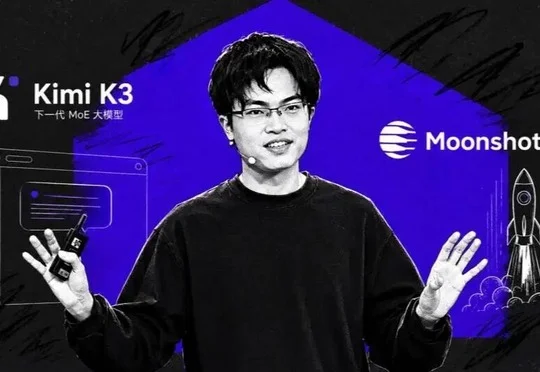
Kimi商业和模型都想要,但卡是有限的
Kimi商业和模型都想要,但卡是有限的月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。
来自主题: AI资讯
8444 点击 2026-10-26 10:23

 搜索
月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。
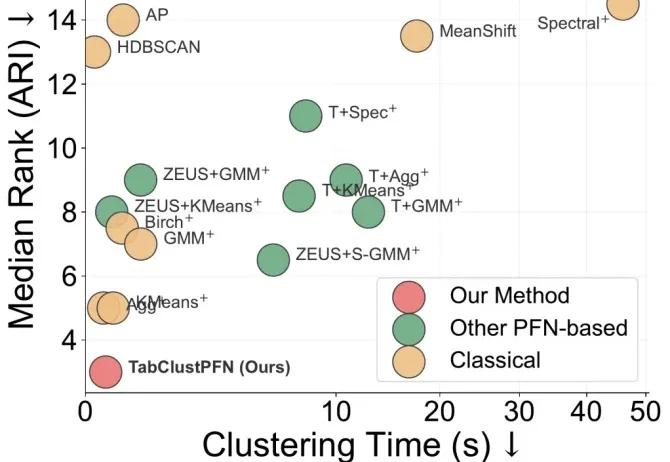
拿到一张没有标签的表格,能不能直接找出其中的群体,还知道模型对 “分几组” 有多大把握?TabClustPFN 尝试用预训练后的单次前向推断,缩短从数据到分组结果的距离。
机器人领域已经轰轰烈烈地 Scaling 了好几年。
OpenAI披露其前沿模型在“假互联网”离线环境中训练,内部模型曾借DNS访问外部聊天机器人,两个隔离AI还利用同一实体机器的CPU缓存互通,OpenAI称已修补问题并加强监控。
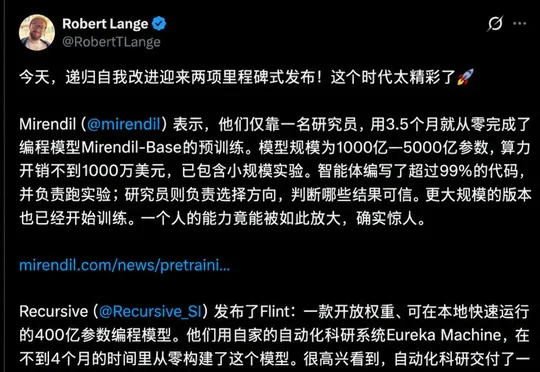
Mirendil宣布由1名研究员借助AI智能体训练出100B–500B参数编程基座模型Mirendil-Base,Recursive发布40B模型Flint及Eureka Machine,英伟达研究员Ali Hatamizadeh提出RSI时代研究者应强化判断力与基础能力的四大生存法则。
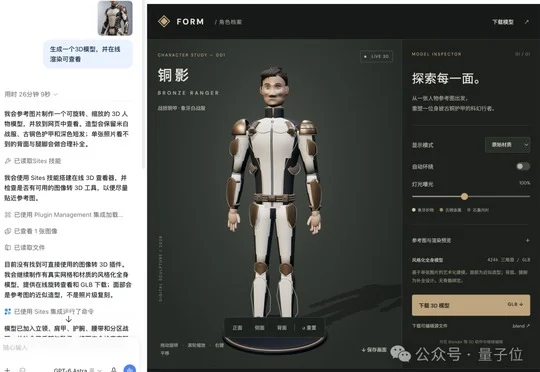
Hi3D正式开放V1.0模型代码,这款基于Sparc3D、约用200万个3D资产训练的国产可商用模型支持研究与部署,最新V3.0达到2048³分辨率并由Hi3D Agent用于3D创作。
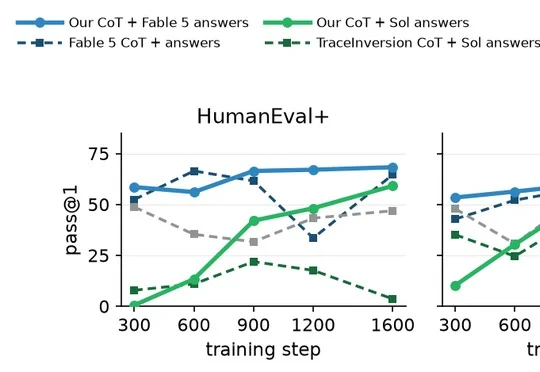
王琰在 TraceForge 技术报告中提出用同族模型合成原生思维链,在 Qwen3.5-9B-Base 实验中超过直接蒸馏 Claude Fable 5 思维链的方案,动摇闭源模型以隐藏思维链构筑的能力护城河。
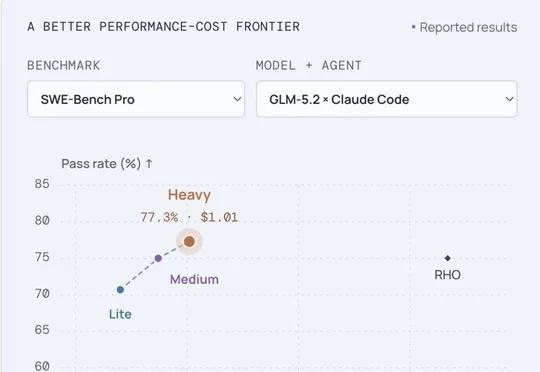
智谱唐杰团队发布并开源无标签递归自我改进框架HarnessPro,在SWE-Bench Pro等基准提升通过率的同时,将单任务平均成本降低53.0%。
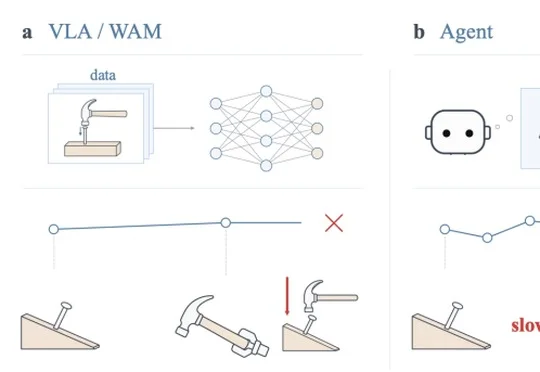
复旦大学可信具身智能研究院团队提出具身自进化框架RoboSkill,通过触觉反馈确认物理状态并积累、复用含代码的Skill,减少机器人Agent重复探索与推理,缩短任务执行时间。
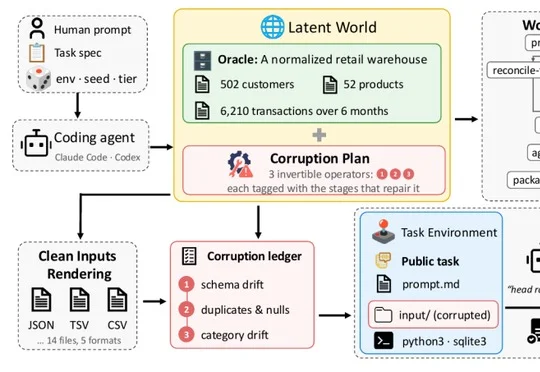
Adobe Research与UCLA提出Tev,构建含1170个环境、覆盖7个领域的Tev-Gym并提出进度势能奖励塑形(PPRS),训练出的Tev-27B在ALE-CM的Pass@5达0.28,与GPT-6 Astra、Claude Opus 5持平。